 GoSuda
Schnelle isolierte Docker-Umgebungen für AI-Agent-RL-Rollouts mit gvx

Der Sicherheits- und Infrastrukturengpass bei RL-Rollouts von Coding-Agenten
Das Training und die Evaluierung von Software-Engineering-Agenten über Benchmarks und Reinforcement-Learning-(RL)-Frameworks wie SWE-bench, SWE-ReX, R2E-Gym, SWE-Gym, Verl und OpenHands erfordern die Ausführung Tausender gleichzeitiger Rollouts von nicht vertrauenswürdigem, durch LLMs generiertem Code. Bei realen Software-Engineering-Aufgaben bearbeitet ein Agent nicht lediglich Textdateien: Er führt docker build aus, startet Datenbanken und Microservices über docker compose, führt Integrationstestsuiten aus und untersucht Container-Logs.
Im Rollout-Maßstab (128 bis 1.024 gleichzeitige Episoden pro Cluster) stößt die bestehende Container-Infrastruktur auf vier systemische Sicherheits- und Leistungsengpässe:
- Lock-Konkurrenz und Zustandslecks des Host-
dockerd: Wenn Hunderte gleichzeitige RL-Worker auf einen einzigen Host-/var/run/docker.sockverweisen, erhält jeder Agent Root-äquivalenten Zugriff auf den Host-Daemon, die Extraktion von Image-Layern wird serialisiert, die Subnetz-Zuweisungen vondocker0erschöpfen sich, es treten Fehler vom TypAnother app is currently holding the xtables lockin der Host-iptablesauf, und es entstehen verwaiste Container über Episoden hinweg. - Ausbruchsrisiko aus privilegierten DinD-Containern: Die Ausführung standardmäßiger
docker:dind-Container erfordert--privileged(CAP_SYS_ADMIN), wodurch nicht vertrauenswürdige RL-Rollouts Zugriff auf rohe Host-Blockgeräte, cgroup-Release-Agents und Kernelmodule erhalten. - Einschränkungen der Hardwarevirtualisierung (
/dev/kvm): MicroVM-Laufzeitumgebungen (Firecracker,QEMU,Kata Containers) isolieren den inneren Kernel sauber, benötigen jedoch/dev/kvm. Standard-Kubernetes-Pods ohne verschachtelte Virtualisierung, Bare-Metal-Cloud-Instanzen, auf denen KVM deaktiviert ist, und bestehendegVisor-(runsc)-Sandboxes können keine KVM-MicroVMs starten. - Hohe Latenz beim Zurücksetzen der Episode (
env.reset()): Das Starten einer frischendocker:dind-Umgebung sowie das Abrufen oder Entpacken von Basis-Images für jede RL-Episode dauert 10 bis 60 Sekunden, wodurch GPU-Trainingsworker während der Umgebungsrücksetzungen untätig bleiben.
gvx (rungv-CLI und z.gfire.dev/gvx/pkg/gvx-Go-SDK) stellt eine sichere, aufwandsarme und token-effiziente Rollout-Laufzeitumgebung bereit, die alle vier Engpässe behebt. Jede Rollout-Umgebung läuft als einzelner, unprivilegierter, selbst gesperrter Benutzerraum-Prozess (isoliert durch den gVisor-Sentry-Kernel von Google, pkg/hostlockdown und einen im Speicher gehaltenen netstack), dessen gesamter /var/lib/docker-Zustand sich in einer einzigen Copy-on-Write-.ext4-Datei (ext4lite) befindet.
Aufwandsarme, token-effiziente Ausführung für Agenten: Wenn
docker buildoderdocker composein jeder Episode sofort funktioniert oder vom Agenten in einem einzigen 3-Befehle-Zug überrungvbootstrapped werden kann, verschwenden RL-Rollouts keine Kontextfenster-Token oder Schrittbudgets an die Fehlersuche beiservice docker start-Fehlern durchulimit,iptables-nft-Fehlern oderrunc-pivot_root-Ablehnungen. Jedes Token in der Trajektorie fließt in die Lösung der eigentlichen Software-Engineering-Aufgabe.
Null-Privilegien-Sicherheit für nicht vertrauenswürdige Agenten-Rollouts: Jede
gvx-Episode sperrt ihren eigenen Host-Betriebssystemprozess ab, bevor sie Gast-Code ausführt (PR_SET_NO_NEW_PRIVS+ BPF-seccompunter Linux, Seatbeltdeny defaultunter macOS, Restricted Token + Job Object unter Windows). Selbst wenn ein RL-Agent innerhalb seiner Episodedocker run --privilegedoder destruktiverm -rf /-Befehle ausführt, bleiben diese Operationen strikt auf den Benutzerraum-Sentry-Kernel und die flüchtige.ext4-Volume-Datei dieser Episode beschränkt.
Rollout-Architektur: Parallele unprivilegierte Instanzen + Reflink-Snapshots
In gvx ist jeder Rollout-Worker ein gewöhnlicher, unprivilegierter OS-Prozess mit eigenem gVisor-Sentry-Kernel, eigenem Benutzerraum-netstack (10.0.2.15/24) und eigenem ext4lite-Blockvolume (ep-N.ext4), wobei alle Worker einen schreibgeschützten, inhaltsadressierbaren erofs-OCI-Image-Cache über den Host-Page-Cache teilen.
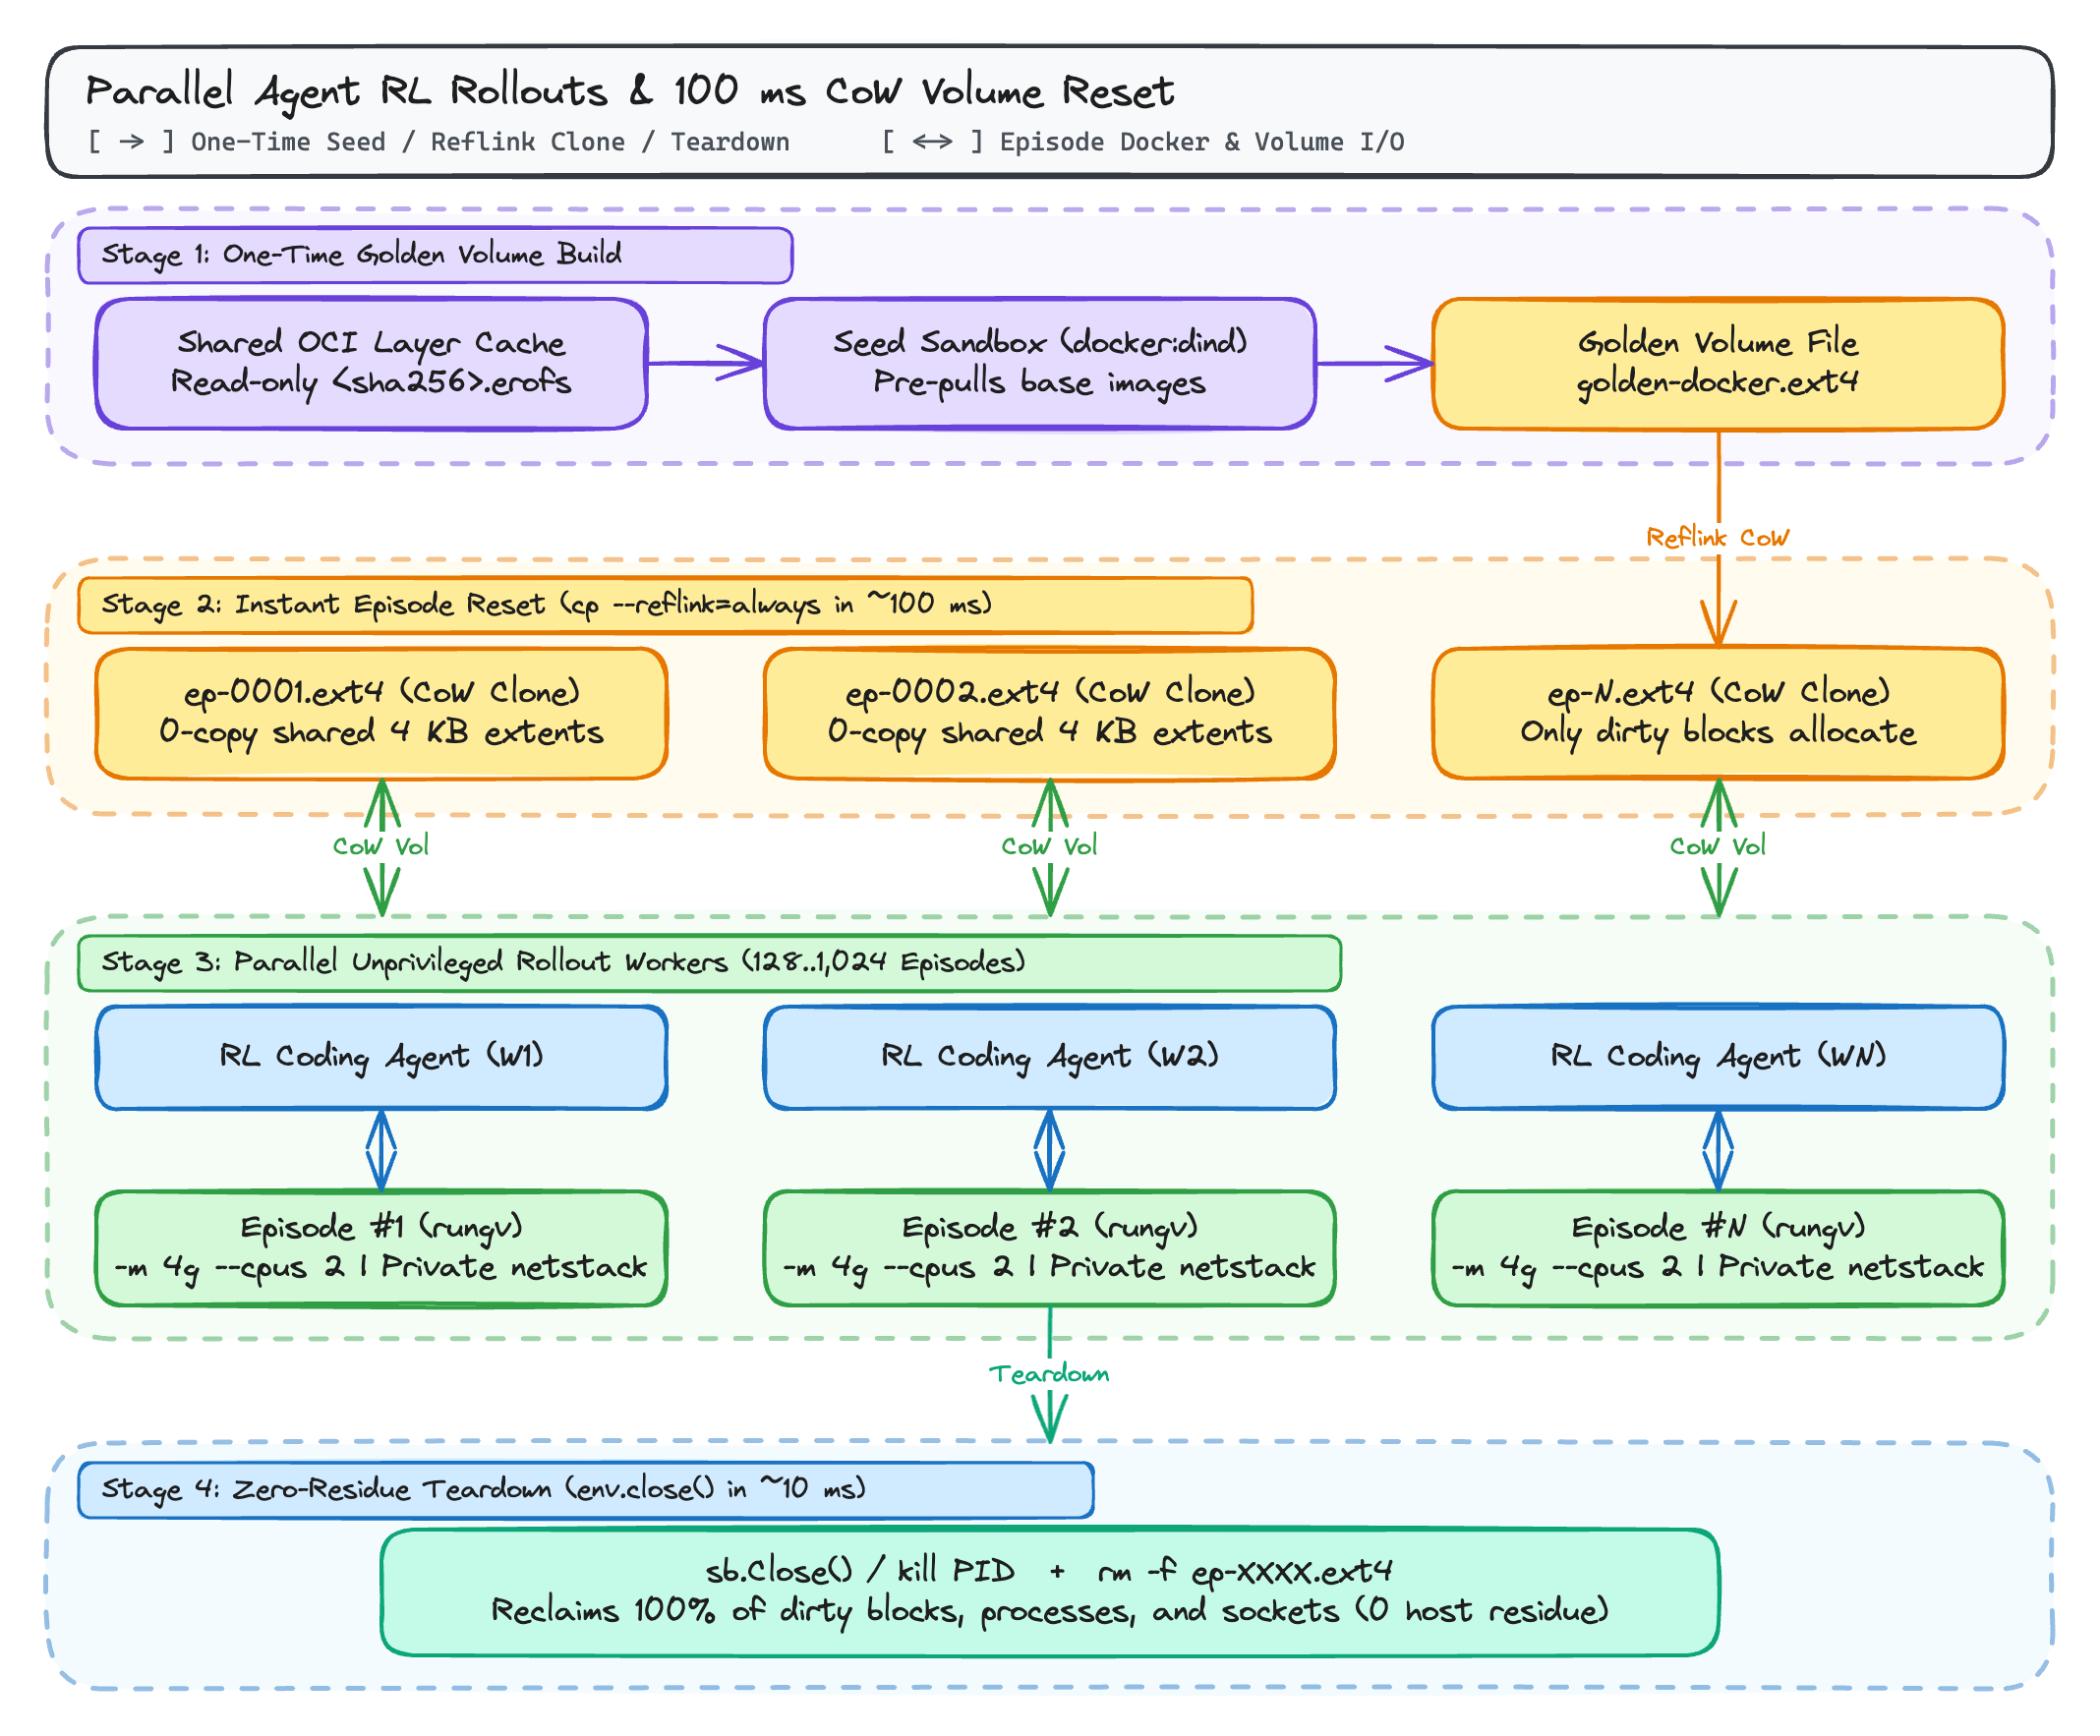
Warum einzelne ext4lite-Volumes die Wirtschaftlichkeit des RL-Resets verändern
Da das ext4lite-Dateisystem ein vollständiges, mit JBD2 journalisiertes ext4-Volume (einschließlich der overlayfs-Layer-Verzeichnisse von Docker, der erweiterten trusted.overlay.*-Attribute, Whiteout-Gerätknoten und Image-Metadaten) in einer einzigen regulären Host-Datei speichert, wird die Verwaltung des Episodenlebenszyklus zu einer einzigen Dateioperation:
- 100-Millisekunden-
env.reset()übercp --reflink=always:- Sie erstellen einmalig eine
golden-docker.ext4-Datei, die vorab gezogene Basis-Images enthält (python:3.11,postgres:16,redis:7oder aufgabenspezifischeSWE-bench-Basis-Images). - Zu Beginn jeder RL-Episode erzeugt
cp --reflink=always golden-docker.ext4 ep-0042.ext4(auf XFS, Btrfs, ZFS oder macOS APFS) einen unabhängigen Copy-on-Write-Klon in weniger als 100 Millisekunden, ohne die zugrunde liegenden Plattenblöcke zu kopieren. - Nur die 4-KiB-Blöcke, die während dieser spezifischen Episode verändert werden, belegen zusätzlichen Speicherplatz.
- Sie erstellen einmalig eine
- Rückstandsfreier Abbau (
env.close()):- Das Beenden des
rungv-Prozesses (sb.Close()in Go) und das Entfernen vonep-0042.ext4gibt sämtliche Prozesse, Netzwerk-Sockets, Mounts und Speicher der Episode in etwa 10 Millisekunden frei. Im Mount-Table des Host-Kernels wird nichts eingehängt, und in den Host-cgroups wird nichts registriert.
- Das Beenden des
Schritt-für-Schritt-Workflow: Golden-.ext4-Snapshot und schnelles Episoden-Reset
Sie können rungv auf jedem Rollout-Worker-Knoten entweder durch Herunterladen der SLSA-attestierten, vorkompilierten Binärdatei aus GitHub Releases (gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml --deny-self-hosted-runners) oder durch Ausführen von CGO_ENABLED=0 go install z.gfire.dev/gvx/cmd/rungv@latest installieren.
Schritt 1: Golden-docker:dind-Volume einmalig erstellen
 1mkdir -p /srv/rl-snapshots /srv/rl-episodes
 2
 3# 1. Eine Seed-docker:dind-Instanz starten, die von golden-docker.ext4 gestützt wird
 4rungv run \
 5  -p unix:/srv/rl-snapshots/seed.sock:2375 \
 6  --mount type=volume,src=/srv/rl-snapshots/golden-docker.ext4,dst=/var/lib/docker \
 7  -e DOCKER_TLS_CERTDIR= \
 8  docker:dind --tls=false &
 9SEED_PID=$!
10
11# 2. Basis-Images und Build-Cache innerhalb von golden-docker.ext4 vorab befüllen
12export DOCKER_HOST="unix:///srv/rl-snapshots/seed.sock"
13until docker info >/dev/null 2>&1; do sleep 0.5; done
14
15docker pull python:3.11-slim
16docker pull redis:7-alpine
17docker pull postgres:16-alpine
18
19# 3. Die Seed-Instanz geordnet beenden, damit ext4lite das Image schreibt und kompaktiert
20kill -INT $SEED_PID
21wait $SEED_PID
Schritt 2: Parallele RL-Episoden in 100 Millisekunden starten
Jeder parallele Rollout-Worker klont golden-docker.ext4 per Reflink und startet eine isolierte docker:dind-Instanz, deren Images bereits in /var/lib/docker vorhanden sind:
 1EPISODE_ID="ep-0042"
 2SOCK="/srv/rl-episodes/${EPISODE_ID}.sock"
 3
 4# Sofortiger Copy-on-Write-Klon (~100 ms auf XFS/Btrfs/APFS)
 5cp --reflink=always \
 6  /srv/rl-snapshots/golden-docker.ext4 \
 7  "/srv/rl-episodes/${EPISODE_ID}.ext4"
 8
 9# Isolierte, unprivilegierte Episode mit 4 GiB RAM und 2 CPUs starten
10rungv run \
11  -m 4g --cpus 2 \
12  -p "unix:${SOCK}:2375" \
13  --mount "type=volume,src=/srv/rl-episodes/${EPISODE_ID}.ext4,dst=/var/lib/docker" \
14  -e DOCKER_TLS_CERTDIR= \
15  docker:dind --tls=false &
16EP_PID=$!
17
18export DOCKER_HOST="unix://${SOCK}"
19until docker info >/dev/null 2>&1; do sleep 0.2; done
20
21# Innerhalb des Rollout-Workers stehen die Images sofort ohne Netzwerk-Pull zur Verfügung
22docker images
23
24# Abbau der Episode nach der Reward-Berechnung (~10 ms)
25kill -KILL $EP_PID
26rm -f "/srv/rl-episodes/${EPISODE_ID}.ext4" "${SOCK}"
Programmatischer Rollout-Pool mit dem Go-SDK z.gfire.dev/gvx/pkg/gvx
Wenn Ihr RL-Umgebungsserver oder Ihr Evaluierungs-Harness in Go geschrieben ist (oder einen Go-Rollout-Daemon über gRPC aufruft), können Sie parallele Container-Episoden direkt über z.gfire.dev/gvx/pkg/gvx verwalten:
 1package main
 2
 3import (
 4	"bytes"
 5	"context"
 6	"fmt"
 7	"log"
 8	"os"
 9	"os/exec"
10	"path/filepath"
11	"time"
12
13	"z.gfire.dev/gvx/pkg/gvx"
14)
15
16func runEpisode(ctx context.Context, goldenExt4, scratchDir string, epID int) error {
17	epExt4 := filepath.Join(scratchDir, fmt.Sprintf("ep-%04d.ext4", epID))
18	defer os.Remove(epExt4)
19
20	// 1. Golden-ext4lite-Volume per Reflink klonen
21	cpCmd := exec.CommandContext(ctx, "cp", "--reflink=always", goldenExt4, epExt4)
22	if err := cpCmd.Run(); err != nil {
23		return fmt.Errorf("clone golden volume: %w", err)
24	}
25
26	// 2. Zeitlimit der Episode auf Wanduhrzeit anwenden
27	epCtx, cancel := context.WithTimeout(ctx, 2*time.Minute)
28	defer cancel()
29
30	var stdout, stderr bytes.Buffer
31	sb, err := gvx.New(epCtx, gvx.Config{
32		Platform:               gvx.PlatformAuto,
33		NetworkMode:            gvx.NetModeNAT,
34		NetRaw:                 true,
35		AllowPacketSocketWrite: true,
36		AllowSUID:              true,
37		OCIImage:               "docker:dind",
38		Entrypoint:             []string{"sh", "-c"},
39		EntrypointSet:          true,
40		Cmd: []string{
41			"dockerd-entrypoint.sh --tls=false >/var/log/dockerd.log 2>&1 & " +
42				"until docker info >/dev/null 2>&1; do sleep 0.2; done && " +
43				"docker run --rm python:3.11-slim python -c 'print(6 * 7)'",
44		},
45		Envv: []string{"DOCKER_TLS_CERTDIR="},
46		Mounts: []gvx.Mount{
47			{
48				Kind:      gvx.MountVolume,
49				ImagePath: epExt4,
50				GuestPath: "/var/lib/docker",
51			},
52		},
53		Resources: gvx.Resources{
54			MemoryBytes: 4 << 30, // Obergrenze 4 GiB
55			CPUMillis:   2000,    // 2,0 CPUs
56		},
57		Stdout: &stdout,
58		Stderr: &stderr,
59	})
60	if err != nil {
61		return fmt.Errorf("init episode %d: %w", epID, err)
62	}
63	defer sb.Close()
64
65	exitCode, err := sb.Run(epCtx)
66	if err != nil {
67		return fmt.Errorf("run episode %d: %w", epID, err)
68	}
69
70	log.Printf("episode %d finished: exit=%d stdout=%q", epID, exitCode, stdout.String())
71	return nil
72}
73
74func main() {
75	ctx := context.Background()
76	if err := runEpisode(ctx, "/srv/rl-snapshots/golden-docker.ext4", "/srv/rl-episodes", 1); err != nil {
77		log.Fatal(err)
78	}
79}
Vergleich von Laufzeitumgebungen für RL-Sandboxes von Agenten
| Metrik / Anforderung | Geteilter Host-dockerd | Privilegiertes docker:dind | Firecracker / KVM-MicroVM | Standard-gVisor (runsc) | gvx (rungv / pkg/gvx) |
|---|---|---|---|---|---|
Host-root oder --privileged erforderlich | Ja (docker.sock = root) | Ja (--privileged) | Benötigt /dev/kvm + TAP-Einrichtung | Ja (oder userns + mount) | Nein (einzelner unprivilegierter Prozess) |
Funktioniert in unprivilegierten K8s-Pods / bestehendem runsc | Nein | Nein | Nein (kein /dev/kvm) | Schlägt fehl (EBUSY bei verschachteltem seccomp) | Ja (automatischer futex-Loop-Fallback) |
Unterstützt inneres docker build & docker compose | Teilt den Host-Daemon | Ja | Ja | Schlägt ohne Host-DinD-Tuning fehl | Ja (overlayfs auf ext4lite) |
| Netzwerkisolation pro Episode | Geteilter docker0 / xtables-Lock | Eigener Namespace | Eigene VM-NIC | Eigener netns | Isoliertes In-Process-netstack |
Latenz beim Warm-Reset der Episode (env.reset()) | 5 s bis 30 s (Container-/Volume-Bereinigung) | 10 s bis 60 s (kalter Daemon) | ~150 ms (VM-Snapshot) | 5 s bis 20 s | ~100 ms (cp --reflink=always .ext4) |
| Plattformübergreifende lokale Entwicklung (Windows / macOS / Linux) | Erfordert eine Linux-VM | Erfordert eine Linux-VM | Nur Linux mit KVM | Nur Linux | Nativ auf Windows, macOS und Linux |
Weiterführende Lektüre in dieser Reihe
- gvx: Linux-Container, Docker und Kubernetes in einem einzigen unprivilegierten Prozess ausführen: Vollständiger architektonischer Überblick über
gvxunter Windows (whpx,systrap), macOS (hvf) und Linux (systrap). - Docker, docker build und docker compose ohne Root oder User Namespaces ausführen: Kurze 3-Schritte-Bootstrap- und Fehlerbehebungsanleitung, wenn
sudo,unshare(CLONE_NEWUSER),mount(2)und/dev/fuseblockiert sind. - Docker-in-Docker innerhalb von gVisor und verschachtelten Sandboxes mit gvx ausführen: Vertiefte Analyse, warum
docker.iound verschachteltesrunscinnerhalb vongVisor(runsc) fehlschlagen und wiegvxbeiEBUSYauf die_RUN_SYSCALL_LOOP-futex-Schleife zurückfällt. - Schnelle isolierte Docker-Umgebungen für RL-Rollouts von KI-Agenten mit gvx (dieser Beitrag)