 GoSuda
Быстрые изолированные среды Docker для проходов RL-агентов ИИ с gvx

Узкое место безопасности и инфраструктуры в RL rollouts для кодирующих агентов
Обучение и оценка агентов разработки программного обеспечения на бенчмарках и в фреймворках обучения с подкреплением (reinforcement learning, RL), таких как SWE-bench, SWE-ReX, R2E-Gym, SWE-Gym, Verl и OpenHands, требует выполнения тысяч параллельных rollouts с недоверенным код, сгенерированным LLM. В реальных задачах разработки программного обеспечения агент не просто редактирует текстовые файлы: он запускает docker build, поднимает базы данных и микросервисы через docker compose, выполняет наборы интеграционных тестов и анализирует логи контейнеров.
При масштабе rollouts (от 128 до 1 024 параллельных эпизодов на кластер) существующая контейнерная инфраструктура сталкивается с четырьмя системными проблемами безопасности и производительности:
- Блокировки и утечка состояния демона
dockerdхоста: Направление сотен параллельных RL-воркеров на один сокет/var/run/docker.sockхоста предоставляет каждому агенту доступ, эквивалентный root, к демону хоста, сериализует извлечение слоёв образов, исчерпывает подсетиdocker0, вызывает ошибкиAnother app is currently holding the xtables lockвiptablesхоста и приводит к утечке осиротевших контейнеров между эпизодами. - Риск выхода из контейнера при использовании привилегированного DinD: Запуск стандартных контейнеров
docker:dindтребует--privileged(CAP_SYS_ADMIN), что открывает недоверенным RL rollouts прямой доступ к блочным устройствам хоста, агентам освобождения cgroup (cgroup release agents) и модулям ядра. - Ограничения аппаратной виртуализации (
/dev/kvm): Среды MicroVM (Firecracker,QEMU,Kata Containers) чисто изолируют внутренние ядра, но требуют/dev/kvm. Стандартные поды Kubernetes без вложенной виртуализации, bare-metal облачные инстансы, где KVM отключён, и существующие песочницыgVisor(runsc) не могут запускать микровиртуальные машины KVM. - Высокая задержка сброса эпизода (
env.reset()): Запуск нового окруженияdocker:dindи загрузка или распаковка базовых образов для каждого RL-эпизода занимает от 10 до 60 секунд, из-за чего GPU-воркеры обучения простаивают в ожидании сброса окружений.
gvx (CLI rungv и Go SDK z.gfire.dev/gvx/pkg/gvx) предоставляет безопасную, простую в использовании и экономную к токенам среду выполнения rollouts, которая устраняет все четыре узких места. Каждое окружение rollout запускается как один непривилегированный самоблокирующийся процесс пользовательского пространства (изолированный ядром Sentry из gVisor от Google, pkg/hostlockdown и встроенным в память netstack), состояние /var/lib/docker которого целиком хранится внутри одного файла .ext4 с копированием при записи (ext4lite).
Простое в использовании выполнение для агентов с экономией токенов: Когда
docker buildилиdocker composeработает без дополнительной настройки в каждом эпизоде (или может быть инициализирован агентом за один ход из трёх команд черезrungv), RL rollouts не тратят токены контекстного окна и бюджеты шагов на устранение неполадок сservice docker start, ошибкамиulimit, ошибкамиiptables-nftили отказамиruncприpivot_root. Каждый токен траектории направлен на решение реальной задачи разработки программного обеспечения.
Нулевые привилегии для безопасности недоверенных rollouts агентов: Каждый эпизод
gvxблокирует собственный процесс хостовой ОС до запуска гостевого кода (PR_SET_NO_NEW_PRIVSи BPFseccompв Linux,deny defaultв Seatbelt в macOS, Restricted Token и Job Object в Windows). Даже если RL-агент выполнитdocker run --privilegedили деструктивную командуrm -rf /внутри своего эпизода, эти операции остаются строго ограниченными пользовательским ядром Sentry этого эпизода и его эфемерным файлом тома.ext4.
Архитектура rollout: параллельные непривилегированные экземпляры и снимки reflink
В gvx каждый воркер rollout представляет собой обычный непривилегированный процесс ОС со своим ядром gVisor Sentry, собственным сетевым стеком пользовательского пространства netstack (10.0.2.15/24) и собственным блочным томом ext4lite (ep-N.ext4), при этом все воркеры используют общий кэш OCI-образов erofs только для чтения, разделяемый через кэш страниц хоста.
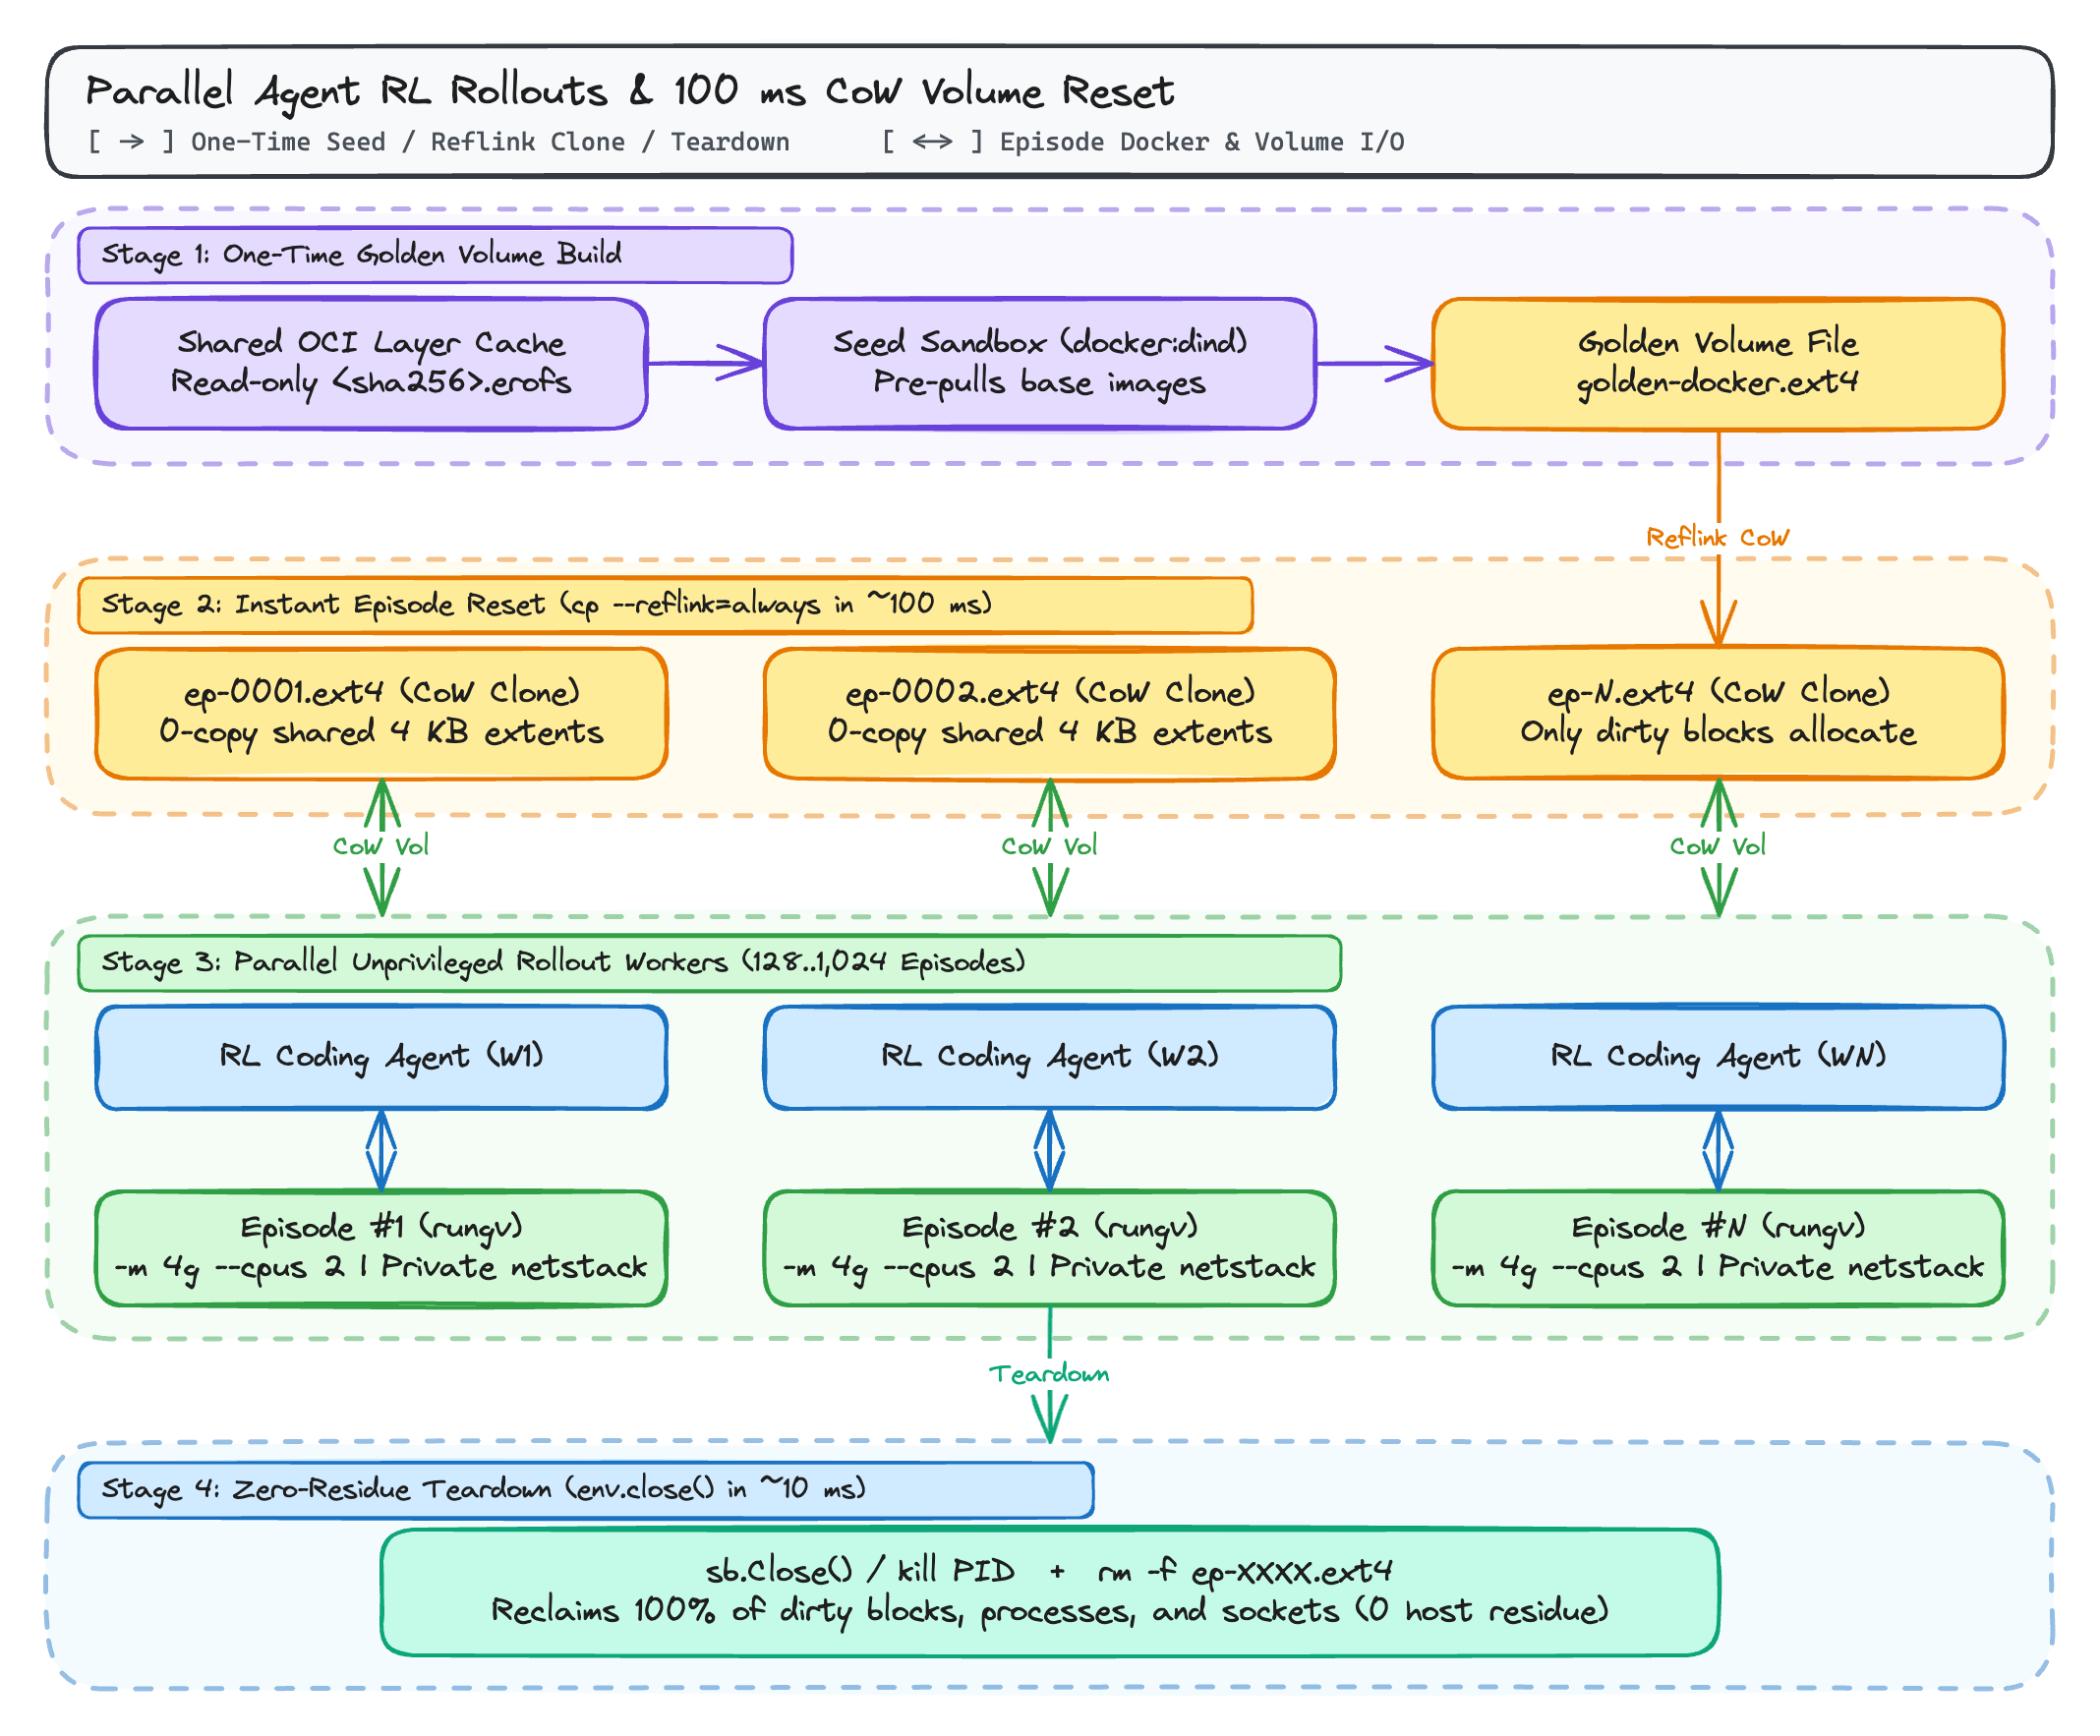
Почему тома ext4lite в одном файле меняют экономику сброса RL
Поскольку файловая система ext4lite хранит весь том ext4 с журналом JBD2 (включая каталоги слоёв overlayfs Docker, расширенные атрибуты trusted.overlay.*, узлы устройств whiteout и метаданные образов) внутри одного обычного файла хоста, управление жизненным циклом эпизода сводится к одной файловой операции:
- Сброс
env.reset()за 100 миллисекунд черезcp --reflink=always:- Однократно создаётся файл
golden-docker.ext4, содержащий предварительно загруженные базовые образы (python:3.11,postgres:16,redis:7или базовые образыSWE-bench, специфичные для задачи). - В начале каждого RL-эпизода команда
cp --reflink=always golden-docker.ext4 ep-0042.ext4(в XFS, Btrfs, ZFS или macOS APFS) создаёт независимый клон с копированием при записи менее чем за 100 миллисекунд, не копируя базовые блоки диска. - Дополнительное место на диске занимают только блоки размером 4 КиБ, изменённые в ходе конкретного эпизода.
- Однократно создаётся файл
- Очистка без остатков (
env.close()):- Завершение процесса
rungv(sb.Close()в Go) и удалениеep-0042.ext4освобождают 100% процессов, сетевых сокетов, точек монтирования и хранилища эпизода примерно за 10 миллисекунд. Ничто никогда не монтируется в таблицу монтирования ядра хоста и не регистрируется в cgroups хоста.
- Завершение процесса
Пошаговый процесс: золотой снимок .ext4 и быстрый сброс эпизода
Вы можете установить rungv на каждом узле воркеров rollout либо загрузив подписанный SLSA предварительно собранный бинарный файл из GitHub Releases (gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml --deny-self-hosted-runners), либо выполнив CGO_ENABLED=0 go install z.gfire.dev/gvx/cmd/rungv@latest.
Шаг 1: однократно создайте золотой том docker:dind
 1mkdir -p /srv/rl-snapshots /srv/rl-episodes
 2
 3# 1. Запустите исходный экземпляр docker:dind, использующий golden-docker.ext4
 4rungv run \
 5  -p unix:/srv/rl-snapshots/seed.sock:2375 \
 6  --mount type=volume,src=/srv/rl-snapshots/golden-docker.ext4,dst=/var/lib/docker \
 7  -e DOCKER_TLS_CERTDIR= \
 8  docker:dind --tls=false &
 9SEED_PID=$!
10
11# 2. Предварительно загрузите базовые образы и кэш сборки внутри golden-docker.ext4
12export DOCKER_HOST="unix:///srv/rl-snapshots/seed.sock"
13until docker info >/dev/null 2>&1; do sleep 0.5; done
14
15docker pull python:3.11-slim
16docker pull redis:7-alpine
17docker pull postgres:16-alpine
18
19# 3. Корректно остановите исходный экземпляр, чтобы ext4lite сбросил данные на диск и уплотнил образ
20kill -INT $SEED_PID
21wait $SEED_PID
Шаг 2: запуск параллельных RL-эпизодов за 100 миллисекунд
Каждый параллельный воркер rollout клонирует golden-docker.ext4 через reflink и запускает изолированный экземпляр docker:dind со всеми уже присутствующими в /var/lib/docker образами:
 1EPISODE_ID="ep-0042"
 2SOCK="/srv/rl-episodes/${EPISODE_ID}.sock"
 3
 4# Мгновенный клон с копированием при записи (~100 мс на XFS/Btrfs/APFS)
 5cp --reflink=always \
 6  /srv/rl-snapshots/golden-docker.ext4 \
 7  "/srv/rl-episodes/${EPISODE_ID}.ext4"
 8
 9# Запуск изолированного непривилегированного эпизода с 4 ГиБ ОЗУ и 2 ЦП
10rungv run \
11  -m 4g --cpus 2 \
12  -p "unix:${SOCK}:2375" \
13  --mount "type=volume,src=/srv/rl-episodes/${EPISODE_ID}.ext4,dst=/var/lib/docker" \
14  -e DOCKER_TLS_CERTDIR= \
15  docker:dind --tls=false &
16EP_PID=$!
17
18export DOCKER_HOST="unix://${SOCK}"
19until docker info >/dev/null 2>&1; do sleep 0.2; done
20
21# Внутри воркера rollout образы доступны сразу, без загрузки из сети
22docker images
23
24# Завершение эпизода после расчёта награды (~10 мс)
25kill -KILL $EP_PID
26rm -f "/srv/rl-episodes/${EPISODE_ID}.ext4" "${SOCK}"
Программный пул rollouts с использованием Go SDK z.gfire.dev/gvx/pkg/gvx
Если ваш сервер RL-окружений или harness оценки написан на Go (или обращается к демону rollout на Go по gRPC), вы можете управлять параллельными контейнерными эпизодами напрямую через z.gfire.dev/gvx/pkg/gvx:
 1package main
 2
 3import (
 4	"bytes"
 5	"context"
 6	"fmt"
 7	"log"
 8	"os"
 9	"os/exec"
10	"path/filepath"
11	"time"
12
13	"z.gfire.dev/gvx/pkg/gvx"
14)
15
16func runEpisode(ctx context.Context, goldenExt4, scratchDir string, epID int) error {
17	epExt4 := filepath.Join(scratchDir, fmt.Sprintf("ep-%04d.ext4", epID))
18	defer os.Remove(epExt4)
19
20	// 1. Клонирование golden-тома ext4lite через reflink
21	cpCmd := exec.CommandContext(ctx, "cp", "--reflink=always", goldenExt4, epExt4)
22	if err := cpCmd.Run(); err != nil {
23		return fmt.Errorf("clone golden volume: %w", err)
24	}
25
26	// 2. Применение индивидуального таймаута эпизода по астрономическому времени
27	epCtx, cancel := context.WithTimeout(ctx, 2*time.Minute)
28	defer cancel()
29
30	var stdout, stderr bytes.Buffer
31	sb, err := gvx.New(epCtx, gvx.Config{
32		Platform:               gvx.PlatformAuto,
33		NetworkMode:            gvx.NetModeNAT,
34		NetRaw:                 true,
35		AllowPacketSocketWrite: true,
36		AllowSUID:              true,
37		OCIImage:               "docker:dind",
38		Entrypoint:             []string{"sh", "-c"},
39		EntrypointSet:          true,
40		Cmd: []string{
41			"dockerd-entrypoint.sh --tls=false >/var/log/dockerd.log 2>&1 & " +
42				"until docker info >/dev/null 2>&1; do sleep 0.2; done && " +
43				"docker run --rm python:3.11-slim python -c 'print(6 * 7)'",
44		},
45		Envv: []string{"DOCKER_TLS_CERTDIR="},
46		Mounts: []gvx.Mount{
47			{
48				Kind:      gvx.MountVolume,
49				ImagePath: epExt4,
50				GuestPath: "/var/lib/docker",
51			},
52		},
53		Resources: gvx.Resources{
54			MemoryBytes: 4 << 30, // ограничение 4 ГиБ
55			CPUMillis:   2000,    // 2,0 ЦП
56		},
57		Stdout: &stdout,
58		Stderr: &stderr,
59	})
60	if err != nil {
61		return fmt.Errorf("init episode %d: %w", epID, err)
62	}
63	defer sb.Close()
64
65	exitCode, err := sb.Run(epCtx)
66	if err != nil {
67		return fmt.Errorf("run episode %d: %w", epID, err)
68	}
69
70	log.Printf("episode %d finished: exit=%d stdout=%q", epID, exitCode, stdout.String())
71	return nil
72}
73
74func main() {
75	ctx := context.Background()
76	if err := runEpisode(ctx, "/srv/rl-snapshots/golden-docker.ext4", "/srv/rl-episodes", 1); err != nil {
77		log.Fatal(err)
78	}
79}
Сравнение сред выполнения песочниц для RL-агентов
| Метрика / требование | Общий dockerd хоста | Привилегированный docker:dind | Firecracker / KVM MicroVM | Стандартный gVisor (runsc) | gvx (rungv / pkg/gvx) |
|---|---|---|---|---|---|
Требуется root хоста или --privileged | Да (docker.sock = root) | Да (--privileged) | Нужны /dev/kvm и настройка TAP | Да (или userns + mount) | Нет (один непривилегированный процесс) |
Работает внутри непривилегированных подов K8s / существующего runsc | Нет | Нет | Нет (нет /dev/kvm) | Ошибка (EBUSY при вложенном seccomp) | Да (автоматический откат на цикл futex) |
Поддерживает внутренние docker build и docker compose | Использует демон хоста | Да | Да | Ошибка без тонкой настройки host DinD | Да (overlayfs на ext4lite) |
| Сетевая изоляция эпизода | Общие docker0 / блокировка xtables | Отдельное пространство имён | Отдельный сетевой интерфейс VM | Отдельный netns | Изолированный netstack внутри процесса |
Задержка сброса теплого эпизода (env.reset()) | От 5 до 30 с (очистка контейнеров/томов) | От 10 до 60 с (холодный демон) | ~150 мс (снимок VM) | От 5 до 20 с | ~100 мс (cp --reflink=always .ext4) |
| Кроссплатформенная локальная разработка (Windows / macOS / Linux) | Требуется виртуальная машина Linux | Требуется виртуальная машина Linux | Только Linux KVM | Только Linux | Нативно в Windows, macOS и Linux |
Дополнительные материалы в этой серии
- gvx: запуск контейнеров Linux, Docker и Kubernetes в одном непривилегированном процессе: Полный архитектурный обзор
gvxдля Windows (whpx,systrap), macOS (hvf) и Linux (systrap). - Запуск Docker, docker build и docker compose без root и пользовательских пространств имён: Краткое руководство по инициализации за 3 шага и устранению неполадок, когда заблокированы
sudo,unshare(CLONE_NEWUSER),mount(2)и/dev/fuse. - Запуск Docker-in-Docker внутри gVisor и вложенных песочниц с gvx: Подробный разбор того, почему
docker.ioи вложенныйrunscне работают внутриgVisor(runsc), и какgvxпереключается на цикл futex_RUN_SYSCALL_LOOPприEBUSY. - Быстрые изолированные Docker-окружения для RL rollouts агентов ИИ с gvx (этот пост)