 GoSuda
Szybkie izolowane środowiska Docker dla rolloutów RL agentów AI z wykorzystaniem gvx

Wąskie gardło bezpieczeństwa i infrastruktury w rolloutach RL agentów kodujących
Trenowanie i ewaluacja agentów inżynierii oprogramowania na benchmarkach oraz w frameworkach uczenia przez wzmocnienie (RL), takich jak SWE-bench, SWE-ReX, R2E-Gym, SWE-Gym, Verl i OpenHands, wymaga wykonywania tysięcy równoległych rolloutów niezaufanego kodu generowanego przez LLM. W rzeczywistych zadaniach inżynierii oprogramowania agent nie tylko edytuje pliki tekstowe: uruchamia docker build, podnosi bazy danych i mikroserwisy za pomocą docker compose, wykonuje zestawy testów integracyjnych oraz sprawdza logi kontenerów.
Na skali rolloutów (od 128 do 1 024 równoległych epizodów na klaster) istniejąca infrastruktura kontenerowa napotyka cztery systemowe wąskie gardła bezpieczeństwa i wydajności:
- Rywalizacja o blokady demona
dockerdhosta i wyciek stanu: Skierowanie setek równoległych workerów RL na jeden host/var/run/docker.sockdaje każdemu agentowi dostęp równoważny root do demona hosta, szereguje wyodrębnianie warstw obrazów, wyczerpuje alokacje podsiecidocker0, wywołuje błędyAnother app is currently holding the xtables lockwiptableshosta oraz pozostawia osierocone kontenery między epizodami. - Ryzyko ucieczki z kontenera w trybie uprzywilejowanym DinD: Uruchamianie standardowych kontenerów
docker:dindwymaga--privileged(CAP_SYS_ADMIN), co eksponuje surowe urządzenia blokowe hosta, cgroup release agents i moduły jądra niezaufanym rolloutom RL. - Ograniczenia wirtualizacji sprzętowej (
/dev/kvm): MicroVM (Firecracker,QEMU,Kata Containers) czysto izolują wewnętrzne jądra, ale wymagają/dev/kvm. Standardowe pody Kubernetes bez zagnieżdżonej wirtualizacji, instancje bare-metal w chmurze, na których KVM jest wyłączone, oraz istniejące piaskownicegVisor(runsc) nie mogą uruchamiać microVM KVM. - Wysokie opóźnienie resetu epizodu (
env.reset()): Uruchamianie świeżego środowiskadocker:dindoraz pobieranie lub rozpakowywanie obrazów bazowych dla każdego epizodu RL trwa od 10 do 60 sekund, pozostawiając bezczynne workery treningowe GPU w oczekiwaniu na resetowanie środowisk.
gvx (CLI rungv oraz SDK Go z.gfire.dev/gvx/pkg/gvx) zapewnia bezpieczne, niskonakładowe i oszczędne pod względem tokenów środowisko uruchomieniowe rolloutów, które rozwiązuje wszystkie cztery wąskie gardła. Każde środowisko rolloutu działa jako pojedynczy, nieuprzywilejowany, samoblokujący się proces w przestrzeni użytkownika (izolowany przez jądro Sentry gVisor firmy Google, pkg/hostlockdown oraz wewnętrzny netstack w pamięci), którego cały stan /var/lib/docker znajduje się w jednym pliku .ext4 typu copy-on-write (ext4lite).
Niskonakładowe, oszczędne pod względem tokenów wykonanie dla agentów: Gdy
docker buildlubdocker composedziała od razu w każdym epizodzie (lub może zostać uruchomione przez agenta w jednej turze złożonej z 3 poleceń za pomocąrungv), rollouty RL nie marnują tokenów okna kontekstu ani budżetu kroków na rozwiązywanie problemów zservice docker start, błędamiulimit, błędamiiptables-nftczy odrzuceniamipivot_rootprzezrunc. Każdy token trajektorii trafia do rozwiązywania rzeczywistego zadania inżynierii oprogramowania.
Bezpieczeństwo bez uprawnień dla niezaufanych rolloutów agentów: Każdy epizod
gvxblokuje własny proces systemu operacyjnego hosta przed uruchomieniem kodu gościa (PR_SET_NO_NEW_PRIVS+ BPFseccompw Linuxie, Seatbeltdeny defaultw macOS, Restricted Token + Job Object w Windows). Nawet jeśli agent RL wykonadocker run --privilegedlub destrukcyjne poleceniarm -rf /wewnątrz swojego epizodu, operacje te pozostają ściśle ograniczone do jądraSentryw przestrzeni użytkownika tego epizodu oraz do jego efemerycznego pliku woluminu.ext4.
Architektura rolloutów: równoległe nieuprzywilejowane instancje + snapshoty reflink
W gvx każdy worker rolloutu jest zwykłym nieuprzywilejowanym procesem systemu operacyjnego, z własnym jądrem Sentry gVisor, własnym netstack w przestrzeni użytkownika (10.0.2.15/24) oraz własnym woluminem blokowym ext4lite (ep-N.ext4), przy czym współdzieli tylko do odczytu adresowalną zawartościowo pamięć podręczną obrazów OCI erofs w page cache hosta.
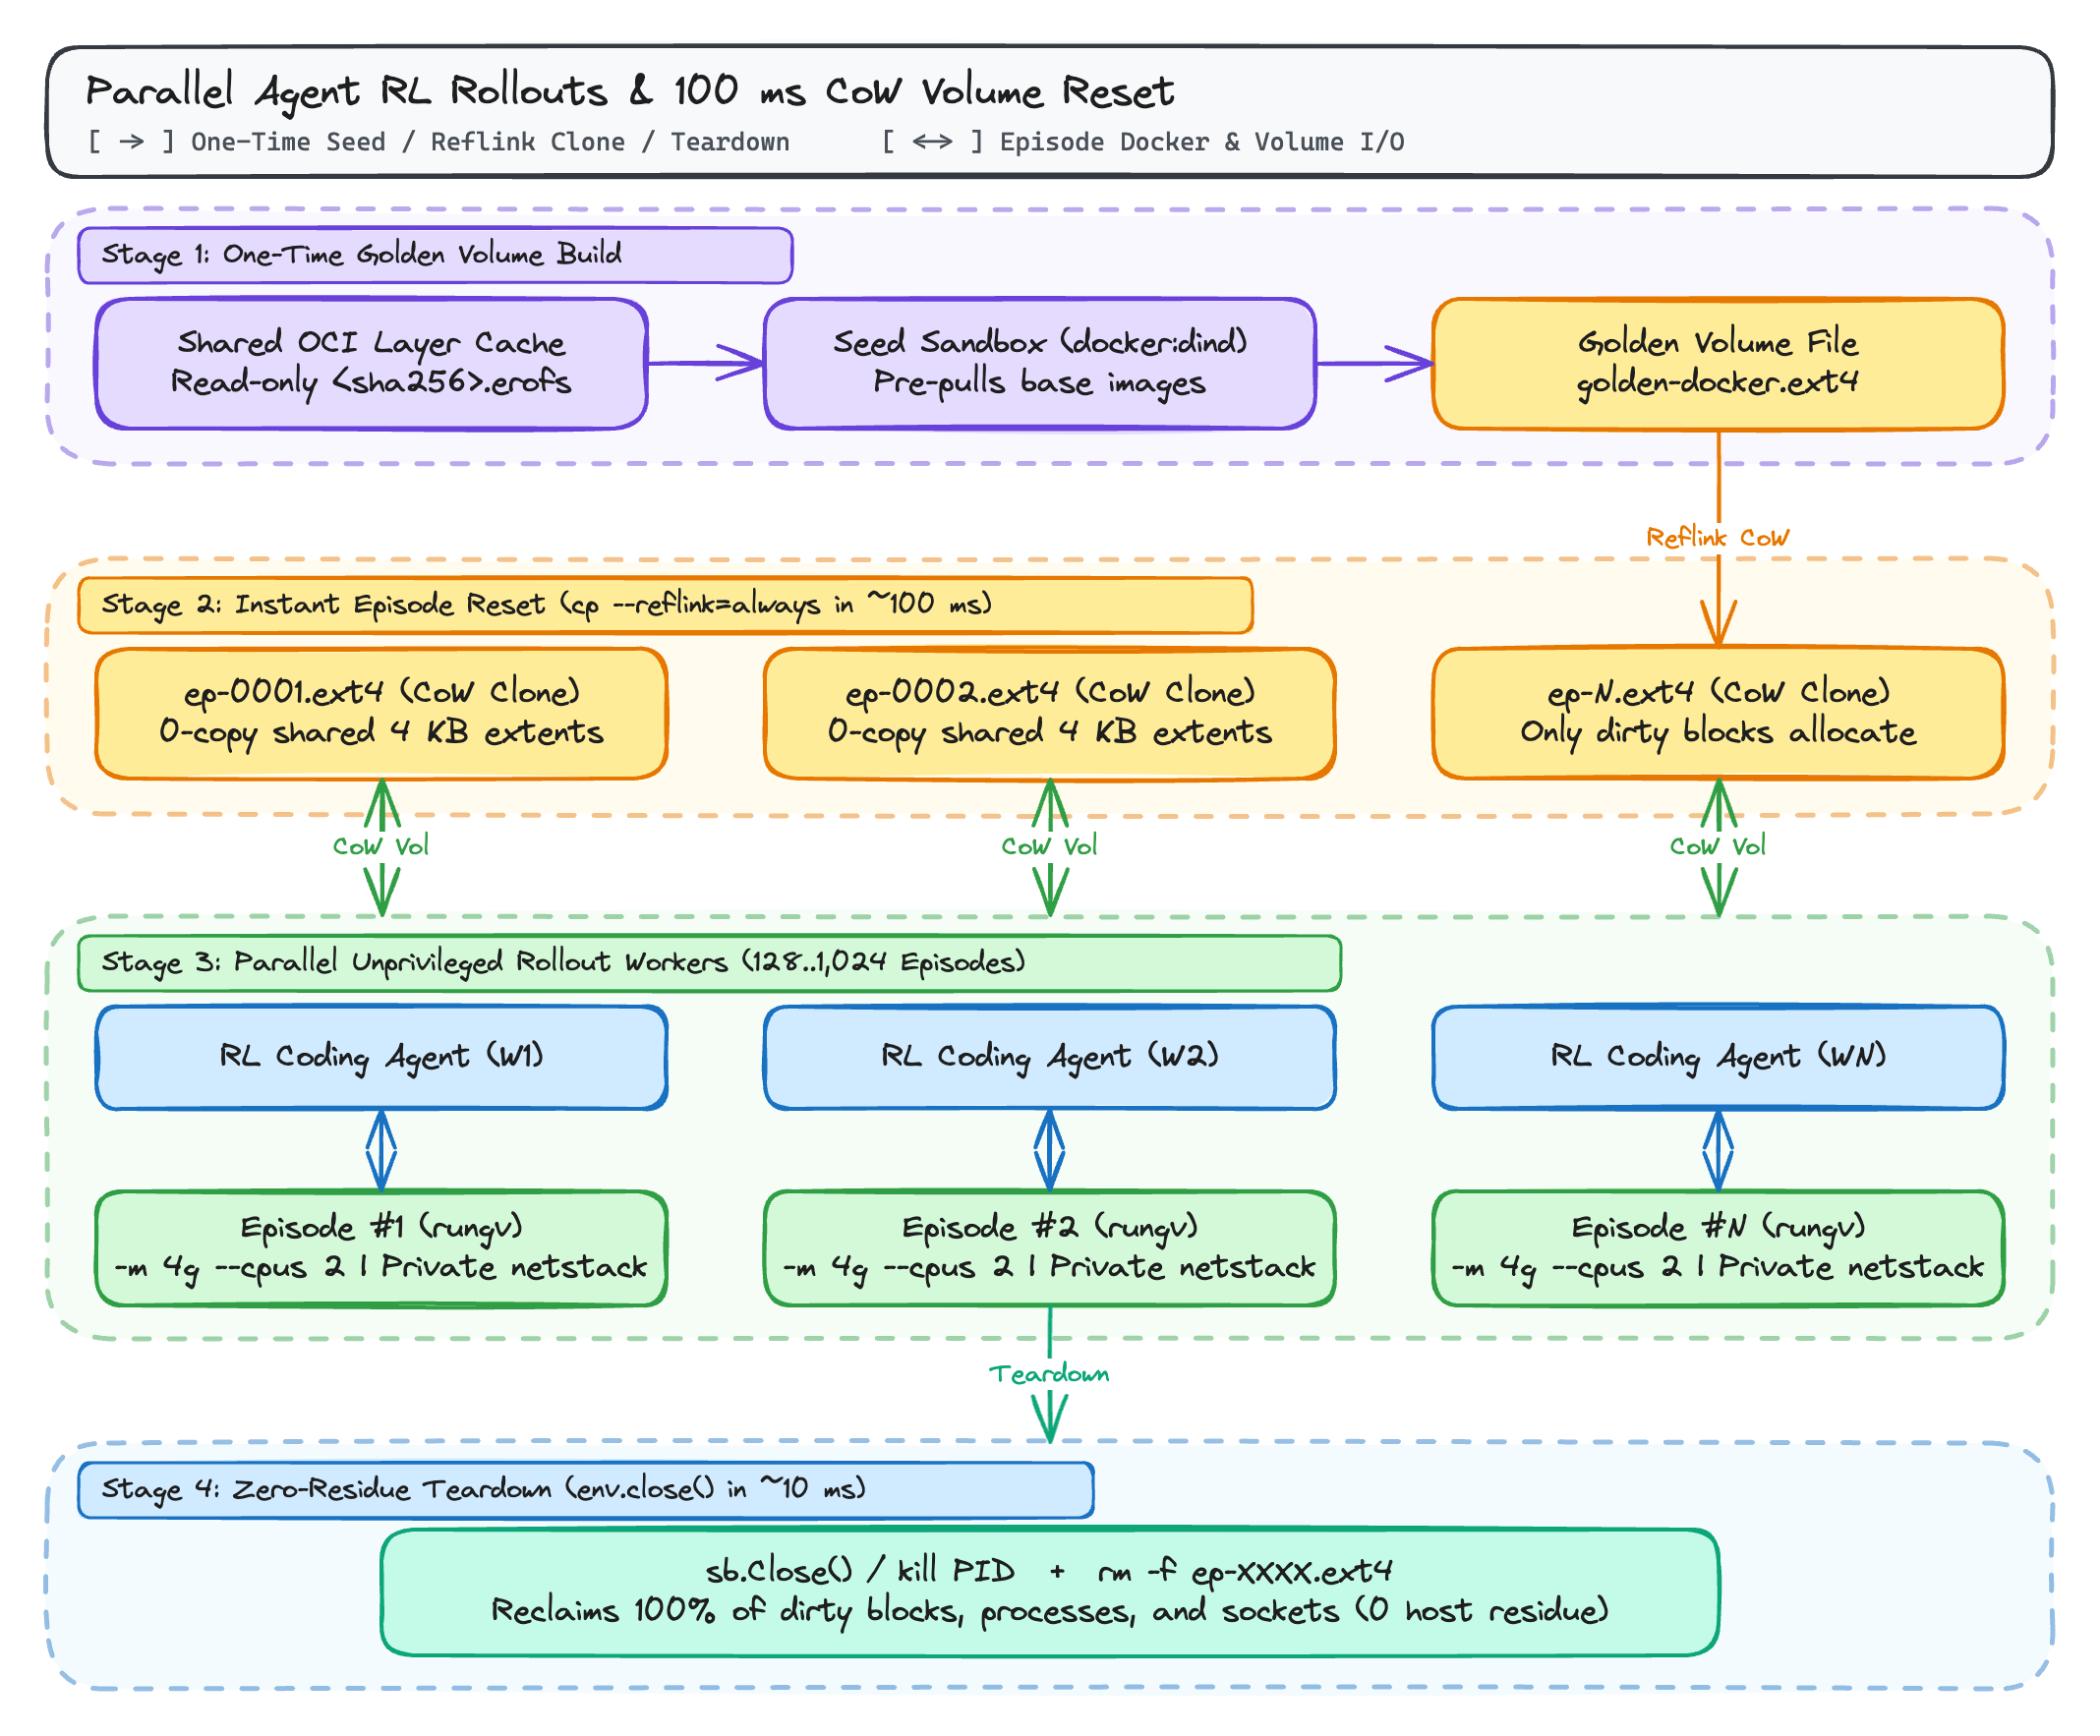
Dlaczego woluminy ext4lite w jednym pliku zmieniają ekonomię resetów RL
Ponieważ filesystem ext4lite przechowuje cały wolumin ext4 z dziennikiem JBD2 (w tym katalogi warstw overlayfs Dockera, rozszerzone atrybuty trusted.overlay.*, węzły urządzeń whiteout oraz metadane obrazów) w jednym zwykłym pliku hosta, zarządzanie cyklem życia epizodu sprowadza się do jednej operacji na pliku:
- Reset
env.reset()w 100 milisekund za pomocącp --reflink=always:- Raz budujesz plik
golden-docker.ext4zawierający wstępnie pobrane obrazy bazowe (python:3.11,postgres:16,redis:7lub specyficzne dla zadania obrazy bazoweSWE-bench). - Na początku każdego epizodu RL polecenie
cp --reflink=always golden-docker.ext4 ep-0042.ext4(na XFS, Btrfs, ZFS lub macOS APFS) tworzy niezależny klon Copy-on-Write w czasie krótszym niż 100 milisekund, bez kopiowania bazowych bloków dysku. - Dodatkową przestrzeń dyskową zajmują wyłącznie bloki 4 KiB zmodyfikowane w trakcie tego konkretnego epizodu.
- Raz budujesz plik
- Zerowe pozostałości przy zamykaniu (
env.close()):- Zakończenie procesu
rungv(sb.Close()w Go) i usunięcieep-0042.ext4odzyskuje 100% procesów, gniazd sieciowych, montowań i pamięci masowej epizodu w około 10 milisekund. Nic nigdy nie jest montowane w tabeli montowań jądra hosta ani rejestrowane w cgroupach hosta.
- Zakończenie procesu
Przewodnik krok po kroku: złoty snapshot .ext4 i szybki reset epizodu
Możesz zainstalować rungv na każdym węźle workera rolloutów, pobierając prekompilowany plik binarny z atestacją SLSA z GitHub Releases (gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml --deny-self-hosted-runners) lub uruchamiając CGO_ENABLED=0 go install z.gfire.dev/gvx/cmd/rungv@latest.
Krok 1: Utwórz złoty wolumin docker:dind jednorazowo
 1mkdir -p /srv/rl-snapshots /srv/rl-episodes
 2
 3# 1. Uruchom instancję seed docker:dind opartą na golden-docker.ext4
 4rungv run \
 5  -p unix:/srv/rl-snapshots/seed.sock:2375 \
 6  --mount type=volume,src=/srv/rl-snapshots/golden-docker.ext4,dst=/var/lib/docker \
 7  -e DOCKER_TLS_CERTDIR= \
 8  docker:dind --tls=false &
 9SEED_PID=$!
10
11# 2. Wstępnie wypełnij obrazy bazowe i cache budowania wewnątrz golden-docker.ext4
12export DOCKER_HOST="unix:///srv/rl-snapshots/seed.sock"
13until docker info >/dev/null 2>&1; do sleep 0.5; done
14
15docker pull python:3.11-slim
16docker pull redis:7-alpine
17docker pull postgres:16-alpine
18
19# 3. Łagodnie zatrzymaj instancję seed, aby ext4lite zapisał i skompaktował obraz
20kill -INT $SEED_PID
21wait $SEED_PID
Krok 2: Uruchom równoległe epizody RL w 100 milisekund
Każdy równoległy worker rolloutu klonuje golden-docker.ext4 przez reflink i uruchamia odizolowaną instancję docker:dind ze wszystkimi obrazami już obecnymi w /var/lib/docker:
 1EPISODE_ID="ep-0042"
 2SOCK="/srv/rl-episodes/${EPISODE_ID}.sock"
 3
 4# Natychmiastowy klon Copy-on-Write (~100 ms na XFS/Btrfs/APFS)
 5cp --reflink=always \
 6  /srv/rl-snapshots/golden-docker.ext4 \
 7  "/srv/rl-episodes/${EPISODE_ID}.ext4"
 8
 9# Uruchom odizolowany epizod bez uprawnień z 4 GiB RAM i 2 CPU
10rungv run \
11  -m 4g --cpus 2 \
12  -p "unix:${SOCK}:2375" \
13  --mount "type=volume,src=/srv/rl-episodes/${EPISODE_ID}.ext4,dst=/var/lib/docker" \
14  -e DOCKER_TLS_CERTDIR= \
15  docker:dind --tls=false &
16EP_PID=$!
17
18export DOCKER_HOST="unix://${SOCK}"
19until docker info >/dev/null 2>&1; do sleep 0.2; done
20
21# Wewnątrz workera rolloutu obrazy są od razu dostępne bez pobierania przez sieć
22docker images
23
24# Zakończenie epizodu po obliczeniu nagrody (~10 ms)
25kill -KILL $EP_PID
26rm -f "/srv/rl-episodes/${EPISODE_ID}.ext4" "${SOCK}"
Programowalna pula rolloutów z użyciem SDK Go z.gfire.dev/gvx/pkg/gvx
Jeśli Twój serwer środowisk RL lub harness ewaluacyjny jest napisany w Go (albo wywołuje demona rolloutów w Go przez gRPC), możesz zarządzać równoległymi epizodami kontenerów bezpośrednio przez z.gfire.dev/gvx/pkg/gvx:
 1package main
 2
 3import (
 4	"bytes"
 5	"context"
 6	"fmt"
 7	"log"
 8	"os"
 9	"os/exec"
10	"path/filepath"
11	"time"
12
13	"z.gfire.dev/gvx/pkg/gvx"
14)
15
16func runEpisode(ctx context.Context, goldenExt4, scratchDir string, epID int) error {
17	epExt4 := filepath.Join(scratchDir, fmt.Sprintf("ep-%04d.ext4", epID))
18	defer os.Remove(epExt4)
19
20	// 1. Sklonuj przez reflink wolumin golden ext4lite
21	cpCmd := exec.CommandContext(ctx, "cp", "--reflink=always", goldenExt4, epExt4)
22	if err := cpCmd.Run(); err != nil {
23		return fmt.Errorf("clone golden volume: %w", err)
24	}
25
26	// 2. Zastosuj limit czasu rzeczywistego dla epizodu
27	epCtx, cancel := context.WithTimeout(ctx, 2*time.Minute)
28	defer cancel()
29
30	var stdout, stderr bytes.Buffer
31	sb, err := gvx.New(epCtx, gvx.Config{
32		Platform:               gvx.PlatformAuto,
33		NetworkMode:            gvx.NetModeNAT,
34		NetRaw:                 true,
35		AllowPacketSocketWrite: true,
36		AllowSUID:              true,
37		OCIImage:               "docker:dind",
38		Entrypoint:             []string{"sh", "-c"},
39		EntrypointSet:          true,
40		Cmd: []string{
41			"dockerd-entrypoint.sh --tls=false >/var/log/dockerd.log 2>&1 & " +
42				"until docker info >/dev/null 2>&1; do sleep 0.2; done && " +
43				"docker run --rm python:3.11-slim python -c 'print(6 * 7)'",
44		},
45		Envv: []string{"DOCKER_TLS_CERTDIR="},
46		Mounts: []gvx.Mount{
47			{
48				Kind:      gvx.MountVolume,
49				ImagePath: epExt4,
50				GuestPath: "/var/lib/docker",
51			},
52		},
53		Resources: gvx.Resources{
54			MemoryBytes: 4 << 30, // limit 4 GiB
55			CPUMillis:   2000,    // 2.0 CPU
56		},
57		Stdout: &stdout,
58		Stderr: &stderr,
59	})
60	if err != nil {
61		return fmt.Errorf("init episode %d: %w", epID, err)
62	}
63	defer sb.Close()
64
65	exitCode, err := sb.Run(epCtx)
66	if err != nil {
67		return fmt.Errorf("run episode %d: %w", epID, err)
68	}
69
70	log.Printf("episode %d finished: exit=%d stdout=%q", epID, exitCode, stdout.String())
71	return nil
72}
73
74func main() {
75	ctx := context.Background()
76	if err := runEpisode(ctx, "/srv/rl-snapshots/golden-docker.ext4", "/srv/rl-episodes", 1); err != nil {
77		log.Fatal(err)
78	}
79}
Porównanie środowisk uruchomieniowych piaskownic RL agentów
| Metryka / wymaganie | Współdzielony demon dockerd hosta | Uprzywilejowany docker:dind | Firecracker / KVM MicroVM | Standardowy gVisor (runsc) | gvx (rungv / pkg/gvx) |
|---|---|---|---|---|---|
Wymagany root hosta lub --privileged | Tak (docker.sock = root) | Tak (--privileged) | Wymaga /dev/kvm + konfiguracji TAP | Tak (lub userns + mount) | Nie (pojedynczy proces bez uprawnień) |
Działa w nieuprzywilejowanych podach K8s / istniejącym runsc | Nie | Nie | Nie (brak /dev/kvm) | Nie (EBUSY przy zagnieżdżonym seccomp) | Tak (automatyczny fallback na pętlę futex) |
Obsługuje wewnętrzne docker build i docker compose | Współdzieli demona hosta | Tak | Tak | Nie bez strojenia DinD hosta | Tak (overlayfs na ext4lite) |
| Izolacja sieci per epizod | Współdzielony docker0 / blokada xtables | Oddzielna przestrzeń nazw | Oddzielna karta NIC VM | Oddzielna przestrzeń nazw sieciowych | Izolowany netstack w procesie |
Opóźnienie resetu ciepłego epizodu (env.reset()) | 5 s do 30 s (czyszczenie kontenera/woluminu) | 10 s do 60 s (zimny demon) | ~150 ms (snapshot VM) | 5 s do 20 s | ~100 ms (cp --reflink=always .ext4) |
| Lokalny development międzyplatformowy (Windows / macOS / Linux) | Wymaga maszyny wirtualnej Linux | Wymaga maszyny wirtualnej Linux | Tylko Linux KVM | Tylko Linux | Natywnie na Windows, macOS i Linux |
Dalsza lektura w tej serii
- gvx: uruchamianie kontenerów Linux, Docker i Kubernetes w jednym nieuprzywilejowanym procesie: Pełne omówienie architektury
gvxw systemach Windows (whpx,systrap), macOS (hvf) i Linux (systrap). - Uruchamianie Docker, docker build i docker compose bez roota ani przestrzeni użytkownika: Szybki 3-krokowy bootstrap oraz przewodnik rozwiązywania problemów, gdy
sudo,unshare(CLONE_NEWUSER),mount(2)i/dev/fusesą zablokowane. - Docker-in-Docker wewnątrz gVisor i zagnieżdżonych piaskownic z gvx: Szczegółowe omówienie tego, dlaczego
docker.ioi zagnieżdżonyrunsczawodzą wewnątrzgVisor(runsc) oraz jakgvxprzechodzi na pętlę futex_RUN_SYSCALL_LOOPprzyEBUSY. - Szybkie izolowane środowiska Docker dla rolloutów RL agentów AI z gvx (ten wpis)