 GoSuda
Entornos Docker Aislados y Rápidos para Rollouts de RL de Agentes de IA con gvx

El cuello de botella de seguridad e infraestructura en los rollouts de RL de agentes de programación
El entrenamiento y la evaluación de agentes de ingeniería de software mediante benchmarks y marcos de aprendizaje por refuerzo (RL) como SWE-bench, SWE-ReX, R2E-Gym, SWE-Gym, Verl y OpenHands requiere ejecutar miles de rollouts concurrentes de código no confiable generado por LLM. En tareas reales de ingeniería de software, un agente no se limita a editar archivos de texto: ejecuta docker build, levanta bases de datos y microservicios mediante docker compose, ejecuta suites de pruebas de integración e inspecciona los logs de los contenedores.
A escala de rollout (de 128 a 1.024 episodios concurrentes por clúster), la infraestructura de contenedores existente enfrenta cuatro cuellos de botella sistémicos de seguridad y rendimiento:
- Contención de bloqueos y fuga de estado en el
dockerddel host: Apuntar cientos de workers de RL concurrentes a un único/var/run/docker.sockdel host otorga a cada agente acceso equivalente a root sobre el daemon del host, serializa la extracción de capas de imágenes, agota las asignaciones de subredes dedocker0, provoca erroresAnother app is currently holding the xtables locken eliptablesdel host y deja contenedores huérfanos entre episodios. - Riesgo de escape de contenedor en DinD privilegiado: Ejecutar contenedores
docker:dindestándar requiere--privileged(CAP_SYS_ADMIN), lo que expone a los rollouts de RL no confiables los dispositivos de bloque crudos del host, los release agents de cgroups y los módulos del kernel. - Restricciones de virtualización por hardware (
/dev/kvm): Los runtimes de microVM (Firecracker,QEMU,Kata Containers) aíslan limpiamente los kernels internos, pero requieren/dev/kvm. Los pods estándar de Kubernetes sin virtualización anidada, las instancias cloud bare-metal donde KVM está deshabilitado y los sandboxes existentes degVisor(runsc) no pueden lanzar microVMs KVM. - Latencia lenta del reinicio de episodios (
env.reset()): Iniciar un entornodocker:dindnuevo y descargar o descomprimir imágenes base para cada episodio de RL tarda entre 10 y 60 segundos, dejando inactivos a los workers de entrenamiento en GPU mientras esperan el reinicio de los entornos.
gvx (CLI rungv y SDK de Go z.gfire.dev/gvx/pkg/gvx) proporciona un runtime de rollout seguro, de bajo esfuerzo y eficiente en tokens, que resuelve los cuatro cuellos de botella. Cada entorno de rollout se ejecuta como un único proceso de espacio de usuario, sin privilegios y con bloqueo propio (aislado por el kernel Sentry de gVisor de Google, pkg/hostlockdown y un netstack en memoria), cuyo estado completo de /var/lib/docker reside dentro de un único archivo .ext4 con copy-on-write (ext4lite).
Ejecución de bajo esfuerzo y eficiente en tokens para agentes: Cuando
docker buildodocker composefuncionan de forma inmediata en cada episodio (o el agente puede inicializarlos en un único turno de 3 comandos medianterungv), los rollouts de RL no desperdician tokens de la ventana de contexto ni presupuesto de pasos resolviendo fallos deservice docker start,ulimit, errores deiptables-nfto rechazos depivot_rootenrunc. Cada token de la trayectoria se dedica a resolver la tarea real de ingeniería de software.
Seguridad sin privilegios para rollouts de agentes no confiables: Cada episodio de
gvxbloquea su propio proceso del sistema operativo anfitrión antes de ejecutar código invitado (PR_SET_NO_NEW_PRIVS+seccompBPF en Linux,deny defaultde Seatbelt en macOS, Restricted Token + Job Object en Windows). Incluso si un agente de RL ejecutadocker run --privilegedo comandos destructivos comorm -rf /dentro de su episodio, esas operaciones permanecen estrictamente confinadas al kernelSentryde espacio de usuario de ese episodio y al archivo de volumen.ext4efímero.
Arquitectura de rollout: instancias paralelas sin privilegios + snapshots con reflink
En gvx, cada worker de rollout es un proceso ordinario del sistema operativo sin privilegios, con su propio kernel Sentry de gVisor, su propio netstack de espacio de usuario (10.0.2.15/24) y su propio volumen de bloques ext4lite (ep-N.ext4), mientras comparte una caché de imágenes OCI erofs de solo lectura y direccionable por contenido a través de la page cache del host.
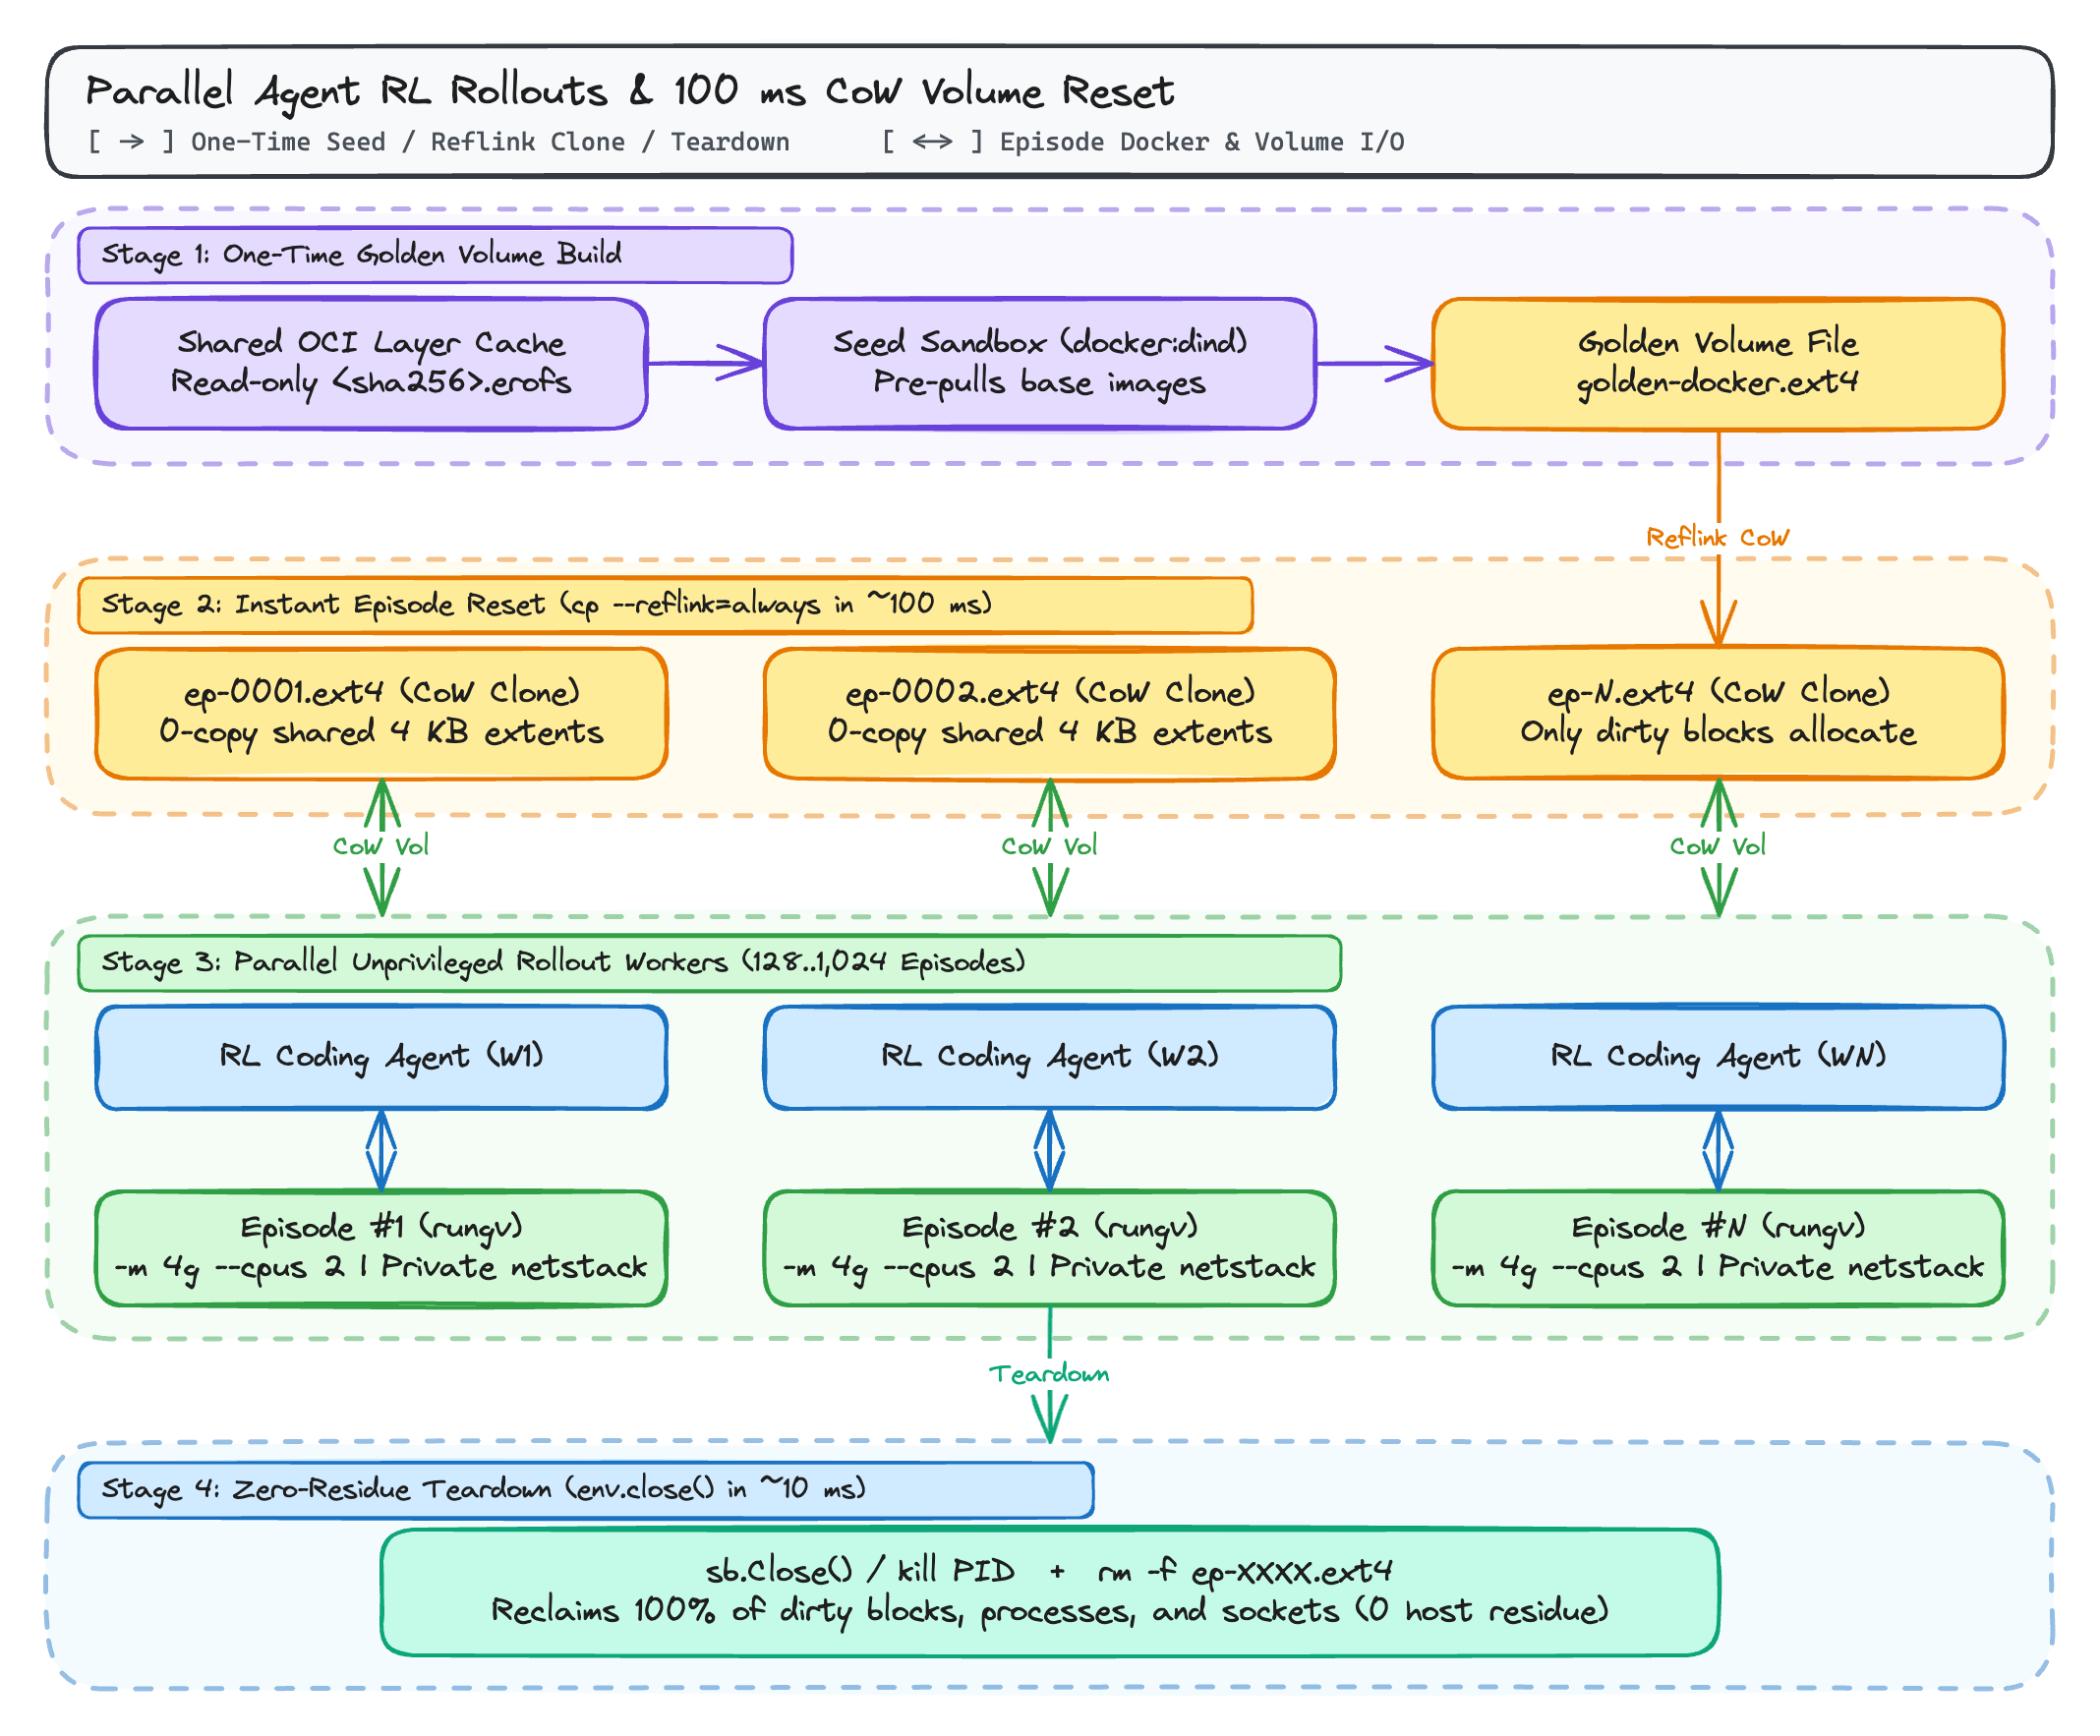
Por qué los volúmenes ext4lite de archivo único cambian la economía del reinicio en RL
Dado que el sistema de archivos ext4lite de gvx almacena un volumen ext4 completo con journal JBD2 (incluidos los directorios de capas de overlayfs de Docker, los atributos extendidos trusted.overlay.*, los nodos de dispositivo whiteout y los metadatos de imágenes) dentro de un único archivo regular del host, la gestión del ciclo de vida del episodio se convierte en una sola operación sobre archivos:
env.reset()de 100 milisegundos mediantecp --reflink=always:- Se construye una vez un archivo
golden-docker.ext4que contiene las imágenes base predescargadas (python:3.11,postgres:16,redis:7o las imágenes base específicas de la tarea deSWE-bench). - Al inicio de cada episodio de RL,
cp --reflink=always golden-docker.ext4 ep-0042.ext4(en XFS, Btrfs, ZFS o APFS de macOS) crea un clon independiente con copy-on-write en menos de 100 milisegundos, sin copiar los bloques de disco subyacentes. - Solo los bloques de 4 KiB modificados durante ese episodio concreto consumen espacio adicional en disco.
- Se construye una vez un archivo
- Desmontaje sin residuos (
env.close()):- Terminar el proceso
rungv(sb.Close()en Go) y desvincularep-0042.ext4libera el 100% de los procesos, sockets de red, montajes y almacenamiento del episodio en ~10 milisegundos. Nada queda montado en la tabla de montajes del kernel del host ni registrado en los cgroups del host.
- Terminar el proceso
Flujo de trabajo paso a paso: snapshot .ext4 dorado y reinicio rápido de episodios
Puedes instalar rungv en cada nodo worker de rollout descargando el binario precompilado con atestación SLSA desde Releases de GitHub (gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml --deny-self-hosted-runners) o ejecutando CGO_ENABLED=0 go install z.gfire.dev/gvx/cmd/rungv@latest.
Paso 1: Crear el volumen docker:dind dorado una sola vez
 1mkdir -p /srv/rl-snapshots /srv/rl-episodes
 2
 3# 1. Inicia una instancia semilla docker:dind respaldada por golden-docker.ext4
 4rungv run \
 5  -p unix:/srv/rl-snapshots/seed.sock:2375 \
 6  --mount type=volume,src=/srv/rl-snapshots/golden-docker.ext4,dst=/var/lib/docker \
 7  -e DOCKER_TLS_CERTDIR= \
 8  docker:dind --tls=false &
 9SEED_PID=$!
10
11# 2. Precarga las imágenes base y la caché de compilación dentro de golden-docker.ext4
12export DOCKER_HOST="unix:///srv/rl-snapshots/seed.sock"
13until docker info >/dev/null 2>&1; do sleep 0.5; done
14
15docker pull python:3.11-slim
16docker pull redis:7-alpine
17docker pull postgres:16-alpine
18
19# 3. Detén de forma ordenada la instancia semilla para que ext4lite vacíe y compacte la imagen
20kill -INT $SEED_PID
21wait $SEED_PID
Paso 2: Lanzar episodios de RL en paralelo en 100 milisegundos
Cada worker de rollout paralelo clona golden-docker.ext4 mediante reflink e inicia una instancia docker:dind aislada con todas las imágenes ya presentes en /var/lib/docker:
 1EPISODE_ID="ep-0042"
 2SOCK="/srv/rl-episodes/${EPISODE_ID}.sock"
 3
 4# Clon instantáneo Copy-on-Write (~100 ms en XFS/Btrfs/APFS)
 5cp --reflink=always \
 6  /srv/rl-snapshots/golden-docker.ext4 \
 7  "/srv/rl-episodes/${EPISODE_ID}.ext4"
 8
 9# Lanza un episodio aislado sin privilegios con 4 GiB de RAM y 2 CPUs
10rungv run \
11  -m 4g --cpus 2 \
12  -p "unix:${SOCK}:2375" \
13  --mount "type=volume,src=/srv/rl-episodes/${EPISODE_ID}.ext4,dst=/var/lib/docker" \
14  -e DOCKER_TLS_CERTDIR= \
15  docker:dind --tls=false &
16EP_PID=$!
17
18export DOCKER_HOST="unix://${SOCK}"
19until docker info >/dev/null 2>&1; do sleep 0.2; done
20
21# Dentro del worker de rollout, las imágenes están disponibles de inmediato sin descargarlas de la red
22docker images
23
24# Desmontaje del episodio tras el cálculo de la recompensa (~10 ms)
25kill -KILL $EP_PID
26rm -f "/srv/rl-episodes/${EPISODE_ID}.ext4" "${SOCK}"
Pool de rollouts programático con el SDK de Go z.gfire.dev/gvx/pkg/gvx
Si tu servidor de entornos de RL o tu arnés de evaluación está escrito en Go (o invoca un daemon de rollout en Go mediante gRPC), puedes gestionar episodios de contenedores en paralelo directamente a través de z.gfire.dev/gvx/pkg/gvx:
 1package main
 2
 3import (
 4	"bytes"
 5	"context"
 6	"fmt"
 7	"log"
 8	"os"
 9	"os/exec"
10	"path/filepath"
11	"time"
12
13	"z.gfire.dev/gvx/pkg/gvx"
14)
15
16func runEpisode(ctx context.Context, goldenExt4, scratchDir string, epID int) error {
17	epExt4 := filepath.Join(scratchDir, fmt.Sprintf("ep-%04d.ext4", epID))
18	defer os.Remove(epExt4)
19
20	// 1. Clona mediante reflink el volumen ext4lite dorado
21	cpCmd := exec.CommandContext(ctx, "cp", "--reflink=always", goldenExt4, epExt4)
22	if err := cpCmd.Run(); err != nil {
23		return fmt.Errorf("clone golden volume: %w", err)
24	}
25
26	// 2. Aplica un tiempo límite de reloj por episodio
27	epCtx, cancel := context.WithTimeout(ctx, 2*time.Minute)
28	defer cancel()
29
30	var stdout, stderr bytes.Buffer
31	sb, err := gvx.New(epCtx, gvx.Config{
32		Platform:               gvx.PlatformAuto,
33		NetworkMode:            gvx.NetModeNAT,
34		NetRaw:                 true,
35		AllowPacketSocketWrite: true,
36		AllowSUID:              true,
37		OCIImage:               "docker:dind",
38		Entrypoint:             []string{"sh", "-c"},
39		EntrypointSet:          true,
40		Cmd: []string{
41			"dockerd-entrypoint.sh --tls=false >/var/log/dockerd.log 2>&1 & " +
42				"until docker info >/dev/null 2>&1; do sleep 0.2; done && " +
43				"docker run --rm python:3.11-slim python -c 'print(6 * 7)'",
44		},
45		Envv: []string{"DOCKER_TLS_CERTDIR="},
46		Mounts: []gvx.Mount{
47			{
48				Kind:      gvx.MountVolume,
49				ImagePath: epExt4,
50				GuestPath: "/var/lib/docker",
51			},
52		},
53		Resources: gvx.Resources{
54			MemoryBytes: 4 << 30, // Límite de 4 GiB
55			CPUMillis:   2000,    // 2.0 CPUs
56		},
57		Stdout: &stdout,
58		Stderr: &stderr,
59	})
60	if err != nil {
61		return fmt.Errorf("init episode %d: %w", epID, err)
62	}
63	defer sb.Close()
64
65	exitCode, err := sb.Run(epCtx)
66	if err != nil {
67		return fmt.Errorf("run episode %d: %w", epID, err)
68	}
69
70	log.Printf("episode %d finished: exit=%d stdout=%q", epID, exitCode, stdout.String())
71	return nil
72}
73
74func main() {
75	ctx := context.Background()
76	if err := runEpisode(ctx, "/srv/rl-snapshots/golden-docker.ext4", "/srv/rl-episodes", 1); err != nil {
77		log.Fatal(err)
78	}
79}
Comparación de runtimes de sandbox para agentes de RL
| Métrica / Requisito | dockerd compartido del host | docker:dind privilegiado | Firecracker / microVM KVM | gVisor estándar (runsc) | gvx (rungv / pkg/gvx) |
|---|---|---|---|---|---|
Requiere root del host o --privileged | Sí (docker.sock = root) | Sí (--privileged) | Necesita /dev/kvm +配置 TAP | Sí (o userns + mount) | No (un único proceso sin privilegios) |
Funciona en Pods de K8s sin privilegios / runsc existente | No | No | No (sin /dev/kvm) | Falla (EBUSY en seccomp anidado) | Sí (bucle de futex como alternativa automática) |
Admite docker build y docker compose internos | Comparte el daemon del host | Sí | Sí | Falla sin ajuste de DinD en el host | Sí (overlayfs sobre ext4lite) |
| Aislamiento de red por episodio | docker0 / lock xtables compartidos | Namespace separado | NIC de VM separada | Netns separado | Aislado en un netstack dentro del proceso |
Latencia de reinicio de episodio en caliente (env.reset()) | 5 s a 30 s (poda de contenedores/volúmenes) | 10 s a 60 s (daemon en frío) | ~150 ms (snapshot de VM) | 5 s a 20 s | ~100 ms (cp --reflink=always de .ext4) |
| Desarrollo local multiplataforma (Windows / macOS / Linux) | Requiere una VM Linux | Requiere una VM Linux | Solo KVM de Linux | Solo Linux | Nativo en Windows, macOS y Linux |
Más lecturas de esta serie
- gvx: Ejecución de contenedores Linux, Docker y Kubernetes en un único proceso sin privilegios: Recorrido arquitectónico completo de
gvxen Windows (whpx,systrap), macOS (hvf) y Linux (systrap). - Ejecutar Docker, docker build y docker compose sin root ni user namespaces: Guía rápida de arranque en 3 pasos y de resolución de problemas cuando
sudo,unshare(CLONE_NEWUSER),mount(2)y/dev/fuseestán bloqueados. - Ejecutar Docker-in-Docker dentro de gVisor y sandboxes anidados con gvx: Análisis detallado de por qué
docker.ioyrunscanidado fallan dentro degVisor(runsc) y de cómogvxrecurre al bucle de futex_RUN_SYSCALL_LOOPanteEBUSY. - Entornos Docker aislados y rápidos para rollouts de RL de agentes con gvx (esta entrada)