 GoSuda
Ambienti Docker isolati e veloci per i rollout di RL degli agenti AI con gvx

Il collo di bottiglia della sicurezza e dell'infrastruttura nei rollout RL degli agenti di coding
L'addestramento e la valutazione di agenti per l'ingegneria del software su benchmark e framework di reinforcement learning (RL) quali SWE-bench, SWE-ReX, R2E-Gym, SWE-Gym, Verl e OpenHands richiedono l'esecuzione di migliaia di rollout concorrenti di codice non attendibile generato da LLM. Nei compiti reali di ingegneria del software, un agente non si limita a modificare file di testo: esegue docker build, avvia database e microservizi tramite docker compose, esegue suite di test di integrazione e ispeziona i log dei container.
Alla scala dei rollout (da 128 a 1.024 episodi concorrenti per cluster), l'infrastruttura di container esistente incontra quattro colli di bottiglia sistemici di sicurezza e prestazioni:
- Contesa di lock su
dockerddell'host e fuga di stato: Far puntare centinaia di worker RL concorrenti a un singolo/var/run/docker.sockdell'host concede a ogni agente un accesso equivalente a root al daemon dell'host, serializza l'estrazione dei layer delle immagini, esaurisce le allocazioni di subnet didocker0, provoca erroriAnother app is currently holding the xtables lockiniptablesdell'host e lascia container orfani tra un episodio e l'altro. - Rischio di evasione dal container tramite DinD privilegiato: L'esecuzione di container
docker:dindstandard richiede--privileged(CAP_SYS_ADMIN), che espone ai rollout RL non attendibili i block device grezzi dell'host, i cgroup release agent e i moduli del kernel. - Vincoli della virtualizzazione hardware (
/dev/kvm): I runtime MicroVM (Firecracker,QEMU,Kata Containers) isolano in modo pulito i kernel interni, ma richiedono/dev/kvm. I pod Kubernetes standard senza virtualizzazione annidata, le istanze cloud bare-metal in cui KVM è disabilitato e le sandboxgVisor(runsc) esistenti non possono avviare microVM KVM. - Latenza elevata del reset dell'episodio (
env.reset()): Avviare un nuovo ambientedocker:dinde scaricare o decomprimere le immagini di base per ogni episodio RL richiede da 10 a 60 secondi, lasciando inattivi i worker GPU di addestramento in attesa del reset degli ambienti.
gvx (CLI rungv e SDK Go z.gfire.dev/gvx/pkg/gvx) fornisce un runtime di rollout sicuro, a basso sforzo ed efficiente in termini di token, che risolve tutti e quattro i colli di bottiglia. Ogni ambiente di rollout viene eseguito come un unico processo user-space senza privilegi e auto-bloccato (isolato dal kernel Sentry di gVisor di Google, da pkg/hostlockdown e da un netstack in memoria), il cui intero stato di /var/lib/docker risiede all'interno di un unico file .ext4 copy-on-write (ext4lite).
Esecuzione a basso sforzo ed efficiente in termini di token per gli agenti: Quando
docker buildodocker composefunzionano immediatamente in ogni episodio (oppure possono essere inizializzati dall'agente in un unico turno di 3 comandi tramiterungv), i rollout RL non sprecano token della finestra di contesto né budget di passi nel risolvere problemi come i fallimenti diservice docker starteulimit, gli errori diiptables-nfto i rifiuti dipivot_rootda parte dirunc. Ogni token della traiettoria è dedicato alla risoluzione del compito reale di ingegneria del software.
Sicurezza senza privilegi per rollout di agenti non attendibili: Ogni episodio di
gvxblocca il proprio processo del sistema operativo host prima di eseguire il codice guest (PR_SET_NO_NEW_PRIVS+seccompBPF su Linux,deny defaultdi Seatbelt su macOS, Restricted Token + Job Object su Windows). Anche se un agente RL eseguedocker run --privilegedo comandi distruttivirm -rf /all'interno del proprio episodio, tali operazioni restano rigorosamente confinate al kernelSentryuser-space di quell'episodio e al relativo file volume.ext4effimero.
Architettura del rollout: istanze parallele senza privilegi + snapshot reflink
In gvx, ogni worker di rollout è un normale processo del sistema operativo senza privilegi, con il proprio kernel Sentry di gVisor, il proprio netstack user-space (10.0.2.15/24) e il proprio volume a blocchi ext4lite (ep-N.ext4), condividendo al contempo una cache di immagini OCI erofs in sola lettura e indirizzabile per contenuto, attraverso la page cache dell'host.
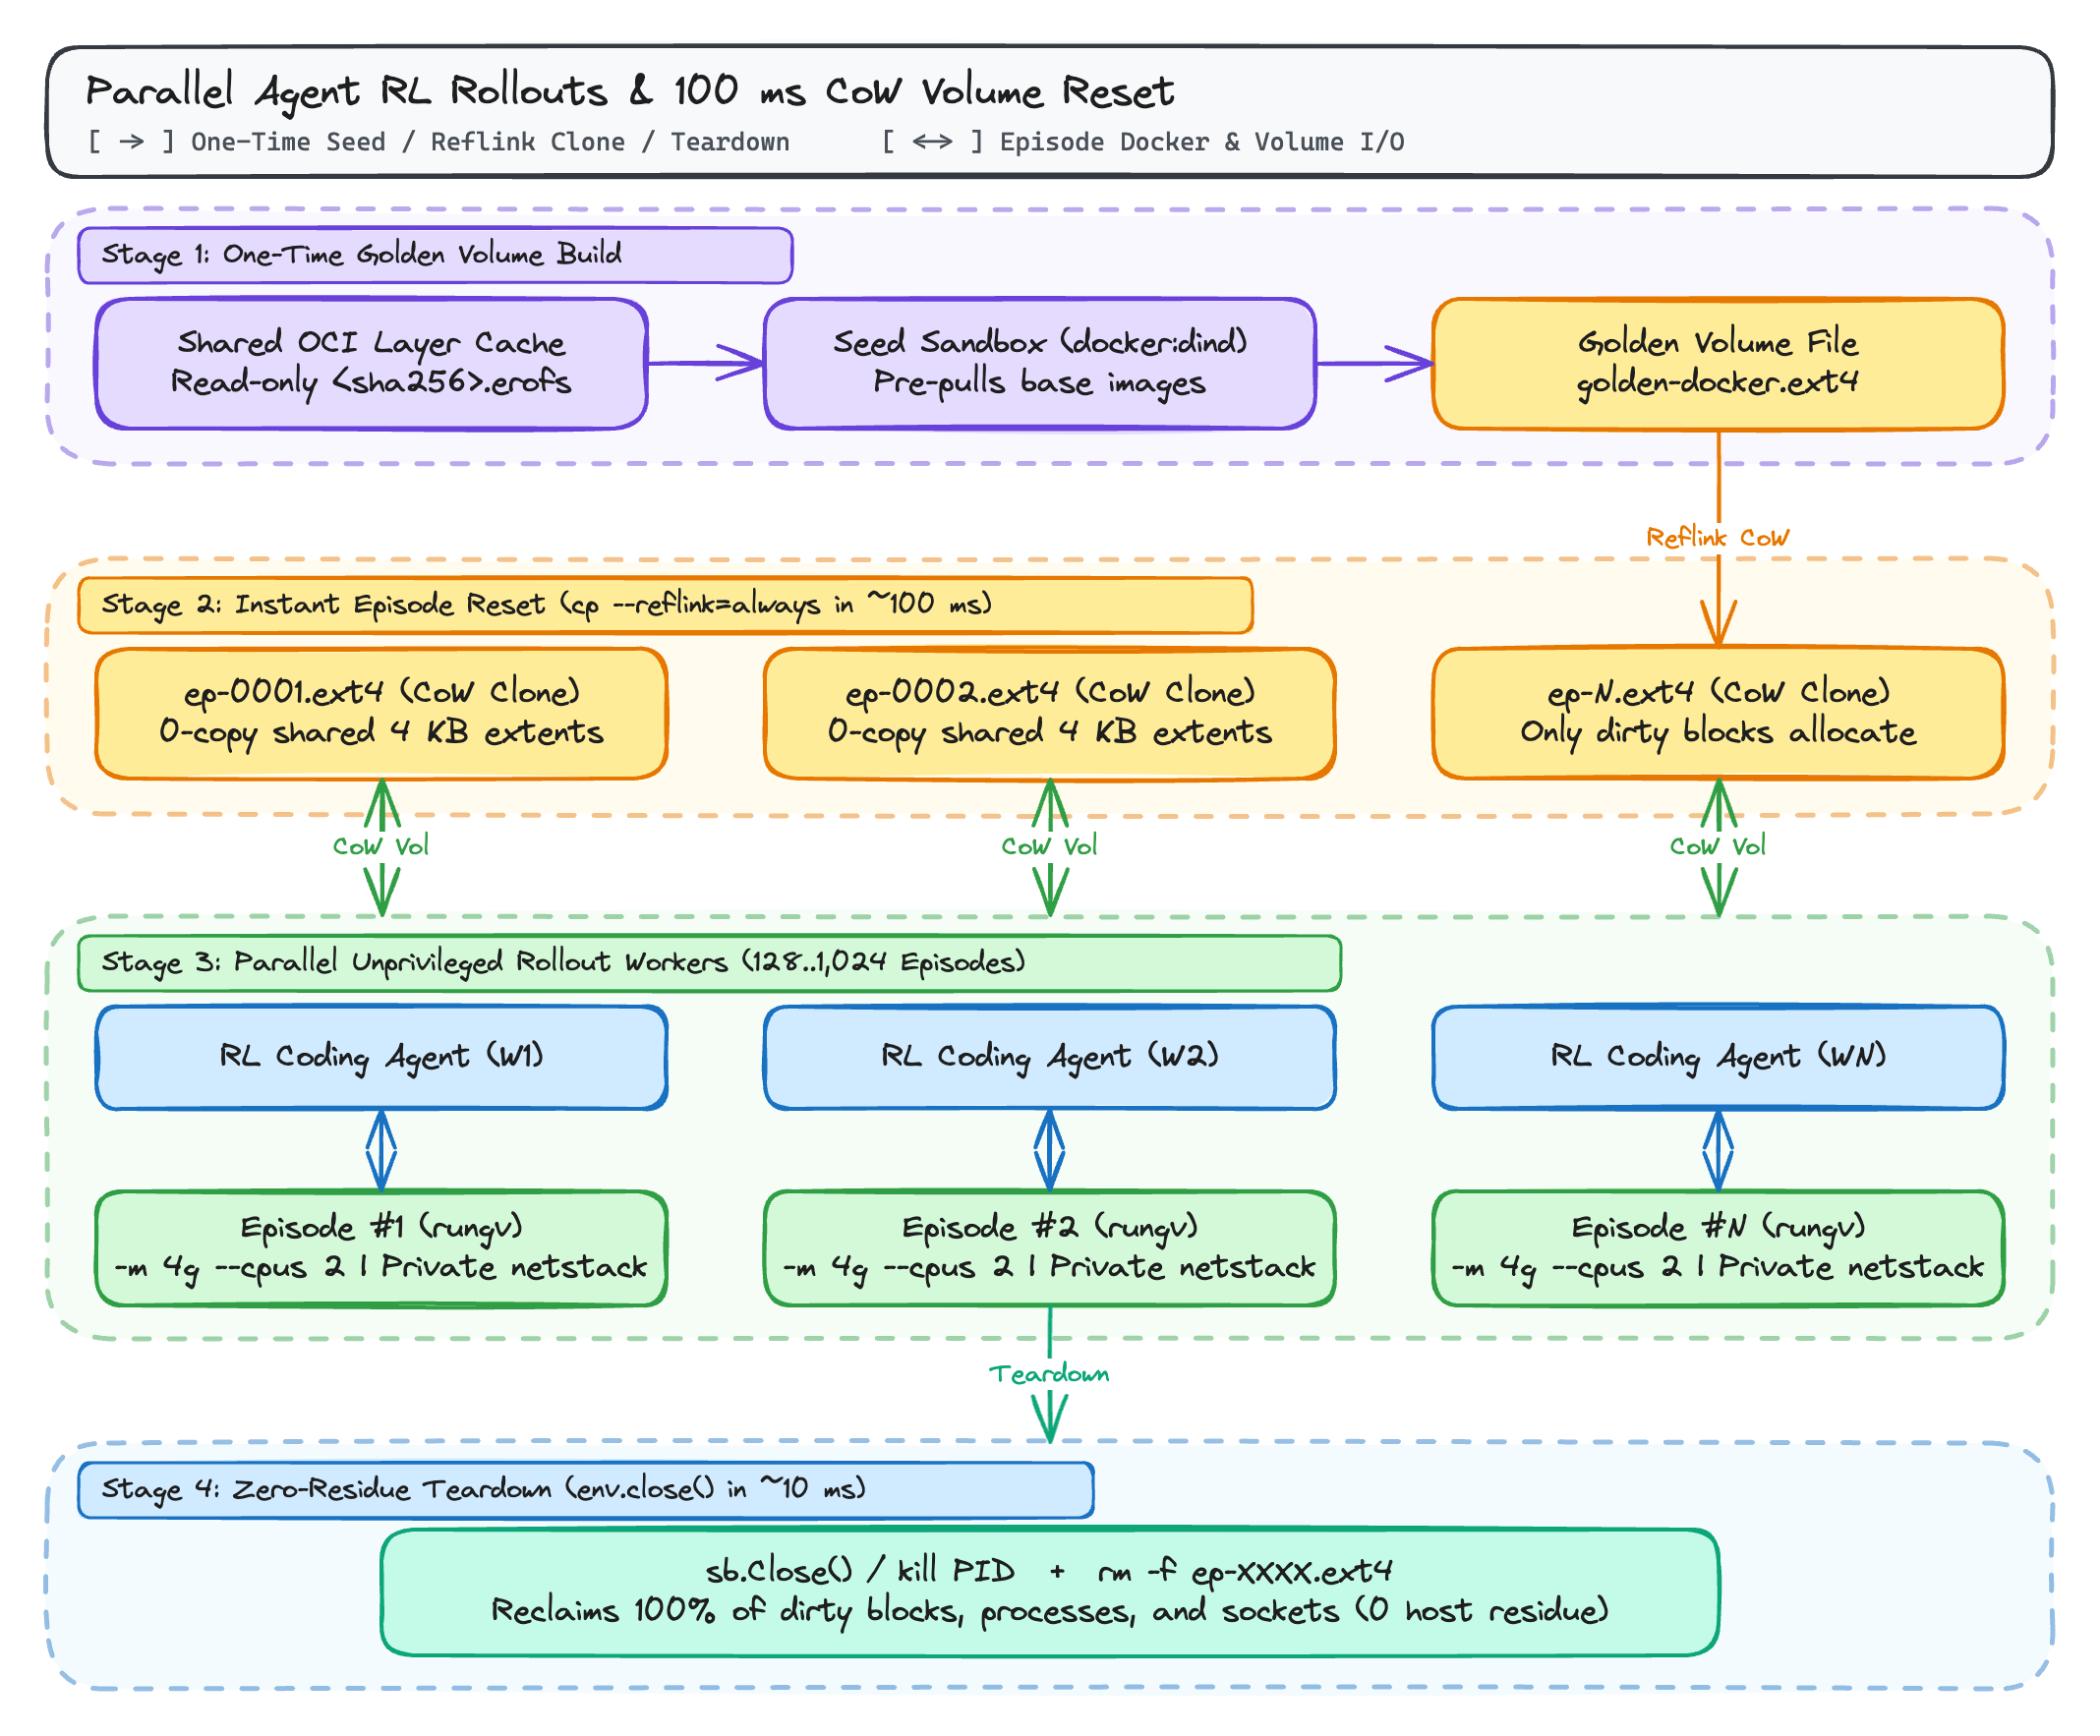
Perché i volumi ext4lite a file singolo cambiano l'economia del reset RL
Poiché il filesystem ext4lite di gvx memorizza un intero volume ext4 con journal JBD2 (incluse le directory dei layer overlayfs di Docker, gli attributi estesi trusted.overlay.*, i device node di whiteout e i metadati delle immagini) all'interno di un unico file regolare dell'host, la gestione del ciclo di vita dell'episodio si riduce a un'unica operazione su file:
- Reset di
env.reset()in 100 millisecondi tramitecp --reflink=always:- Si costruisce una volta sola un file
golden-docker.ext4contenente immagini di base già scaricate (python:3.11,postgres:16,redis:7, o le immagini di base specifiche per il compito diSWE-bench). - All'inizio di ogni episodio RL,
cp --reflink=always golden-docker.ext4 ep-0042.ext4(su XFS, Btrfs, ZFS o macOS APFS) crea un clone Copy-on-Write indipendente in meno di 100 millisecondi senza copiare i blocchi del disco sottostante. - Solo i blocchi da 4 KiB modificati durante quello specifico episodio consumano spazio aggiuntivo su disco.
- Si costruisce una volta sola un file
- Smantellamento senza residui (
env.close()):- Terminare il processo
rungv(sb.Close()in Go) e rimuovereep-0042.ext4recupera il 100% dei processi, dei socket di rete, dei mount e dello storage dell'episodio in circa 10 millisecondi. Nulla viene mai montato nella mount table del kernel host né registrato nei cgroup dell'host.
- Terminare il processo
Flusso di lavoro passo passo: snapshot .ext4 golden e reset rapido dell'episodio
È possibile installare rungv su ciascun nodo worker di rollout scaricando il binario precompilato con attestazione SLSA dalle GitHub Releases (gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml --deny-self-hosted-runners) oppure eseguendo CGO_ENABLED=0 go install z.gfire.dev/gvx/cmd/rungv@latest.
Passo 1: creare una sola volta il volume docker:dind golden
 1mkdir -p /srv/rl-snapshots /srv/rl-episodes
 2
 3# 1. Avviare un'istanza seed docker:dind basata su golden-docker.ext4
 4rungv run \
 5  -p unix:/srv/rl-snapshots/seed.sock:2375 \
 6  --mount type=volume,src=/srv/rl-snapshots/golden-docker.ext4,dst=/var/lib/docker \
 7  -e DOCKER_TLS_CERTDIR= \
 8  docker:dind --tls=false &
 9SEED_PID=$!
10
11# 2. Precaricare le immagini di base e la cache di build all'interno di golden-docker.ext4
12export DOCKER_HOST="unix:///srv/rl-snapshots/seed.sock"
13until docker info >/dev/null 2>&1; do sleep 0.5; done
14
15docker pull python:3.11-slim
16docker pull redis:7-alpine
17docker pull postgres:16-alpine
18
19# 3. Arrestare con grazia l'istanza seed in modo che ext4lite esegua il flush e compatti l'immagine
20kill -INT $SEED_PID
21wait $SEED_PID
Passo 2: avviare episodi RL paralleli in 100 millisecondi
Ogni worker di rollout parallelo clona golden-docker.ext4 tramite reflink e avvia un'istanza docker:dind isolata con tutte le immagini già presenti in /var/lib/docker:
 1EPISODE_ID="ep-0042"
 2SOCK="/srv/rl-episodes/${EPISODE_ID}.sock"
 3
 4# Clone Copy-on-Write istantaneo (~100 ms su XFS/Btrfs/APFS)
 5cp --reflink=always \
 6  /srv/rl-snapshots/golden-docker.ext4 \
 7  "/srv/rl-episodes/${EPISODE_ID}.ext4"
 8
 9# Avviare un episodio isolato senza privilegi con 4 GiB di RAM e 2 CPU
10rungv run \
11  -m 4g --cpus 2 \
12  -p "unix:${SOCK}:2375" \
13  --mount "type=volume,src=/srv/rl-episodes/${EPISODE_ID}.ext4,dst=/var/lib/docker" \
14  -e DOCKER_TLS_CERTDIR= \
15  docker:dind --tls=false &
16EP_PID=$!
17
18export DOCKER_HOST="unix://${SOCK}"
19until docker info >/dev/null 2>&1; do sleep 0.2; done
20
21# All'interno del worker di rollout, le immagini sono immediatamente disponibili senza pull dalla rete
22docker images
23
24# Smantellamento dell'episodio dopo il calcolo della ricompensa (~10 ms)
25kill -KILL $EP_PID
26rm -f "/srv/rl-episodes/${EPISODE_ID}.ext4" "${SOCK}"
Pool di rollout programmatico tramite l'SDK Go z.gfire.dev/gvx/pkg/gvx
Se il server dell'ambiente RL o l'harness di valutazione è scritto in Go (oppure invoca un daemon di rollout in Go tramite gRPC), è possibile gestire episodi di container paralleli direttamente tramite z.gfire.dev/gvx/pkg/gvx:
 1package main
 2
 3import (
 4	"bytes"
 5	"context"
 6	"fmt"
 7	"log"
 8	"os"
 9	"os/exec"
10	"path/filepath"
11	"time"
12
13	"z.gfire.dev/gvx/pkg/gvx"
14)
15
16func runEpisode(ctx context.Context, goldenExt4, scratchDir string, epID int) error {
17	epExt4 := filepath.Join(scratchDir, fmt.Sprintf("ep-%04d.ext4", epID))
18	defer os.Remove(epExt4)
19
20	// 1. Clona per reflink il volume golden ext4lite
21	cpCmd := exec.CommandContext(ctx, "cp", "--reflink=always", goldenExt4, epExt4)
22	if err := cpCmd.Run(); err != nil {
23		return fmt.Errorf("clone golden volume: %w", err)
24	}
25
26	// 2. Applica il timeout di wall-clock per episodio
27	epCtx, cancel := context.WithTimeout(ctx, 2*time.Minute)
28	defer cancel()
29
30	var stdout, stderr bytes.Buffer
31	sb, err := gvx.New(epCtx, gvx.Config{
32		Platform:               gvx.PlatformAuto,
33		NetworkMode:            gvx.NetModeNAT,
34		NetRaw:                 true,
35		AllowPacketSocketWrite: true,
36		AllowSUID:              true,
37		OCIImage:               "docker:dind",
38		Entrypoint:             []string{"sh", "-c"},
39		EntrypointSet:          true,
40		Cmd: []string{
41			"dockerd-entrypoint.sh --tls=false >/var/log/dockerd.log 2>&1 & " +
42				"until docker info >/dev/null 2>&1; do sleep 0.2; done && " +
43				"docker run --rm python:3.11-slim python -c 'print(6 * 7)'",
44		},
45		Envv: []string{"DOCKER_TLS_CERTDIR="},
46		Mounts: []gvx.Mount{
47			{
48				Kind:      gvx.MountVolume,
49				ImagePath: epExt4,
50				GuestPath: "/var/lib/docker",
51			},
52		},
53		Resources: gvx.Resources{
54			MemoryBytes: 4 << 30, // limite di 4 GiB
55			CPUMillis:   2000,    // 2.0 CPU
56		},
57		Stdout: &stdout,
58		Stderr: &stderr,
59	})
60	if err != nil {
61		return fmt.Errorf("init episode %d: %w", epID, err)
62	}
63	defer sb.Close()
64
65	exitCode, err := sb.Run(epCtx)
66	if err != nil {
67		return fmt.Errorf("run episode %d: %w", epID, err)
68	}
69
70	log.Printf("episode %d finished: exit=%d stdout=%q", epID, exitCode, stdout.String())
71	return nil
72}
73
74func main() {
75	ctx := context.Background()
76	if err := runEpisode(ctx, "/srv/rl-snapshots/golden-docker.ext4", "/srv/rl-episodes", 1); err != nil {
77		log.Fatal(err)
78	}
79}
Confronto tra i runtime di sandbox per agenti RL
| Metrica / Requisito | dockerd dell'host condiviso | docker:dind privilegiato | Firecracker / KVM MicroVM | gVisor standard (runsc) | gvx (rungv / pkg/gvx) |
|---|---|---|---|---|---|
Richiesto root dell'host o --privileged | Sì (docker.sock = root) | Sì (--privileged) | Richiede /dev/kvm + configurazione TAP | Sì (o userns + mount) | No (singolo processo senza privilegi) |
Funziona in Pod K8s senza privilegi / runsc esistenti | No | No | No (nessun /dev/kvm) | Fallisce (EBUSY su seccomp annidato) | Sì (fallback automatico al loop futex) |
Supporta docker build e docker compose interni | Condivide il daemon dell'host | Sì | Sì | Fallisce senza configurazione DinD dell'host | Sì (overlayfs su ext4lite) |
| Isolamento di rete per episodio | docker0 / lock xtables condivisi | Namespace separato | NIC della VM separata | Netns separato | netstack isolato nel processo |
Latenza di reset a caldo dell'episodio (env.reset()) | Da 5 s a 30 s (prune di container/volumi) | Da 10 s a 60 s (daemon a freddo) | ~150 ms (snapshot della VM) | Da 5 s a 20 s | ~100 ms (cp --reflink=always di .ext4) |
| Sviluppo locale multipiattaforma (Windows / macOS / Linux) | Richiede una VM Linux | Richiede una VM Linux | Solo Linux KVM | Solo Linux | Nativo su Windows, macOS e Linux |
Ulteriori letture in questa serie
- gvx: Esecuzione di container Linux, Docker e Kubernetes in un unico processo senza privilegi: Walkthrough architetturale completo di
gvxsu Windows (whpx,systrap), macOS (hvf) e Linux (systrap). - Esecuzione di Docker, docker build e docker compose senza root né user namespace: Guida rapida di bootstrap in 3 passi e di risoluzione dei problemi quando
sudo,unshare(CLONE_NEWUSER),mount(2)e/dev/fusesono bloccati. - Esecuzione di Docker-in-Docker all'interno di gVisor e di sandbox annidate con gvx: Approfondimento sul motivo per cui
docker.ioerunscannidato falliscono all'interno digVisor(runsc) e su comegvxripiega sul loop futex_RUN_SYSCALL_LOOPin caso diEBUSY. - Ambienti Docker isolati e veloci per i rollout RL di agenti IA con gvx (questo post)