 GoSuda
Environnements Docker isolés et rapides pour les déploiements RL d'agents IA avec gvx

Goulot d'étranglement de sécurité et d'infrastructure dans les rollouts RL de agents de codage
L'entraînement et l'évaluation d'agents d'ingénierie logicielle à travers des benchmarks et des frameworks d'apprentissage par renforcement (RL) tels que SWE-bench, SWE-ReX, R2E-Gym, SWE-Gym, Verl et OpenHands exigent l'exécution de milliers de rollouts concurrents de code non fiable généré par LLM. Dans les tâches réelles d'ingénierie logicielle, un agent ne se contente pas de modifier des fichiers texte : il exécute docker build, lance des bases de données et des microservices via docker compose, exécute des suites de tests d'intégration et inspecte les journaux des conteneurs.
À l'échelle des rollouts (128 à 1 024 épisodes concurrents par cluster), l'infrastructure de conteneurs existante se heurte à quatre goulots d'étranglement systémiques en matière de sécurité et de performance :
- Contention des verrous de
dockerdhôte et fuite d'état : Faire pointer des centaines de workers RL concurrents vers un unique/var/run/docker.sockde l'hôte accorde à chaque agent un accès équivalent à root sur le démon hôte, sérialise l'extraction des couches d'images, épuise les allocations de sous-réseaux dedocker0, déclenche les erreursAnother app is currently holding the xtables lockdans lesiptablesde l'hôte, et laisse des conteneurs orphelins fuir d'un épisode à l'autre. - Risque d'évasion de conteneur via DinD privilégié : L'exécution de conteneurs
docker:dindstandard nécessite--privileged(CAP_SYS_ADMIN), ce qui expose aux rollouts RL non fiables les périphériques blocs bruts de l'hôte, les release agents de cgroups et les modules noyau. - Contraintes de virtualisation matérielle (
/dev/kvm) : Les runtimes MicroVM (Firecracker,QEMU,Kata Containers) isolent proprement les noyaux internes, mais ils nécessitent/dev/kvm. Les pods Kubernetes standard sans virtualisation imbriquée, les instances cloud bare-metal où KVM est désactivé et les sandboxesgVisor(runsc) existantes ne peuvent pas lancer de microVMs KVM. - Latence élevée de réinitialisation d'épisode (
env.reset()) : Démarrer un nouvel environnementdocker:dindet télécharger ou décompresser les images de base pour chaque épisode RL prend 10 à 60 secondes, laissant les workers d'entraînement GPU inactifs en attendant la réinitialisation des environnements.
gvx (CLI rungv et SDK Go z.gfire.dev/gvx/pkg/gvx) fournit un runtime de rollout sécurisé, peu coûteux en effort et économe en tokens, qui résout les quatre goulots d'étranglement. Chaque environnement de rollout s'exécute comme un unique processus en espace utilisateur, non privilégié et auto-verrouillé (isolé par le noyau Sentry de gVisor de Google, par pkg/hostlockdown et par un netstack en mémoire), dont l'intégralité de l'état /var/lib/docker réside dans un unique fichier .ext4 en copy-on-write (ext4lite).
Exécution peu coûteuse en effort et économe en tokens pour les agents : Lorsque
docker buildoudocker composefonctionne immédiatement dans chaque épisode (ou peut être initialisé par l'agent en un seul tour de 3 commandes viarungv), les rollouts RL ne gaspillent ni tokens de fenêtre de contexte ni budgets d'étapes à résoudre les échecs deservice docker startliés àulimit, les erreursiptables-nftou les rejetspivot_rootderunc. Chaque token de la trajectoire est consacré à la résolution de la tâche réelle d'ingénierie logicielle.
Sécurité sans privilège pour les rollouts d'agents non fiables : Chaque épisode
gvxverrouille son propre processus OS hôte avant d'exécuter le code invité (PR_SET_NO_NEW_PRIVS+seccompBPF sous Linux,deny defaultSeatbelt sous macOS, Restricted Token + Job Object sous Windows). Même si un agent RL exécutedocker run --privilegedou des commandes destructricesrm -rf /au sein de son épisode, ces opérations restent strictement confinées au noyauSentryen espace utilisateur de cet épisode et à son fichier de volume.ext4éphémère.
Architecture de rollout : instances parallèles non privilégiées + snapshots reflink
Dans gvx, chaque worker de rollout est un processus OS ordinaire et non privilégié, doté de son propre noyau gVisor Sentry, de son propre netstack en espace utilisateur (10.0.2.15/24) et de son propre volume bloc ext4lite (ep-N.ext4), tout en partageant un cache d'images OCI erofs en lecture seule et adressé par contenu, via le page cache de l'hôte.
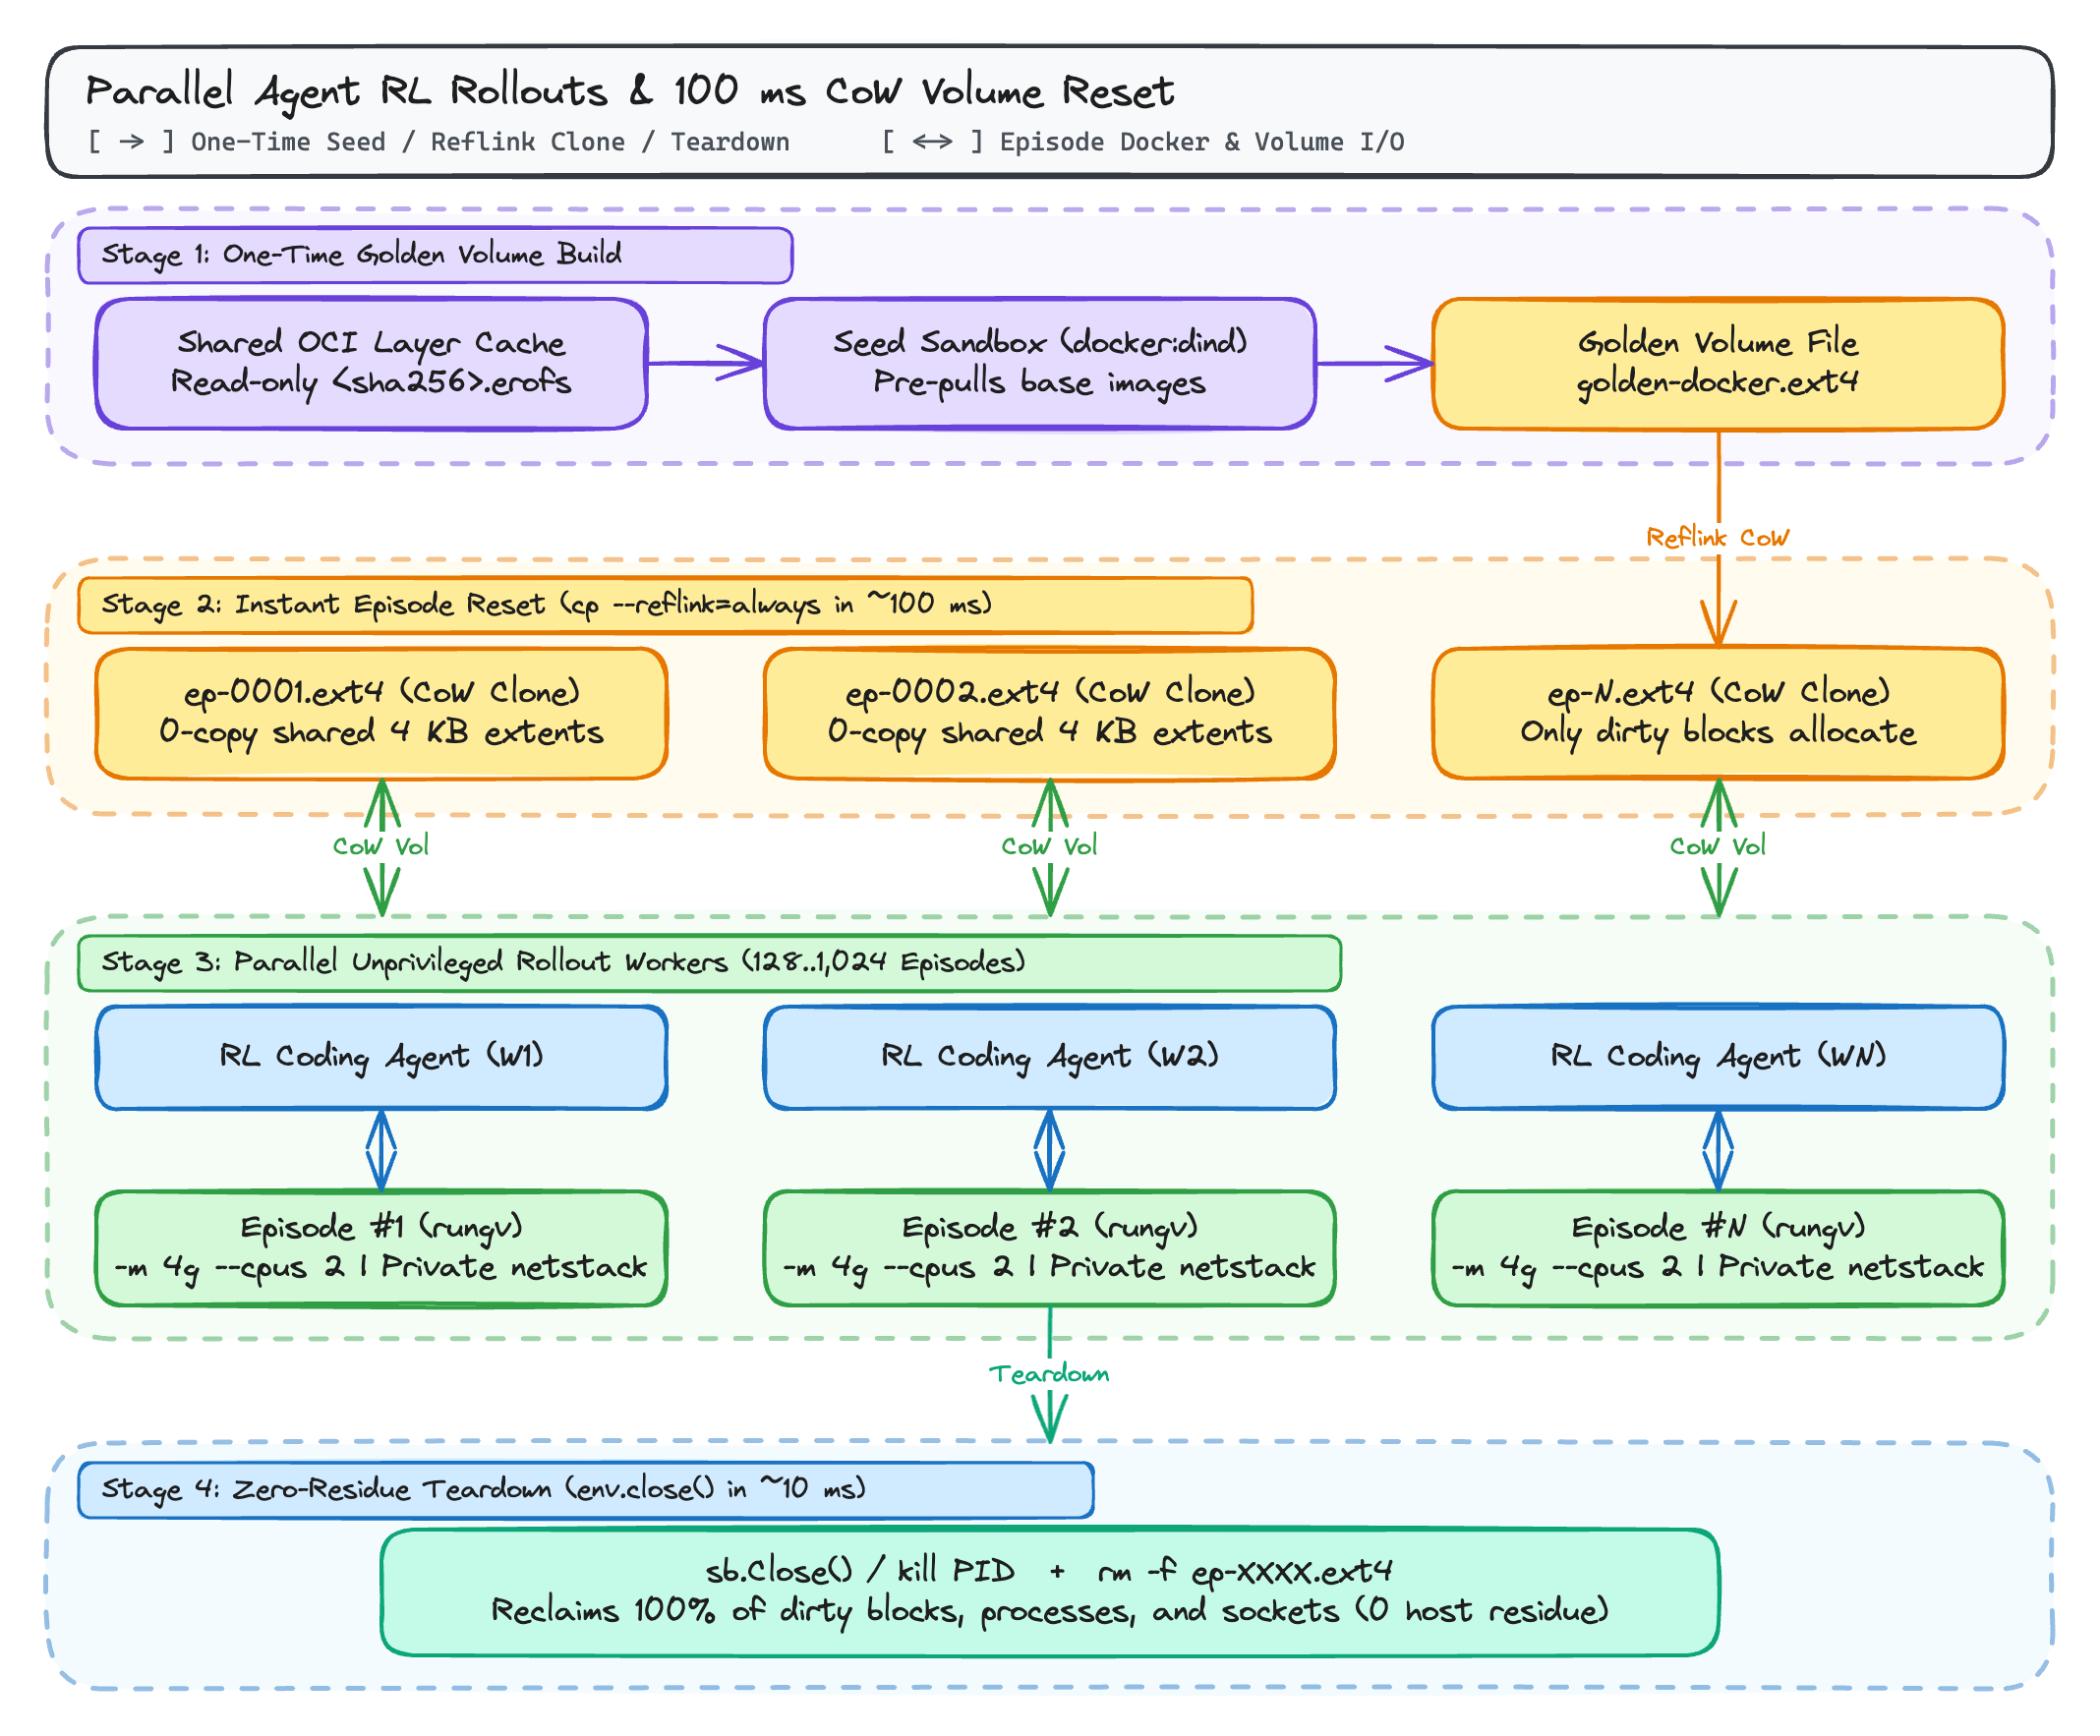
Pourquoi les volumes ext4lite à fichier unique transforment l'économie de réinitialisation RL
Parce que le système de fichiers ext4lite de gvx stocke un volume ext4 complet avec journal JBD2 (incluant les répertoires de couches overlayfs de Docker, les attributs étendus trusted.overlay.*, les nœuds de périphériques whiteout et les métadonnées d'images) dans un seul fichier ordinaire de l'hôte, la gestion du cycle de vie d'un épisode se réduit à une seule opération sur fichier :
- Réinitialisation
env.reset()en 100 millisecondes viacp --reflink=always:- Vous construisez une fois un fichier
golden-docker.ext4contenant des images de base pré-téléchargées (python:3.11,postgres:16,redis:7, ou des images de baseSWE-benchpropres à la tâche). - Au début de chaque épisode RL,
cp --reflink=always golden-docker.ext4 ep-0042.ext4(sur XFS, Btrfs, ZFS ou macOS APFS) crée en moins de 100 millisecondes un clone indépendant en copy-on-write, sans copier les blocs disque sous-jacents. - Seuls les blocs de 4 KiB modifiés pendant cet épisode précis consomment de l'espace disque supplémentaire.
- Vous construisez une fois un fichier
- Démantèlement sans résidu (
env.close()) :- Terminer le processus
rungv(sb.Close()en Go) et supprimerep-0042.ext4récupère 100 % des processus, sockets réseau, montages et stockage de l'épisode en environ 10 millisecondes. Rien n'est jamais monté dans la table de montage du noyau hôte ni enregistré dans les cgroups de l'hôte.
- Terminer le processus
Flux de travail pas à pas : snapshot .ext4 doré et réinitialisation rapide d'épisode
Vous pouvez installer rungv sur chaque nœud worker de rollout, soit en téléchargeant le binaire précompilé attesté SLSA depuis GitHub Releases (gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml --deny-self-hosted-runners), soit en exécutant CGO_ENABLED=0 go install z.gfire.dev/gvx/cmd/rungv@latest.
Étape 1 : créer le volume docker:dind doré une seule fois
 1mkdir -p /srv/rl-snapshots /srv/rl-episodes
 2
 3# 1. Démarrer une instance docker:dind de départ adossée à golden-docker.ext4
 4rungv run \
 5  -p unix:/srv/rl-snapshots/seed.sock:2375 \
 6  --mount type=volume,src=/srv/rl-snapshots/golden-docker.ext4,dst=/var/lib/docker \
 7  -e DOCKER_TLS_CERTDIR= \
 8  docker:dind --tls=false &
 9SEED_PID=$!
10
11# 2. Pré-remplir les images de base et le cache de build dans golden-docker.ext4
12export DOCKER_HOST="unix:///srv/rl-snapshots/seed.sock"
13until docker info >/dev/null 2>&1; do sleep 0.5; done
14
15docker pull python:3.11-slim
16docker pull redis:7-alpine
17docker pull postgres:16-alpine
18
19# 3. Arrêter proprement l'instance de départ afin qu'ext4lite vide ses tampons et compacte l'image
20kill -INT $SEED_PID
21wait $SEED_PID
Étape 2 : lancer des épisodes RL parallèles en 100 millisecondes
Chaque worker de rollout parallèle clone golden-docker.ext4 via reflink et démarre une instance docker:dind isolée dont toutes les images sont déjà présentes dans /var/lib/docker :
 1EPISODE_ID="ep-0042"
 2SOCK="/srv/rl-episodes/${EPISODE_ID}.sock"
 3
 4# Clone instantané en copy-on-write (~100 ms sur XFS/Btrfs/APFS)
 5cp --reflink=always \
 6  /srv/rl-snapshots/golden-docker.ext4 \
 7  "/srv/rl-episodes/${EPISODE_ID}.ext4"
 8
 9# Lancer un épisode isolé et non privilégié avec 4 GiB de RAM et 2 CPU
10rungv run \
11  -m 4g --cpus 2 \
12  -p "unix:${SOCK}:2375" \
13  --mount "type=volume,src=/srv/rl-episodes/${EPISODE_ID}.ext4,dst=/var/lib/docker" \
14  -e DOCKER_TLS_CERTDIR= \
15  docker:dind --tls=false &
16EP_PID=$!
17
18export DOCKER_HOST="unix://${SOCK}"
19until docker info >/dev/null 2>&1; do sleep 0.2; done
20
21# Dans le worker de rollout, les images sont immédiatement disponibles sans téléchargement réseau
22docker images
23
24# Démantèlement de l'épisode après le calcul de la récompense (~10 ms)
25kill -KILL $EP_PID
26rm -f "/srv/rl-episodes/${EPISODE_ID}.ext4" "${SOCK}"
Pool de rollouts programmatique avec le SDK Go z.gfire.dev/gvx/pkg/gvx
Si votre serveur d'environnements RL ou votre harnais d'évaluation est écrit en Go (ou appelle un démon de rollout Go via gRPC), vous pouvez gérer directement des épisodes de conteneurs parallèles via z.gfire.dev/gvx/pkg/gvx :
 1package main
 2
 3import (
 4	"bytes"
 5	"context"
 6	"fmt"
 7	"log"
 8	"os"
 9	"os/exec"
10	"path/filepath"
11	"time"
12
13	"z.gfire.dev/gvx/pkg/gvx"
14)
15
16func runEpisode(ctx context.Context, goldenExt4, scratchDir string, epID int) error {
17	epExt4 := filepath.Join(scratchDir, fmt.Sprintf("ep-%04d.ext4", epID))
18	defer os.Remove(epExt4)
19
20	// 1. Cloner par reflink le volume ext4lite doré
21	cpCmd := exec.CommandContext(ctx, "cp", "--reflink=always", goldenExt4, epExt4)
22	if err := cpCmd.Run(); err != nil {
23		return fmt.Errorf("clone golden volume: %w", err)
24	}
25
26	// 2. Appliquer un délai d'expiration horloge murale par épisode
27	epCtx, cancel := context.WithTimeout(ctx, 2*time.Minute)
28	defer cancel()
29
30	var stdout, stderr bytes.Buffer
31	sb, err := gvx.New(epCtx, gvx.Config{
32		Platform:               gvx.PlatformAuto,
33		NetworkMode:            gvx.NetModeNAT,
34		NetRaw:                 true,
35		AllowPacketSocketWrite: true,
36		AllowSUID:              true,
37		OCIImage:               "docker:dind",
38		Entrypoint:             []string{"sh", "-c"},
39		EntrypointSet:          true,
40		Cmd: []string{
41			"dockerd-entrypoint.sh --tls=false >/var/log/dockerd.log 2>&1 & " +
42				"until docker info >/dev/null 2>&1; do sleep 0.2; done && " +
43				"docker run --rm python:3.11-slim python -c 'print(6 * 7)'",
44		},
45		Envv: []string{"DOCKER_TLS_CERTDIR="},
46		Mounts: []gvx.Mount{
47			{
48				Kind:      gvx.MountVolume,
49				ImagePath: epExt4,
50				GuestPath: "/var/lib/docker",
51			},
52		},
53		Resources: gvx.Resources{
54			MemoryBytes: 4 << 30, // Plafond de 4 GiB
55			CPUMillis:   2000,    // 2.0 CPU
56		},
57		Stdout: &stdout,
58		Stderr: &stderr,
59	})
60	if err != nil {
61		return fmt.Errorf("init episode %d: %w", epID, err)
62	}
63	defer sb.Close()
64
65	exitCode, err := sb.Run(epCtx)
66	if err != nil {
67		return fmt.Errorf("run episode %d: %w", epID, err)
68	}
69
70	log.Printf("episode %d finished: exit=%d stdout=%q", epID, exitCode, stdout.String())
71	return nil
72}
73
74func main() {
75	ctx := context.Background()
76	if err := runEpisode(ctx, "/srv/rl-snapshots/golden-docker.ext4", "/srv/rl-episodes", 1); err != nil {
77		log.Fatal(err)
78	}
79}
Comparaison des runtimes de sandbox pour agents RL
| Métrique / Exigence | dockerd hôte partagé | docker:dind privilégié | Firecracker / microVM KVM | gVisor standard (runsc) | gvx (rungv / pkg/gvx) |
|---|---|---|---|---|---|
root de l'hôte ou --privileged requis | Oui (docker.sock = root) | Oui (--privileged) | Nécessite /dev/kvm + config TAP | Oui (ou userns + mount) | Non (processus unique sans privilège) |
Fonctionne dans des Pods K8s non privilégiés / runsc existant | Non | Non | Non (pas de /dev/kvm) | Échoue (EBUSY sur seccomp imbriqué) | Oui (repli automatique sur boucle futex) |
Prend en charge docker build et docker compose internes | Partage le démon hôte | Oui | Oui | Échoue sans réglage DinD hôte | Oui (overlayfs sur ext4lite) |
| Isolation réseau par épisode | docker0 / verrou xtables partagés | Espace de noms séparé | NIC de VM séparée | netns séparé | netstack isolé dans le processus |
Latence de réinitialisation à chaud (env.reset()) | 5 s à 30 s (purge conteneur/volume) | 10 s à 60 s (démon à froid) | ~150 ms (snapshot de VM) | 5 s à 20 s | ~100 ms (cp --reflink=always de .ext4) |
| Développement local multiplateforme (Windows / macOS / Linux) | Nécessite une VM Linux | Nécessite une VM Linux | KVM Linux uniquement | Linux uniquement | Natif sur Windows, macOS et Linux |
Lectures complémentaires de cette série
- gvx : exécuter des conteneurs Linux, Docker et Kubernetes dans un seul processus non privilégié : Présentation architecturale complète de
gvxsous Windows (whpx,systrap), macOS (hvf) et Linux (systrap). - Exécuter Docker, docker build et docker compose sans root ni espaces de noms utilisateur : Guide rapide de démarrage en 3 étapes et de dépannage lorsque
sudo,unshare(CLONE_NEWUSER),mount(2)et/dev/fusesont bloqués. - Exécuter Docker-in-Docker dans gVisor et des sandboxes imbriquées avec gvx : Analyse approfondie des raisons pour lesquelles
docker.ioetrunscimbriqué échouent dansgVisor(runsc), et de la manière dontgvxbascule sur la boucle futex_RUN_SYSCALL_LOOPen cas d'EBUSY. - Environnements Docker isolés et rapides pour les rollouts RL d'agents IA avec gvx (cet article)