 GoSuda
Изпълнение на Docker, docker build и docker compose без root права или user namespaces

Бързо решение: Сигурен непривилегирован Docker в три стъпки
Ако работите в заключен Linux контейнер, CI изпълнител, Kubernetes Pod или сандбокс на AI агент за програмиране (например облачна изчислителна среда за агенти), където root, sudo, потребителските именни пространства (unshare(CLONE_NEWUSER)), mount(2) и /dev/fuse са блокирани, gvx (rungv) е сигурното, нискоусилното и ефективно по отношение на токените решение за стартиране на пълен двигател docker:dind в потребителското пространство.
Нискоусилно и ефективно по отношение на токените решение за AI агенти за програмиране: Когато автономен агент за програмиране получи
Cannot connect to the Docker daemon, опитът да се инсталират и поправятdocker.io,podmanилиrootlesskitв ограничен контейнер обикновено отнема между 15 и 30 извиквания на инструменти и десетки хиляди контекстни токена, докато се преминава през грешки вsystemctl,ulimit,iptables,unshareиrunc, които в крайна сметка водят до неуспех или до ръчно пренаписване наDockerfile. Сgvx(rungv) агентът изпълнява един детерминистичен тристъпков начален процес в едно извикване и незабавно изпълнява стандартните командиdocker build,docker runиdocker composeбез промени.
Защо
gvxе безопасен по замисъл (не е заобиколно решение за ескалация на привилегии): За разлика от монтирането на хостовия/var/run/docker.sockили изпълнението наdocker run --privileged(които дават контрол, еквивалентен на root, над хостовото ядро),gvxне заобикаля и не отслабва никаква политика за сигурност на хоста (PR_SET_NO_NEW_PRIVS,seccomp, AppArmor или ограниченията на непривилегирования UID). Вместо товаrungvзаключва собствения си хостов процес (PR_SET_NO_NEW_PRIVSи строг BPFseccompсписък с разрешени системни извиквания) и изпълняваdockerdв потребителското ядроgVisor (Sentry)на Google, написано на безопасен по отношение на паметта език. Всички UID 0 възможности на гост системата, монтиранията наoverlayfs(ext4lite) и правилата наiptablesостават строго изолирани в рамките на сандбокс процеса.
 1# 1. Инсталирайте rungv в потребителското пространство (предварително компилирано издание с SLSA атестация или go install)
 2# Опция A: Проверете и разархивирайте предварително компилирания двоичен файл с SLSA атестация от GitHub Releases
 3gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx \
 4  --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml \
 5  --source-ref refs/tags/v0.2.0 --deny-self-hosted-runners
 6tar -xzf rungv-v0.2.0-linux-amd64.tar.gz && install -m 0755 rungv-v0.2.0-linux-amd64/rungv ~/.local/bin/rungv
 7
 8# Опция B: Или инсталирайте директно от изходния код с Go
 9CGO_ENABLED=0 GOBIN=~/.local/bin go install z.gfire.dev/gvx/cmd/rungv@latest
10
11# 2. Стартирайте docker:dind в gvx с единичен ext4lite том във файл
12#    Пренасочва ~/.gvx/docker.sock (режим 0600) към порт 2375 на гост системата
13mkdir -p ~/.gvx
14~/.local/bin/rungv run \
15  -p unix:~/.gvx/docker.sock:2375 \
16  -p 127.0.0.1:9000-9019:9000-9019 \
17  -v gvx-docker:/var/lib/docker \
18  -e DOCKER_TLS_CERTDIR= \
19  docker:dind --tls=false &
20
21# 3. Насочете стандартния Docker CLI и Docker Compose към сокета в потребителското пространство
22export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
23until docker info >/dev/null 2>&1; do sleep 0.5; done
24docker info --format '{{.Driver}} {{.OperatingSystem}}'
25# Изход: overlayfs Alpine Linux ... (containerized)
26
27docker build -t app:test .
28docker run --rm app:test
29docker compose up -d
Защо стандартните инструменти без root се провалят в ограничени сандбокс среди
Когато инженер или автономен агент за програмиране трябва да изпълни docker build, docker run или docker compose в закалени контейнер или многопотребителски изпълнител, стандартните заобиколни решения се провалят при пет различни бариери на ядрото.
1. Няма хостов сокет на Docker демона (systemctl и service docker start също се провалят)
Изпълнението на docker ps или docker build се проваля незабавно, когато хостовият /var/run/docker.sock не е монтиран в средата, а опитът за стартиране на docker.io през systemctl или service docker start се проваля, защото PID 1 не е systemd, а /etc/init.d/docker достига до твърдия лимит ulimit -n на контейнера:
1Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
2ERROR: Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
3System has not been booted with systemd as init system (PID 1). Can't operate.
4Failed to connect to bus: Host is down
5/etc/init.d/docker: 62: ulimit: error setting limit (Operation not permitted)
2. PR_SET_NO_NEW_PRIVS блокира sudo и помощните програми с setuid
Закалените контейнери (securityContext.allowPrivilegeEscalation: false в Kubernetes, --security-opt=no-new-privileges в Docker или сандбокси exebox / bwrap) задават бита PR_SET_NO_NEW_PRIVS на Linux за дървото от процеси. Опитът за ескалация през sudo или двоични файлове с setuid (newuidmap, newgidmap, fusermount3) се проваля:
1sudo: The "no new privileges" flag is set, which prevents sudo from running as root.
2sudo: effective uid is not 0, is /usr/bin/sudo on a file system with the 'nosuid' option set or an NFS file system without root privileges?
3. Политиките на seccomp и sysctl блокират unshare(CLONE_NEWUSER)
Инструментите, рекламирани като „rootless“ (Rootless Docker, Podman, Buildah, nerdctl, bubblewrap), все още разчитат на потребителски именни пространства на Linux (CLONE_NEWUSER). Те се провалят, когато:
- Типичният seccomp профил на външния контейнер блокира
unshare(2)илиclone(CLONE_NEWUSER). - Ubuntu 24.04+ включва
kernel.apparmor_restrict_unprivileged_userns = 1. - Възлите на Debian или RHEL задават
kernel.unprivileged_userns_clone = 0илиuser.max_user_namespaces = 0. newuidmapне може да записва в/proc/self/uid_map, защотоPR_SET_NO_NEW_PRIVSе активен.
Получените грешки изглеждат така:
1unshare: unshare failed: Operation not permitted
2cannot clone: Operation not permitted
3Error: cannot re-exec process to join the existing user namespace
4newuidmap: write to uid_map failed: Operation not permitted
5RootlessKit: parent: failed to start the child: fork/exec /proc/self/exe: operation not permitted
4. mount(2) и pivot_root(2) са блокирани по време на docker build без хостов CAP_SYS_ADMIN
Дори когато средата позволява CLONE_NEWUSER или dockerd се стартира принудително с --iptables=false --bridge=none --storage-driver=vfs, изпълнението на docker build се проваля при първата инструкция RUN, защото монтирането на нов /proc или извикването на pivot_root(2) във вложено пространство за монтиране е блокирано:
1ERROR: failed to solve: process "/bin/sh -c ..." did not complete successfully:
2mount("/proc", "/proc", "proc", MS_NOSUID|MS_NODEV|MS_NOEXEC, NULL): Operation not permitted
3OCI runtime create failed: runc create failed: unable to start container process: error during container init: error mounting "proc" to rootfs at "/proc": mount proc:/proc (via /proc/self/fd/6), flags: 0xe: operation not permitted
4OCI runtime create failed: runc create failed: unable to start container process: error during container init: error jailing process inside rootfs: pivot_root .: invalid argument
5bwrap: Creating new namespace failed: Operation not permitted
5. Липсата на /dev/fuse чупи fuse-overlayfs
Engine-ите за контейнери без root, които не могат да монтират ядрен overlayfs, преминават към fuse-overlayfs. В минимални контейнери или Kubernetes pod-ове без препредаване на устройството /dev/fuse, fuse-overlayfs се проваля незабавно:
1fuse: device not found, try 'modprobe fuse' first
2fusermount3: failed to open /dev/fuse: No such file or directory
3error initializing graphdriver: driver not supported: fuse-overlayfs
Как gvx изпълнява docker:dind изцяло в потребителското пространство
gvx преодолява и петте бариери на ядрото, защото не изисква от ядрото на хост Linux да създава именни пространства, да монтира файлови системи или да конфигурира мрежови интерфейси. Вместо това rungv изпълнява вътрешно потребителско Linux ядро (Sentry на gVisor) и потребителски мрежов стек (netstack) в един обикновен непривилегирован процес.
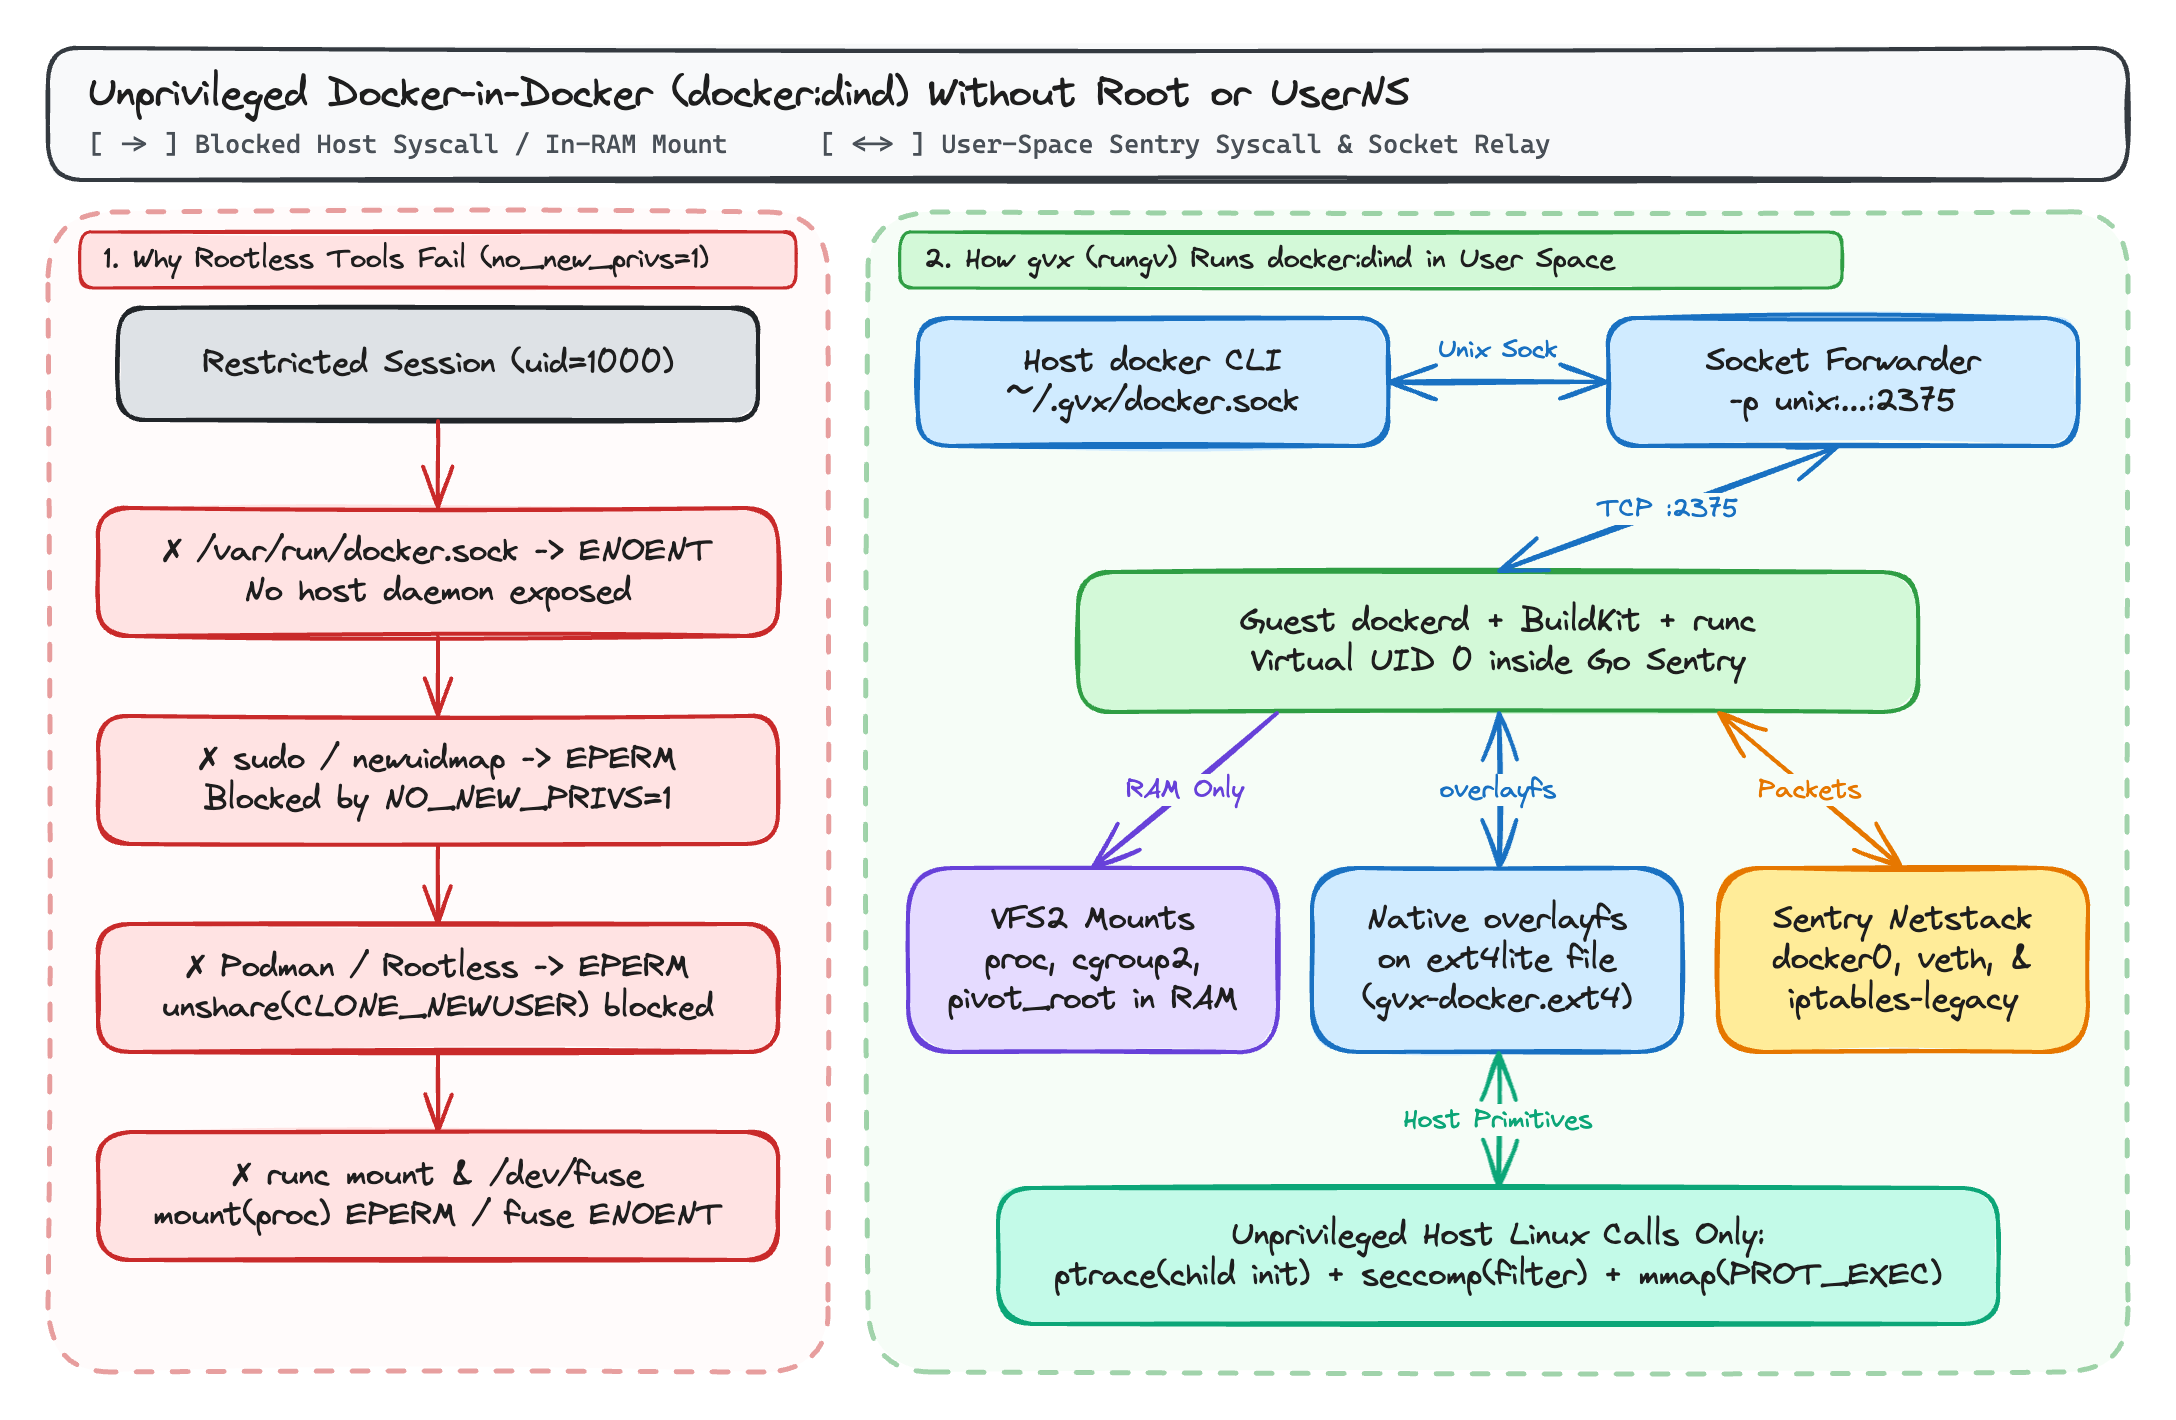
1. Именни пространства и таблица за монтиране в паметта (VFS2)
Когато dockerd, containerd и runc се изпълняват в rungv, systrap прехваща техните системни извиквания и ги насочва към вътрешното ядро Sentry в процеса, а не към ядрото на хоста:
unshare(2),clone(2),pivot_root(2),chroot(2)иmount(2)работят върху йерархията от задачи в паметта на Sentry и таблицата за монтиранеVFS2(procfs,sysfs,tmpfs,devpts,cgroupfsv2), докато хостовият процесrungvработи под вашия непривилегирован хостов UID.
2. Роден overlayfs върху еднофайлови томове ext4lite
Когато подадете -v gvx-docker:/var/lib/docker (или --mount type=volume,src=/disk/gvx-docker.ext4,dst=/var/lib/docker), gvx монтира вградената си файлова система ext4lite в /var/lib/docker.
Тъй като ext4lite реализира файлова система ext4 с журналиране JBD2 във вътрешността на един хостов файл (gvx-docker.ext4), с поддръжка на разширените атрибути trusted.overlay.*, символните устройства за заличаване (0:0), d_type и RENAME_EXCHANGE, dockerd използва своя роден драйвер за съхранение overlayfs в гост системата. Многоетапните операции docker build споделят слоеве Copy-on-Write без /dev/fuse и без експлозията на дисковото пространство, характерна за резервния драйвер vfs на Docker.
3. Мост docker0 в потребителското пространство и iptables-legacy
Когато docker:dind се стартира в gvx:
dockerdв гост системата създава мостаdocker0(172.17.0.1/16), прикачва виртуални двойкиvethза вложените контейнери и програмира веригитеNAT(DOCKER,POSTROUTING) иFILTERс помощта на съвпаденияaddrtypeиconntrackвътре в потребителскияnetstackнаgvx.- Подаването на
-p unix:~/.gvx/docker.sock:2375свързва хостов Unix домейн сокет (режим0600) и пренасочва връзките директно към порт2375наdockerdв сандбокса.
Сравнение с други инструменти за контейнери
| Възможност / Ограничение | Стандартен Docker (dockerd) | Rootless Docker / Podman | Kaniko / Buildah (непривилегировани) | gvx (rungv + docker:dind) |
|---|---|---|---|---|
Изисква хостов root или sudo | Да | Не | Не | Не |
Работи с PR_SET_NO_NEW_PRIVS=1 | Не | Не (newuidmap се проваля) | Частично | Да |
Работи, когато unshare(CLONE_NEWUSER) е блокиран (EPERM) | Не се прилага | Не | Buildah: Не / Kaniko: Да | Да |
Работи без /dev/fuse | Да (използва ядрен overlay2) | Само през бавно копиране vfs | Да | Да (overlayfs върху ext4lite) |
Поддържа docker build (BuildKit) | Да | Да (ако userns е разрешено) | Само изграждане на образи (без изпълнение) | Да |
Поддържа docker run и docker compose up | Да | Да (ако userns е разрешено) | Не | Да |
| Работи на Windows и macOS без Linux VM | Не (изисква WSL2 / VM) | Не (изисква Linux VM) | Не | Да (whpx, hvf, systrap) |
Точни изисквания към хостовото ядро на Linux
gvx изисква нулеви повишени възможности (CapEff: 0000000000000000) и нула потребителски именни пространства. На хост Linux rungv разчита само на три стандартни непривилегировани примитива на ядрото:
ptrace(PTRACE_ATTACH)върху собствената си дъщерна нишка веднъж по време на инициализация:systrapстартира локална помощна нишка-заглушка, прикачва се към нея, за да инициализира контекста със споделена памет, и се отделя. Ако хостът зададеkernel.yama.ptrace_scope = 3(което деактивира всичкиptraceв системата) или блокираptraceвъв външен филтър seccomp, инициализацията наsystrapне може да завърши. (Приyama.ptrace_scope = 1, което е по подразбиране в Ubuntu и Debian,gvxработи успешно, защото проследяването от родител към дете е разрешено.)seccomp(SECCOMP_SET_MODE_FILTER): използва се за прихващане на системните извиквания на гост системата от нишките-заглушки на контейнера. Както е описано в Част 3 от тази серия,gvxработи както когатоSECCOMP_FILTER_FLAG_NEW_LISTENERе наличен, така и когато връщаEBUSYвъв вложен сандбокс.mmap(..., PROT_EXEC, ...): използва се за картиране на ELF сегментите на гост системата и трамплина със споделена памет наsystrap.
Край-до-край пример: Изграждане и тестване на многоконтейнерно приложение без root
Следният скрипт изпълнява пълен docker build и интеграционен тест с два контейнера (redis + контейнер с приложението) в непривилегирована потребителска сесия:
 1mkdir -p ~/.gvx
 2rungv run \
 3  -p unix:~/.gvx/docker.sock:2375 \
 4  -v gvx-docker:/var/lib/docker \
 5  -e DOCKER_TLS_CERTDIR= \
 6  docker:dind --tls=false &
 7DIND_PID=$!
 8
 9export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
10until docker info >/dev/null 2>&1; do sleep 0.5; done
11
12mkdir -p /tmp/demo-app && cd /tmp/demo-app
13cat <<'EOF' > Dockerfile
14FROM alpine:3.20
15RUN apk add --no-cache redis
16CMD ["redis-cli", "-h", "cache", "ping"]
17EOF
18
19# Изградете образа с overlayfs върху ext4lite
20docker build -t demo-ping:latest .
21
22# Създайте мрежа за мост, стартирайте Redis и проверете връзката между контейнерите
23docker network create demo-net
24docker run -d --name cache --network demo-net redis:7-alpine
25docker run --rm --network demo-net demo-ping:latest
26# Изход: PONG
27
28# Почистете работните контейнери и спрете сандбокса
29docker rm -f cache
30docker network rm demo-net
31kill -INT $DIND_PID
Допълнителна литература в тази серия
- gvx: Изпълнение на Linux контейнери, Docker и Kubernetes в един непривилегирован процес: Архитектурен преглед на
gvx, неговите междуплатформени изпълнителни енджини (whpx,hvf,systrap),VFS2(erofs,ext4lite,hostfsv2) иnetstack. - Изпълнение на Docker, docker build и docker compose без root или потребителски именни пространства (тази публикация)
- Изпълнение на Docker-in-Docker в gVisor и вложени сандбокси с gvx: Как
gvxрешаваmodprobe,iptables-nft,overlay2върхуgoferи вложенияSECCOMP_FILTER_FLAG_NEW_LISTENER(EBUSY) вgVisor(runsc). - Бързи изолирани Docker среди за RL rollouts на AI агенти с gvx: Мащабиране на паралелни
SWE-benchи RL rollout среди с 100-милисекундни връщания към състояние на томове.ext4с Copy-on-Write.