 GoSuda
Spouštění Dockeru, docker build a docker compose bez oprávnění root a bez uživatelských jmenných prostorů

Rychlé řešení: Bezpečný neprivilegovaný Docker ve třech krocích
Pokud pracujete uvnitř uzamčeného linuxového kontejneru, CI runneru, Kubernetes Podu nebo sandboxu agenta pro programování s umělou inteligencí (například cloudového výpočetního prostředí agenta), kde jsou blokovány root, sudo, uživatelské jmenné prostory (unshare(CLONE_NEWUSER)), mount(2) a /dev/fuse, je gvx (rungv) bezpečným, nenáročným a úsporným řešením z hlediska tokenů pro spuštění kompletního enginu docker:dind v uživatelském prostoru.
Nenáročné a úsporné řešení z hlediska tokenů pro agenty programující s umělou inteligencí: Když autonomní agent pro programování narazí na
Cannot connect to the Docker daemon, pokus o instalaci a opravudocker.io,podmanneborootlesskituvnitř omezeného kontejneru obvykle spotřebuje 15 až 30 kol volání nástrojů a desítky tisíc tokenů kontextu při zacyklení v chybáchsystemctl,ulimit,iptables,unsharearunc, a nakonec selže nebo se uchýlí k ručnímu přepisováníDockerfile. Sgvx(rungv) agent provede jeden deterministický třístupňový bootstrap v jediném kroku a ihned spustí standardní příkazydocker build,docker runadocker composebeze změny.
Proč je
gvxbezpečný již z principu (nejde o obcházení eskalace oprávnění): Na rozdíl od připojení hostitelského/var/run/docker.socknebo spuštěnídocker run --privileged(které poskytují řízení ekvivalentní rootovi nad jádrem hostitele)gvxneobchází ani neoslabuje žádnou bezpečnostní politiku hostitele (PR_SET_NO_NEW_PRIVS,seccomp, AppArmor ani omezení na neprivilegované UID). Místo tohorungvuzamkne vlastní hostitelský proces (PR_SET_NO_NEW_PRIVS+ přísný BPFseccompallowlist) a spustídockerduvnitř paměťově bezpečného uživatelského jádra gVisor (Sentry) od Googlu. Všechny schopnostiUID 0uvnitř hosta, připojeníoverlayfs(ext4lite) a pravidlaiptableszůstávají přísně izolovány uvnitř procesu sandboxu.
 1# 1. Instalace rungv v uživatelském prostoru (předkompilovaná verze s atestací SLSA nebo go install)
 2# Možnost A: Ověřte a rozbalte předkompilovanou binárku s atestací SLSA z GitHub Releases
 3gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx \
 4  --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml \
 5  --source-ref refs/tags/v0.2.0 --deny-self-hosted-runners
 6tar -xzf rungv-v0.2.0-linux-amd64.tar.gz && install -m 0755 rungv-v0.2.0-linux-amd64/rungv ~/.local/bin/rungv
 7
 8# Možnost B: Nebo nainstalujte přímo ze zdrojového kódu pomocí Go
 9CGO_ENABLED=0 GOBIN=~/.local/bin go install z.gfire.dev/gvx/cmd/rungv@latest
10
11# 2. Spusťte docker:dind uvnitř gvx s jedním souborovým svazkem ext4lite
12#    Přeposílá ~/.gvx/docker.sock (režim 0600) na port 2375 v guest prostředí
13mkdir -p ~/.gvx
14~/.local/bin/rungv run \
15  -p unix:~/.gvx/docker.sock:2375 \
16  -p 127.0.0.1:9000-9019:9000-9019 \
17  -v gvx-docker:/var/lib/docker \
18  -e DOCKER_TLS_CERTDIR= \
19  docker:dind --tls=false &
20
21# 3. Nasměrujte standardní Docker CLI a Docker Compose na socket v uživatelském prostoru
22export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
23until docker info >/dev/null 2>&1; do sleep 0.5; done
24docker info --format '{{.Driver}} {{.OperatingSystem}}'
25# Výstup: overlayfs Alpine Linux ... (v kontejneru)
26
27docker build -t app:test .
28docker run --rm app:test
29docker compose up -d
Proč standardní nástroje pro běh bez root oprávnění selhávají v omezených sandboxech
Když inženýr nebo autonomní agent pro programování potřebuje spustit docker build, docker run nebo docker compose uvnitř zpevněného kontejneru nebo víceuživatelského runneru, standardní obcházení selžou na pěti různých jaderných bariérách.
1. Chybí socket hostitelského Docker démona (systemctl a service docker start také selhávají)
Spuštění docker ps nebo docker build okamžitě selže, pokud není hostitelský /var/run/docker.sock připojen do prostředí. Pokus o spuštění docker.io přes systemctl nebo service docker start selže, protože PID 1 není systemd a /etc/init.d/docker narazí na pevný limit ulimit -n kontejneru:
1Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
2ERROR: Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
3System has not been booted with systemd as init system (PID 1). Can't operate.
4Failed to connect to bus: Host is down
5/etc/init.d/docker: 62: ulimit: error setting limit (Operation not permitted)
2. PR_SET_NO_NEW_PRIVS blokuje sudo a setuid pomocné programy
Zpevněné kontejnery (securityContext.allowPrivilegeEscalation: false v Kubernetes, --security-opt=no-new-privileges v Dockeru nebo sandboxy exebox / bwrap) nastavují bit Linuxu PR_SET_NO_NEW_PRIVS na celém stromu procesů. Pokus o eskalaci přes sudo nebo setuid binárky (newuidmap, newgidmap, fusermount3) selže:
1sudo: The "no new privileges" flag is set, which prevents sudo from running as root.
2sudo: effective uid is not 0, is /usr/bin/sudo on a file system with the 'nosuid' option set or an NFS file system without root privileges?
3. Politiky seccomp a sysctl blokují unshare(CLONE_NEWUSER)
Nástroje propagované jako „rootless“ (Rootless Docker, Podman, Buildah, nerdctl, bubblewrap) stále závisejí na linuxových uživatelských jmenných prostorech (user namespaces, CLONE_NEWUSER). Selžou vždy, když:
- Výchozí profil seccomp vnějšího kontejneru blokuje
unshare(2)neboclone(CLONE_NEWUSER). - Ubuntu 24.04+ aktivuje
kernel.apparmor_restrict_unprivileged_userns = 1. - Uzly Debian nebo RHEL nastaví
kernel.unprivileged_userns_clone = 0nebouser.max_user_namespaces = 0. newuidmapnemůže zapsat do/proc/self/uid_map, protože je aktivníPR_SET_NO_NEW_PRIVS.
Výsledné chyby vypadají takto:
1unshare: unshare failed: Operation not permitted
2cannot clone: Operation not permitted
3Error: cannot re-exec process to join the existing user namespace
4newuidmap: write to uid_map failed: Operation not permitted
5RootlessKit: parent: failed to start the child: fork/exec /proc/self/exe: operation not permitted
4. mount(2) a pivot_root(2) jsou blokovány během docker build bez hostitelské CAP_SYS_ADMIN
I když prostředí povoluje CLONE_NEWUSER nebo je dockerd vynuceně spuštěn s --iptables=false --bridge=none --storage-driver=vfs, spuštění docker build selže už u první instrukce RUN, protože připojení nového /proc nebo volání pivot_root(2) uvnitř vnořeného jmenného prostoru připojení je blokováno:
1ERROR: failed to solve: process "/bin/sh -c ..." did not complete successfully:
2mount("/proc", "/proc", "proc", MS_NOSUID|MS_NODEV|MS_NOEXEC, NULL): Operation not permitted
3OCI runtime create failed: runc create failed: unable to start container process: error during container init: error mounting "proc" to rootfs at "/proc": mount proc:/proc (via /proc/self/fd/6), flags: 0xe: operation not permitted
4OCI runtime create failed: runc create failed: unable to start container process: error during container init: error jailing process inside rootfs: pivot_root .: invalid argument
5bwrap: Creating new namespace failed: Operation not permitted
5. Chybějící /dev/fuse rozbíjí fuse-overlayfs
Rootless enginy kontejnerů, které nemohou připojit jaderný overlayfs, přecházejí na fuse-overlayfs. V minimálních kontejnerech nebo podech Kubernetes bez předání zařízení /dev/fuse fuse-overlayfs selže okamžitě:
1fuse: device not found, try 'modprobe fuse' first
2fusermount3: failed to open /dev/fuse: No such file or directory
3error initializing graphdriver: driver not supported: fuse-overlayfs
Jak gvx spouští docker:dind zcela v uživatelském prostoru
gvx obchází všech pět jaderných bariér, protože nežádá hostitelské jádro Linuxu o vytvoření jmenných prostorů, připojení souborových systémů ani konfiguraci síťových rozhraní. Místo toho rungv spouští interní linuxové jádro v uživatelském prostoru (gVisor Sentry) a síťový zásobník v uživatelském prostoru (netstack) uvnitř jediného běžného neprivilegovaného procesu.
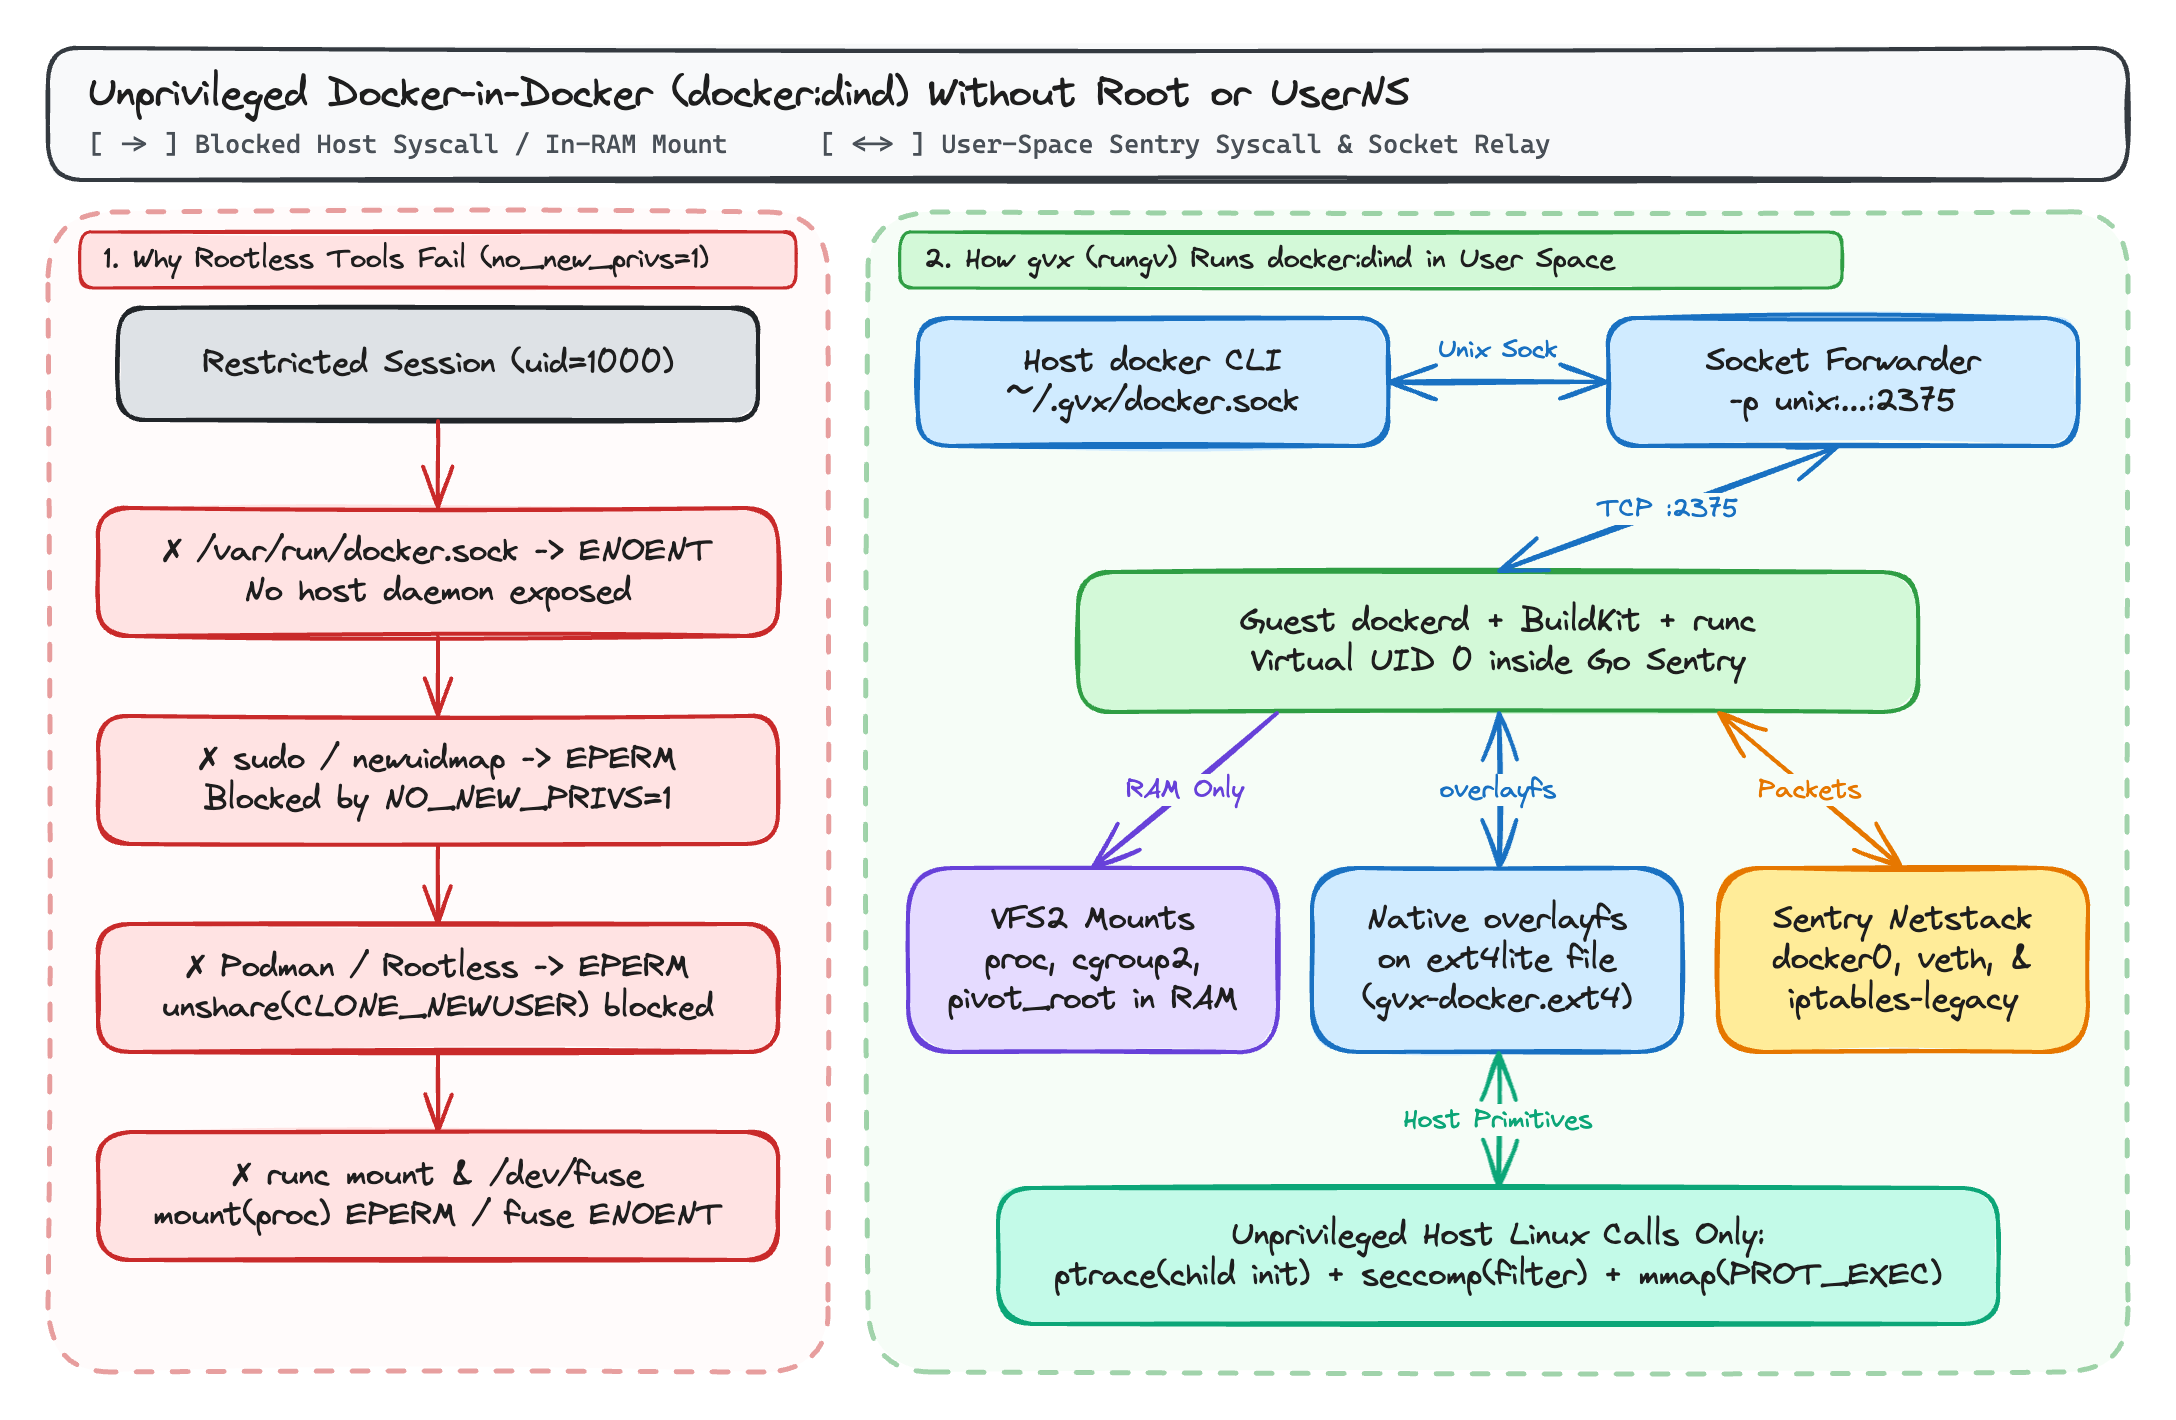
1. Jmenné prostory a tabulka připojení v paměti (VFS2)
Když dockerd, containerd a runc běží uvnitř rungv, systrap zachytává jejich systémová volání a směruje je do procesu jádra Sentry místo hostitelského jádra:
unshare(2),clone(2),pivot_root(2),chroot(2)amount(2)operují nad hierarchií úlohSentryv paměti a tabulkou připojeníVFS2(procfs,sysfs,tmpfs,devpts,cgroupfsv2), zatímco hostitelský procesrungvběží pod vaším neprivilegovaným UID na hostiteli.
2. Nativní overlayfs na jednosouborových svazcích ext4lite
Když předáte -v gvx-docker:/var/lib/docker (nebo --mount type=volume,src=/disk/gvx-docker.ext4,dst=/var/lib/docker), gvx připojí svůj vestavěný souborový systém ext4lite do /var/lib/docker.
Protože ext4lite implementuje souborový systém ext4 s žurnálem JBD2 uvnitř jediného souboru na hostiteli (gvx-docker.ext4) s podporou rozšířených atributů trusted.overlay.*, znakových whiteout zařízení (0:0), d_type a RENAME_EXCHANGE, dockerd používá svůj nativní ovladač úložiště overlayfs uvnitř guest prostředí. Vícestupňové operace docker build sdílejí vrstvy Copy-on-Write bez /dev/fuse a bez explozivního nárůstu využití disku, jaký způsobuje záložní ovladač vfs v Dockeru.
3. Most docker0 v uživatelském prostoru a iptables-legacy
Když docker:dind startuje uvnitř gvx:
- Guest
dockerdvytvoří mostdocker0(172.17.0.1/16), připojí virtuální páryvethpro vnořené kontejnery a naprogramuje řetězceNAT(DOCKER,POSTROUTING) aFILTERs shodamiaddrtypeaconntrackuvnitř uživatelskéhonetstackvgvx. - Předání
-p unix:~/.gvx/docker.sock:2375naváže hostitelský Unix doménový socket (režim0600) a přesměruje spojení přímo na port2375službydockerduvnitř sandboxu.
Srovnání s existujícími nástroji pro kontejnery
| Schopnost / omezení | Standardní Docker (dockerd) | Rootless Docker / Podman | Kaniko / Buildah (neprivilegovaný) | gvx (rungv + docker:dind) |
|---|---|---|---|---|
Vyžaduje hostitelský root nebo sudo | Ano | Ne | Ne | Ne |
Funguje s PR_SET_NO_NEW_PRIVS=1 | Ne | Ne (newuidmap selže) | Částečně | Ano |
Funguje, když je unshare(CLONE_NEWUSER) blokováno (EPERM) | Nelze použít | Ne | Buildah: Ne / Kaniko: Ano | Ano |
Funguje bez /dev/fuse | Ano (používá jaderný overlay2) | Pouze přes pomalou kopii vfs | Ano | Ano (overlayfs na ext4lite) |
Podporuje docker build (BuildKit) | Ano | Ano (pokud je userns povolen) | Pouze sestavení image (bez běhu) | Ano |
Podporuje docker run a docker compose up | Ano | Ano (pokud je userns povolen) | Ne | Ano |
| Běží na Windows a macOS bez linuxové VM | Ne (vyžaduje WSL2 / VM) | Ne (vyžaduje linuxovou VM) | Ne | Ano (whpx, hvf, systrap) |
Přesné požadavky hostitelského jádra na Linuxu
gvx nevyžaduje žádné zvýšené schopnosti (CapEff: 0000000000000000) ani žádné uživatelské jmenné prostory. Na hostiteli Linuxu se rungv spoléhá pouze na tři standardní neprivilegované primitivy jádra:
ptrace(PTRACE_ATTACH)na vlastní potomkové vlákno jednou během inicializace:systrappři startu spustí lokální pomocné stub vlákno, připojí se k němu, aby inicializoval sdílený kontext paměti, a odpojí se. Pokud hostitel nastavíkernel.yama.ptrace_scope = 3(což zakazuje veškerýptracev systému) nebo zablokujeptraceve vnějším filtru seccomp, inicializacesystrapse nemůže dokončit. (Přiyama.ptrace_scope = 1, což je výchozí nastavení na Ubuntu a Debianu,gvxuspěje, protože sledování z rodiče na potomka je povoleno.)seccomp(SECCOMP_SET_MODE_FILTER): Používá se k zachycení systémových volání guest prostředí z vláken stub kontejneru. Jak je popsáno v části 3 této série,gvxfunguje jak tehdy, když je dostupnýSECCOMP_FILTER_FLAG_NEW_LISTENER, tak když vracíEBUSYuvnitř vnořeného sandboxu.mmap(..., PROT_EXEC, ...): Používá se k mapování segmentů ELF guest prostředí a sdíleného trampolínového kódu pamětisystrap.
Kompletní příklad: sestavení a testování vícekontejnerové aplikace bez root oprávnění
Následující skript spustí kompletní docker build a dvoukontejnerový integrační test (redis + aplikační kontejner) uvnitř neprivilegované uživatelské relace:
 1mkdir -p ~/.gvx
 2rungv run \
 3  -p unix:~/.gvx/docker.sock:2375 \
 4  -v gvx-docker:/var/lib/docker \
 5  -e DOCKER_TLS_CERTDIR= \
 6  docker:dind --tls=false &
 7DIND_PID=$!
 8
 9export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
10until docker info >/dev/null 2>&1; do sleep 0.5; done
11
12mkdir -p /tmp/demo-app && cd /tmp/demo-app
13cat <<'EOF' > Dockerfile
14FROM alpine:3.20
15RUN apk add --no-cache redis
16CMD ["redis-cli", "-h", "cache", "ping"]
17EOF
18
19# Sestavte image pomocí overlayfs na ext4lite
20docker build -t demo-ping:latest .
21
22# Vytvořte síť typu bridge, spusťte Redis a ověřte konektivitu mezi kontejnery
23docker network create demo-net
24docker run -d --name cache --network demo-net redis:7-alpine
25docker run --rm --network demo-net demo-ping:latest
26# Výstup: PONG
27
28# Odstraňte pracovní kontejnery a zastavte sandbox
29docker rm -f cache
30docker network rm demo-net
31kill -INT $DIND_PID
Další čtení v této sérii
- gvx: Spouštění linuxových kontejnerů, Dockeru a Kubernetes v jediném neprivilegovaném procesu: Architektonický přehled
gvx, jeho multiplatformní běhová prostředí (whpx,hvf,systrap),VFS2(erofs,ext4lite,hostfsv2) anetstack. - Spouštění Dockeru, docker build a docker compose bez root oprávnění nebo uživatelských jmenných prostorů (tento příspěvek)
- Spouštění Docker-in-Docker uvnitř gVisor a vnořených sandboxů pomocí gvx: Jak
gvxřešímodprobe,iptables-nft,overlay2nagofera vnořenýSECCOMP_FILTER_FLAG_NEW_LISTENER(EBUSY) uvnitřgVisor(runsc). - Rychlá izolovaná Docker prostředí pro RL rollouty agentů s gvx: Škálování paralelních prostředí
SWE-bencha RL rolloutů se 100milisekundovými resety svazků.ext4pomocí Copy-on-Write.