 GoSuda
Docker, docker build en docker compose uitvoeren zonder root of user namespaces

Snelle oplossing: veilig onbevoegd Docker in drie stappen
Als je werkt binnen een vergrendelde Linux-container, CI-runner, Kubernetes Pod of AI-coding-agent-sandbox (zoals een cloud agent compute-omgeving) waar root, sudo, user namespaces (unshare(CLONE_NEWUSER)), mount(2) en /dev/fuse geblokkeerd zijn, is gvx (rungv) de veilige, weinig inspanning vergende en tokenefficiënte oplossing om een volledige docker:dind-engine in user space te draaien.
Weinig inspanning vergende, tokenefficiënte oplossing voor AI-coding-agents: Wanneer een autonome coding-agent
Cannot connect to the Docker daemontegenkomt, kost het proberen omdocker.io,podmanofrootlesskitin een beperkte container te installeren en aan te passen doorgaans 15 tot 30 tool-call-beurten en tienduizenden contexttokens, waarbij fouten metsystemctl,ulimit,iptables,unshareenruncworden doorlopen, om vervolgens te mislukken of terug te vallen op het handmatig herschrijven vanDockerfiles. Metgvx(rungv) voert de agent één deterministische bootstrap in drie stappen in één beurt uit en draait hij direct de standaardcommando'sdocker build,docker runendocker composeongewijzigd.
Waarom
gvxveilig is by design (geen workaround voor privilegescalatie): In tegenstelling tot het mounten van de host/var/run/docker.sockof het uitvoeren vandocker run --privileged(die root-equivalente controle over de host-kernel verlenen), omzeilt of verzwaktgvxgeen enkel hostbeveiligingsbeleid (PR_SET_NO_NEW_PRIVS,seccomp, AppArmor of niet-root UID-beperkingen). In plaats daarvan vergrendeltrungvzijn eigen hostproces (PR_SET_NO_NEW_PRIVS+ strikte BPFseccomp-allowlist) en draaitdockerdbinnen Google's geheugenveilige gVisor (Sentry) user-space-kernel. AlleUID 0-capabilities van de gast,overlayfs-mounts (ext4lite) eniptables-regels blijven strikt geïsoleerd binnen het sandboxproces.
 1# 1. Installeer rungv in user space (vooraf gebouwde SLSA-geattesteerde release of go install)
 2# Optie A: Verifieer en pak de SLSA-geattesteerde vooraf gebouwde binary uit GitHub Releases uit
 3gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx \
 4  --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml \
 5  --source-ref refs/tags/v0.2.0 --deny-self-hosted-runners
 6tar -xzf rungv-v0.2.0-linux-amd64.tar.gz && install -m 0755 rungv-v0.2.0-linux-amd64/rungv ~/.local/bin/rungv
 7
 8# Optie B: Of installeer rechtstreeks vanuit de broncode met Go
 9CGO_ENABLED=0 GOBIN=~/.local/bin go install z.gfire.dev/gvx/cmd/rungv@latest
10
11# 2. Start docker:dind binnen gvx met een enkelbestands ext4lite-volume
12#    Stuurt ~/.gvx/docker.sock (modus 0600) door naar gastpoort 2375
13mkdir -p ~/.gvx
14~/.local/bin/rungv run \
15  -p unix:~/.gvx/docker.sock:2375 \
16  -p 127.0.0.1:9000-9019:9000-9019 \
17  -v gvx-docker:/var/lib/docker \
18  -e DOCKER_TLS_CERTDIR= \
19  docker:dind --tls=false &
20
21# 3. Wijs de standaard Docker CLI en Docker Compose naar de user-space socket
22export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
23until docker info >/dev/null 2>&1; do sleep 0.5; done
24docker info --format '{{.Driver}} {{.OperatingSystem}}'
25# Uitvoer: overlayfs Alpine Linux ... (containerized)
26
27docker build -t app:test .
28docker run --rm app:test
29docker compose up -d
Waarom standaard rootless-tools falen in beperkte sandboxes
Wanneer een engineer of autonome coding-agent docker build, docker run of docker compose moet draaien binnen een geharde container of multi-tenant runner, falen standaardworkarounds op vijf afzonderlijke kernelbarrières.
1. Geen host-Docker-daemonsocket (systemctl en service docker start falen ook)
docker ps of docker build faalt direct wanneer de host /var/run/docker.sock niet in de omgeving is gemount, en het starten van docker.io via systemctl of service docker start faalt omdat PID 1 geen systemd is en /etc/init.d/docker de harde ulimit -n-limiet van de container raakt:
1Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
2ERROR: Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
3System has not been booted with systemd as init system (PID 1). Can't operate.
4Failed to connect to bus: Host is down
5/etc/init.d/docker: 62: ulimit: error setting limit (Operation not permitted)
2. PR_SET_NO_NEW_PRIVS blokkeert sudo en setuid-helpers
Geharde containers (securityContext.allowPrivilegeEscalation: false in Kubernetes, --security-opt=no-new-privileges in Docker, of exebox- / bwrap-sandboxes) zetten de Linux PR_SET_NO_NEW_PRIVS-bit op de procesboom. Pogingen om te escaleren via sudo of setuid-binaries (newuidmap, newgidmap, fusermount3) mislukken:
1sudo: The "no new privileges" flag is set, which prevents sudo from running as root.
2sudo: effective uid is not 0, is /usr/bin/sudo on a file system with the 'nosuid' option set or an NFS file system without root privileges?
3. Seccomp- en sysctl-beleid blokkeert unshare(CLONE_NEWUSER)
Tools die als "rootless" bekendstaan (Rootless Docker, Podman, Buildah, nerdctl, bubblewrap) vertrouwen nog steeds op Linux user namespaces (CLONE_NEWUSER). Ze falen wanneer:
- Het standaard seccomp-profiel van de buitenste container
unshare(2)ofclone(CLONE_NEWUSER)blokkeert. - Ubuntu 24.04+
kernel.apparmor_restrict_unprivileged_userns = 1inschakelt. - Debian- of RHEL-nodes
kernel.unprivileged_userns_clone = 0ofuser.max_user_namespaces = 0instellen. newuidmapniet kan schrijven naar/proc/self/uid_mapomdatPR_SET_NO_NEW_PRIVSactief is.
De resulterende fouten zien er als volgt uit:
1unshare: unshare failed: Operation not permitted
2cannot clone: Operation not permitted
3Error: cannot re-exec process to join the existing user namespace
4newuidmap: write to uid_map failed: Operation not permitted
5RootlessKit: parent: failed to start the child: fork/exec /proc/self/exe: operation not permitted
4. mount(2) en pivot_root(2) worden geblokkeerd tijdens docker build zonder host-CAP_SYS_ADMIN
Zelfs wanneer een omgeving CLONE_NEWUSER toestaat of dockerd gedwongen wordt te starten met --iptables=false --bridge=none --storage-driver=vfs, faalt docker build bij de eerste RUN-instructie, omdat het mounten van een nieuwe /proc of het aanroepen van pivot_root(2) binnen een geneste mount-namespace wordt geblokkeerd:
1ERROR: failed to solve: process "/bin/sh -c ..." did not complete successfully:
2mount("/proc", "/proc", "proc", MS_NOSUID|MS_NODEV|MS_NOEXEC, NULL): Operation not permitted
3OCI runtime create failed: runc create failed: unable to start container process: error during container init: error mounting "proc" to rootfs at "/proc": mount proc:/proc (via /proc/self/fd/6), flags: 0xe: operation not permitted
4OCI runtime create failed: runc create failed: unable to start container process: error during container init: error jailing process inside rootfs: pivot_root .: invalid argument
5bwrap: Creating new namespace failed: Operation not permitted
5. Ontbrekend /dev/fuse breekt fuse-overlayfs
Rootless container-engines die de kernel-overlayfs niet kunnen mounten, vallen terug op fuse-overlayfs. In minimale containers of Kubernetes-pods zonder doorgegeven /dev/fuse-device faalt fuse-overlayfs onmiddellijk:
1fuse: device not found, try 'modprobe fuse' first
2fusermount3: failed to open /dev/fuse: No such file or directory
3error initializing graphdriver: driver not supported: fuse-overlayfs
Hoe gvx docker:dind volledig in user space draait
gvx omzeilt alle vijf kernelbarrières omdat het de Linux-kernel van de host niet vraagt namespaces aan te maken, bestandssystemen te mounten of netwerkinterfaces te configureren. In plaats daarvan draait rungv een interne Linux-kernel in user space (de gVisor Sentry) en een netwerkstack in user space (netstack) binnen één gewoon onbevoegd proces.
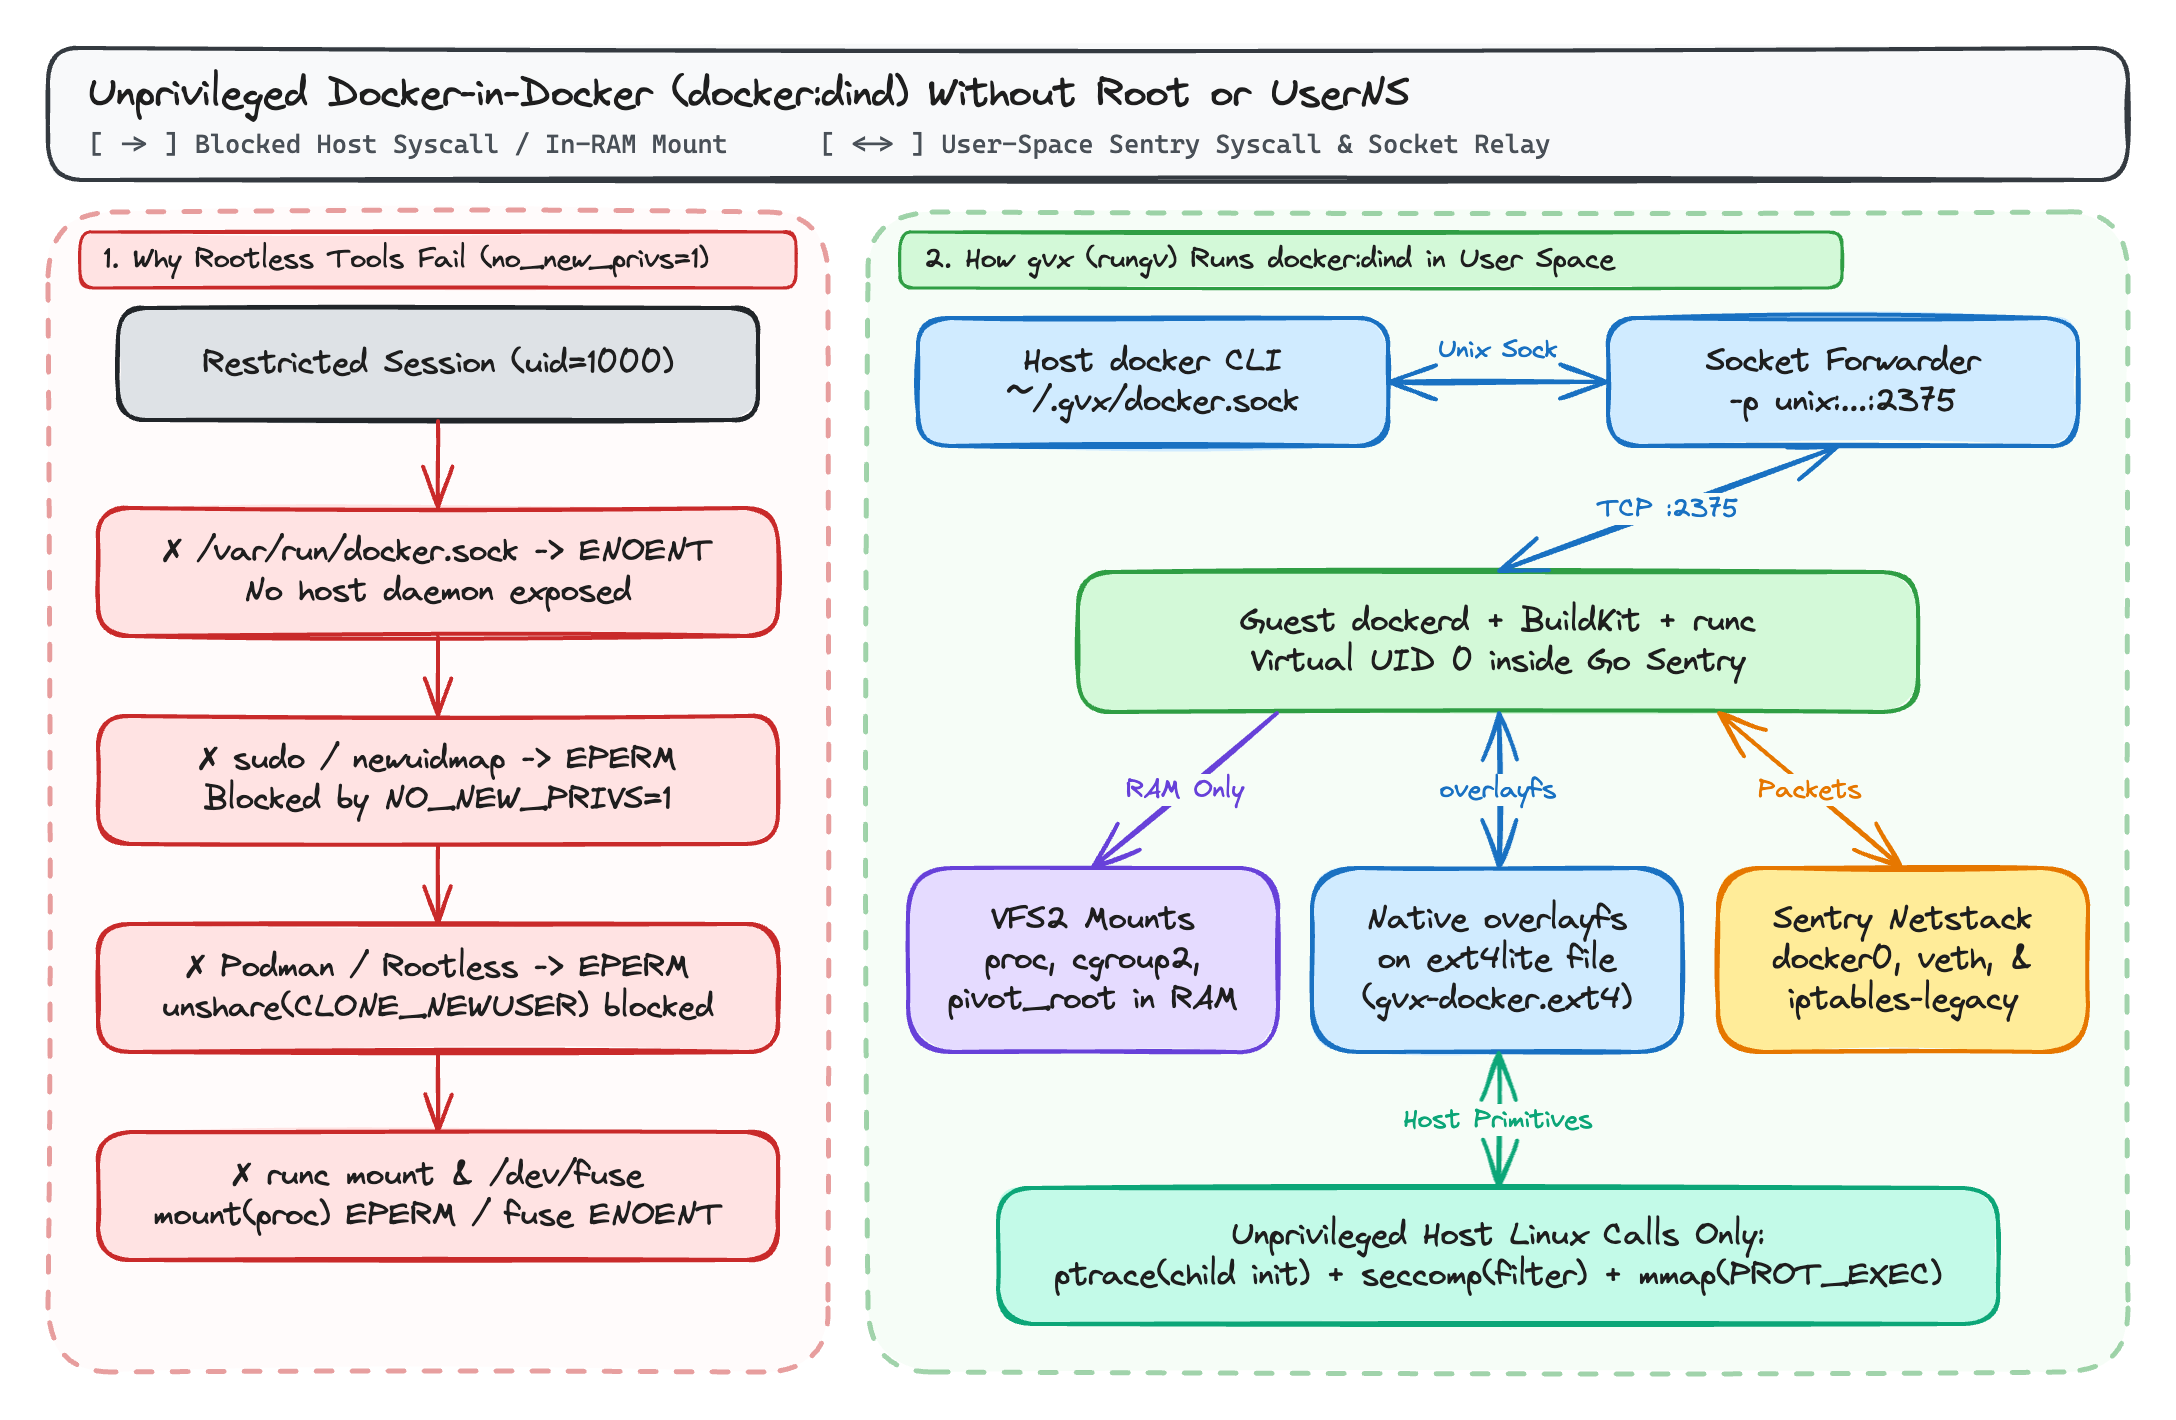
1. In-memory namespaces en mounttabel (VFS2)
Wanneer dockerd, containerd en runc binnen rungv worden uitgevoerd, onderschept systrap hun systeemaanroepen en routeert deze naar de in-process Sentry-kernel in plaats van naar de host-kernel:
unshare(2),clone(2),pivot_root(2),chroot(2)enmount(2)opereren op de in-memory taakhiërarchie van de Sentry en deVFS2-mounttabel (procfs,sysfs,tmpfs,devpts,cgroupfsv2), terwijl het hostprocesrungvdraait onder je onbevoegde host-UID.
2. Native overlayfs op enkelbestands-ext4lite-volumes
Wanneer je -v gvx-docker:/var/lib/docker doorgeeft (of --mount type=volume,src=/disk/gvx-docker.ext4,dst=/var/lib/docker), mount gvx het ingebouwde ext4lite-bestandssysteem op /var/lib/docker.
Omdat ext4lite een JBD2-journaled ext4-bestandssysteem implementeert binnen één hostbestand (gvx-docker.ext4), met ondersteuning voor trusted.overlay.*-extended attributes, character whiteout-devices (0:0), d_type en RENAME_EXCHANGE, gebruikt dockerd in de gast zijn native overlayfs-storage-driver. Multi-stage docker build-operaties delen Copy-on-Write-lagen zonder /dev/fuse en zonder de schijfruimte-explosie van de vfs-fallbackdriver van Docker.
3. User-space docker0-bridge en iptables-legacy
Wanneer docker:dind binnen gvx start:
- Gast-
dockerdmaakt dedocker0-bridge (172.17.0.1/16), koppelt virtueleveth-paren voor geneste containers en programmeertNAT- (DOCKER,POSTROUTING) enFILTER-chains metaddrtype- enconntrack-matches binnen de user-spacenetstackvangvx. - Met
-p unix:~/.gvx/docker.sock:2375wordt een Unix domain socket op de host gebonden (modus0600) en worden verbindingen rechtstreeks doorgestuurd naar poort2375vandockerdbinnen de sandbox.
Vergelijking met bestaande containertools
| Mogelijkheid / Beperking | Standaard Docker (dockerd) | Rootless Docker / Podman | Kaniko / Buildah (onbevoegd) | gvx (rungv + docker:dind) |
|---|---|---|---|---|
Host root of sudo vereist | Ja | Nee | Nee | Nee |
Werkt met PR_SET_NO_NEW_PRIVS=1 | Nee | Nee (newuidmap faalt) | Gedeeltelijk | Ja |
Werkt wanneer unshare(CLONE_NEWUSER) is geblokkeerd (EPERM) | N.v.t. | Nee | Buildah: Nee / Kaniko: Ja | Ja |
Werkt zonder /dev/fuse | Ja (gebruikt kernel overlay2) | Alleen via trage vfs-kopie | Ja | Ja (overlayfs op ext4lite) |
Ondersteunt docker build (BuildKit) | Ja | Ja (als userns is toegestaan) | Alleen image-build (geen runtime) | Ja |
Ondersteunt docker run en docker compose up | Ja | Ja (als userns is toegestaan) | Nee | Ja |
| Draait op Windows en macOS zonder Linux-VM | Nee (vereist WSL2 / VM) | Nee (vereist Linux-VM) | Nee | Ja (whpx, hvf, systrap) |
Exacte hostkernelvereisten op Linux
gvx vereist nul verhoogde capabilities (CapEff: 0000000000000000) en nul user namespaces. Op een Linux-host vertrouwt rungv op slechts drie standaard onbevoegde kernelprimitieven:
ptrace(PTRACE_ATTACH)op de eigen childthread, eenmalig tijdens initialisatie:systrapstart bij het opstarten een lokale stub-helperthread, koppelt eraan om de gedeelde-geheugencontext te initialiseren en ontkoppelt daarna. Als de hostkernel.yama.ptrace_scope = 3instelt (wat alleptracesysteembreed uitschakelt) ofptracein een buitenste seccomp-filter blokkeert, kan de initialisatie vansystrapniet worden voltooid. (Onderyama.ptrace_scope = 1, de standaard op Ubuntu en Debian, slaagtgvxomdat tracing van parent naar child is toegestaan.)seccomp(SECCOMP_SET_MODE_FILTER): Gebruikt om systeemaanroepen van de gast op te vangen uit container-stubthreads. Zoals behandeld in Deel 3 van deze serie, werktgvxzowel wanneerSECCOMP_FILTER_FLAG_NEW_LISTENERbeschikbaar is als wanneer hetEBUSYretourneert binnen een geneste sandbox.mmap(..., PROT_EXEC, ...): Gebruikt om ELF-segmenten van de gast en de gedeelde-geheugentrampoline vansystrapte mappen.
End-to-end voorbeeld: een multi-container app bouwen en testen zonder root
Het volgende script voert een volledige docker build en een integratietest met twee containers (redis + applicatiecontainer) uit binnen een onbevoegde gebruikerssessie:
 1mkdir -p ~/.gvx
 2rungv run \
 3  -p unix:~/.gvx/docker.sock:2375 \
 4  -v gvx-docker:/var/lib/docker \
 5  -e DOCKER_TLS_CERTDIR= \
 6  docker:dind --tls=false &
 7DIND_PID=$!
 8
 9export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
10until docker info >/dev/null 2>&1; do sleep 0.5; done
11
12mkdir -p /tmp/demo-app && cd /tmp/demo-app
13cat <<'EOF' > Dockerfile
14FROM alpine:3.20
15RUN apk add --no-cache redis
16CMD ["redis-cli", "-h", "cache", "ping"]
17EOF
18
19# Bouw de image met overlayfs op ext4lite
20docker build -t demo-ping:latest .
21
22# Maak een bridge-netwerk aan, start Redis en verifieer de connectiviteit tussen containers
23docker network create demo-net
24docker run -d --name cache --network demo-net redis:7-alpine
25docker run --rm --network demo-net demo-ping:latest
26# Uitvoer: PONG
27
28# Ruim de workloadcontainers op en stop de sandbox
29docker rm -f cache
30docker network rm demo-net
31kill -INT $DIND_PID
Verder lezen in deze serie
- gvx: Linux-containers, Docker en Kubernetes uitvoeren in één onbevoegd proces: Architectuuroverzicht van
gvx, zijn cross-platform uitvoeringsengines (whpx,hvf,systrap),VFS2(erofs,ext4lite,hostfsv2) ennetstack. - Docker, docker build en docker compose uitvoeren zonder root of user namespaces (dit bericht)
- Docker-in-Docker uitvoeren binnen gVisor en geneste sandboxes met gvx: Hoe
gvxmodprobe,iptables-nft,overlay2opgoferen genesteSECCOMP_FILTER_FLAG_NEW_LISTENER(EBUSY) binnengVisor(runsc) oplost. - Snelle geïsoleerde Docker-omgevingen voor AI-agent RL-rollouts met gvx: Parallelle
SWE-bench- en RL-rolloutomgevingen opschalen met copy-on-write.ext4-volumeresets van 100 milliseconden.