 GoSuda
Esecuzione di Docker, docker build e docker compose senza root o user namespaces

Soluzione rapida: eseguire Docker non privilegiato in tre passaggi
Se si lavora all'interno di un container Linux bloccato, di un runner CI, di un Pod Kubernetes o di una sandbox di un agente di coding basato su IA (ad esempio un ambiente di calcolo cloud per agenti) in cui root, sudo, i user namespace (unshare(CLONE_NEWUSER)), mount(2) e /dev/fuse sono bloccati, gvx (rungv) rappresenta la soluzione sicura, a basso impegno ed efficiente in termini di token per eseguire un intero motore docker:dind in user space.
Soluzione a basso impegno ed efficiente in termini di token per agenti di coding basati su IA: Quando un agente di coding autonomo incontra
Cannot connect to the Docker daemon, tentare di installare e modificaredocker.io,podmanorootlesskitall'interno di un container con restrizioni comporta tipicamente da 15 a 30 turni di chiamate agli strumenti e decine di migliaia di token di contesto a ciclare tra errori disystemctl,ulimit,iptables,unshareerunc, con l'unico risultato di fallire o di ripiegare sulla riscrittura manuale deiDockerfile. Congvx(rungv), l'agente esegue un bootstrap deterministico in 3 passaggi in un unico turno ed esegue immediatamente i comandi standarddocker build,docker runedocker composesenza modifiche.
Perché
gvxè sicuro by design (non è un workaround per l'escalation dei privilegi): A differenza del montaggio del socket host/var/run/docker.socko dell'esecuzione didocker run --privileged(che concedono un controllo equivalente a root sul kernel dell'host),gvxnon aggira né indebolisce alcuna politica di sicurezza dell'host (PR_SET_NO_NEW_PRIVS,seccomp, AppArmor o i limiti di UID non root). Al contrario,rungvblocca il proprio processo host (PR_SET_NO_NEW_PRIVS+ allowlist BPFseccomprigorosa) ed eseguedockerdall'interno del kernel user-space gVisor (Sentry) di Google, memory-safe. Tutte le capability diUID 0del guest, i mountoverlayfs(ext4lite) e le regoleiptablesrestano strettamente isolate all'interno del processo della sandbox.
 1# 1. Installare rungv in user space (release SLSA-attested precompilata oppure go install)
 2# Opzione A: Verificare ed estrarre il binario precompilato SLSA-attested dalle GitHub Releases
 3gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx \
 4  --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml \
 5  --source-ref refs/tags/v0.2.0 --deny-self-hosted-runners
 6tar -xzf rungv-v0.2.0-linux-amd64.tar.gz && install -m 0755 rungv-v0.2.0-linux-amd64/rungv ~/.local/bin/rungv
 7
 8# Opzione B: Oppure installare direttamente dai sorgenti con Go
 9CGO_ENABLED=0 GOBIN=~/.local/bin go install z.gfire.dev/gvx/cmd/rungv@latest
10
11# 2. Avviare docker:dind all'interno di gvx con un volume ext4lite a file singolo
12#    Inoltra ~/.gvx/docker.sock (modalità 0600) alla porta 2375 del guest
13mkdir -p ~/.gvx
14~/.local/bin/rungv run \
15  -p unix:~/.gvx/docker.sock:2375 \
16  -p 127.0.0.1:9000-9019:9000-9019 \
17  -v gvx-docker:/var/lib/docker \
18  -e DOCKER_TLS_CERTDIR= \
19  docker:dind --tls=false &
20
21# 3. Puntare la CLI Docker standard e Docker Compose al socket user-space
22export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
23until docker info >/dev/null 2>&1; do sleep 0.5; done
24docker info --format '{{.Driver}} {{.OperatingSystem}}'
25# Output: overlayfs Alpine Linux ... (containerizzato)
26
27docker build -t app:test .
28docker run --rm app:test
29docker compose up -d
Perché i tool rootless standard falliscono nelle sandbox con restrizioni
Quando un ingegnere o un agente di coding autonomo deve eseguire docker build, docker run o docker compose all'interno di un container indurito o di un runner multi-tenant, i workaround standard falliscono su cinque barriere distinte del kernel.
1. Assenza del socket del daemon Docker sull'host (anche systemctl e service docker start falliscono)
L'esecuzione di docker ps o docker build fallisce immediatamente quando il socket host /var/run/docker.sock non è montato nell'ambiente, e il tentativo di avviare docker.io tramite systemctl o service docker start fallisce perché PID 1 non è systemd e /etc/init.d/docker raggiunge il limite rigido di ulimit -n del container:
1Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
2ERROR: Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
3System has not been booted with systemd as init system (PID 1). Can't operate.
4Failed to connect to bus: Host is down
5/etc/init.d/docker: 62: ulimit: error setting limit (Operation not permitted)
2. PR_SET_NO_NEW_PRIVS blocca sudo e gli helper setuid
I container induriti (securityContext.allowPrivilegeEscalation: false in Kubernetes, --security-opt=no-new-privileges in Docker, oppure le sandbox exebox / bwrap) impostano il bit Linux PR_SET_NO_NEW_PRIVS sull'albero dei processi. Il tentativo di ottenere privilegi tramite sudo o binari setuid (newuidmap, newgidmap, fusermount3) fallisce:
1sudo: The "no new privileges" flag is set, which prevents sudo from running as root.
2sudo: effective uid is not 0, is /usr/bin/sudo on a file system with the 'nosuid' option set or an NFS file system without root privileges?
3. Le policy di seccomp e sysctl bloccano unshare(CLONE_NEWUSER)
Gli strumenti presentati come "rootless" (Rootless Docker, Podman, Buildah, nerdctl, bubblewrap) continuano a dipendere dai user namespace Linux (CLONE_NEWUSER). Falliscono ogni volta che:
- Il profilo seccomp predefinito del container esterno blocca
unshare(2)oclone(CLONE_NEWUSER). - Ubuntu 24.04+ abilita
kernel.apparmor_restrict_unprivileged_userns = 1. - I nodi Debian o RHEL impostano
kernel.unprivileged_userns_clone = 0oppureuser.max_user_namespaces = 0. newuidmapnon riesce a scrivere in/proc/self/uid_mapperchéPR_SET_NO_NEW_PRIVSè attivo.
Gli errori risultanti hanno questo aspetto:
1unshare: unshare failed: Operation not permitted
2cannot clone: Operation not permitted
3Error: cannot re-exec process to join the existing user namespace
4newuidmap: write to uid_map failed: Operation not permitted
5RootlessKit: parent: failed to start the child: fork/exec /proc/self/exe: operation not permitted
4. mount(2) e pivot_root(2) sono bloccati durante docker build senza CAP_SYS_ADMIN sull'host
Anche quando un ambiente consente CLONE_NEWUSER oppure dockerd viene forzato ad avviarsi con --iptables=false --bridge=none --storage-driver=vfs, l'esecuzione di docker build fallisce alla prima istruzione RUN, perché il mount di un nuovo /proc o la chiamata a pivot_root(2) all'interno di un mount namespace annidato sono bloccati:
1ERROR: failed to solve: process "/bin/sh -c ..." did not complete successfully:
2mount("/proc", "/proc", "proc", MS_NOSUID|MS_NODEV|MS_NOEXEC, NULL): Operation not permitted
3OCI runtime create failed: runc create failed: unable to start container process: error during container init: error mounting "proc" to rootfs at "/proc": mount proc:/proc (via /proc/self/fd/6), flags: 0xe: operation not permitted
4OCI runtime create failed: runc create failed: unable to start container process: error during container init: error jailing process inside rootfs: pivot_root .: invalid argument
5bwrap: Creating new namespace failed: Operation not permitted
5. /dev/fuse mancante rompe fuse-overlayfs
I motori di container rootless che non possono montare l'overlayfs del kernel ricorrono a fuse-overlayfs. Nei container minimali o nei pod Kubernetes senza passthrough del dispositivo /dev/fuse, fuse-overlayfs fallisce immediatamente:
1fuse: device not found, try 'modprobe fuse' first
2fusermount3: failed to open /dev/fuse: No such file or directory
3error initializing graphdriver: driver not supported: fuse-overlayfs
Come gvx esegue docker:dind interamente in user space
gvx supera tutte e cinque le barriere del kernel perché non chiede al kernel Linux dell'host di creare namespace, montare filesystem o configurare interfacce di rete. Invece, rungv esegue un kernel Linux interno in user space (il Sentry di gVisor) e uno stack di rete in user space (netstack) all'interno di un unico processo ordinario non privilegiato.
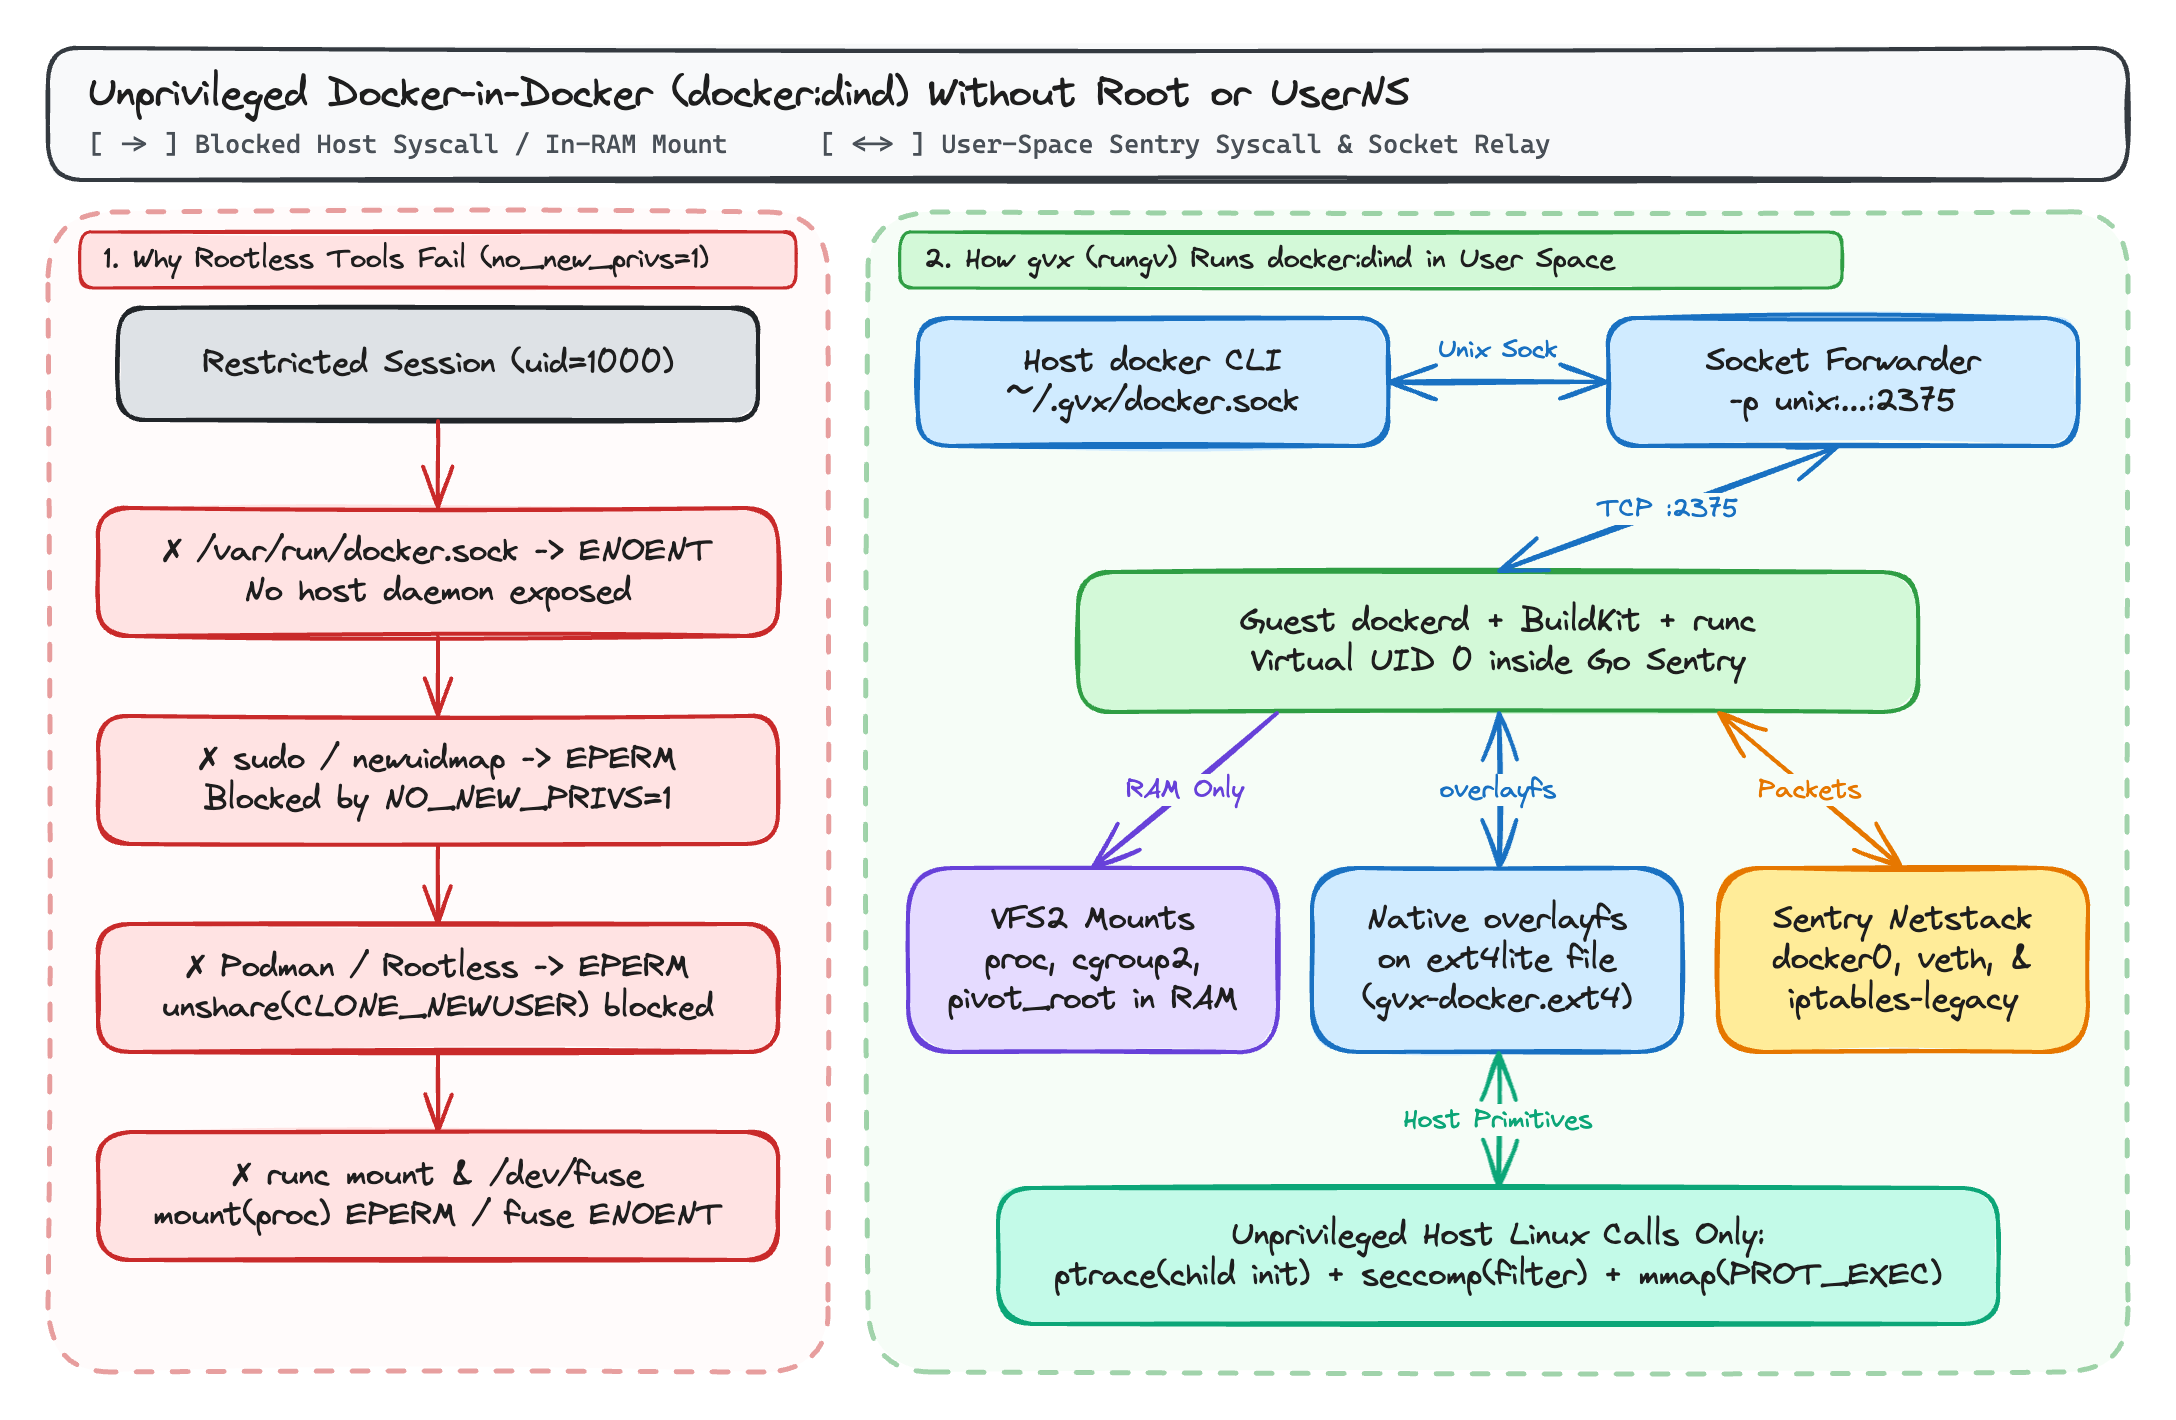
1. Namespace in memoria e tabella dei mount (VFS2)
Quando dockerd, containerd e runc vengono eseguiti all'interno di rungv, systrap intercetta le loro system call e le instrada verso il kernel Sentry in-process anziché verso il kernel dell'host:
unshare(2),clone(2),pivot_root(2),chroot(2)emount(2)operano sulla gerarchia dei task in memoria del Sentry e sulla tabella dei mountVFS2(procfs,sysfs,tmpfs,devpts,cgroupfsv2), mentre il processo hostrungvviene eseguito con l'UID host non privilegiato dell'utente.
2. overlayfs nativo su volumi ext4lite a file singolo
Quando si passa -v gvx-docker:/var/lib/docker (oppure --mount type=volume,src=/disk/gvx-docker.ext4,dst=/var/lib/docker), gvx monta il proprio filesystem integrato ext4lite in /var/lib/docker.
Poiché ext4lite implementa un filesystem ext4 con journal JBD2 all'interno di un singolo file host (gvx-docker.ext4), con supporto per gli attributi estesi trusted.overlay.*, per i device di whiteout a caratteri (0:0), per d_type e per RENAME_EXCHANGE, dockerd utilizza il proprio driver di storage nativo overlayfs all'interno del guest. Le operazioni docker build multi-stage condividono i layer Copy-on-Write senza /dev/fuse e senza l'esplosione dello spazio su disco tipica del driver di fallback vfs di Docker.
3. Bridge docker0 in user space e iptables-legacy
Quando docker:dind si avvia all'interno di gvx:
- Il
dockerddel guest crea il bridgedocker0(172.17.0.1/16), collega coppievethvirtuali per i container annidati e programma le cateneNAT(DOCKER,POSTROUTING) eFILTERcon matchaddrtypeeconntrackall'interno delnetstackuser-space digvx. - Passare
-p unix:~/.gvx/docker.sock:2375associa un socket Unix domain dell'host (modalità0600) e inoltra le connessioni direttamente alla porta2375didockerdall'interno della sandbox.
Confronto con gli strumenti di container esistenti
| Capacità / Vincolo | Docker standard (dockerd) | Docker Rootless / Podman | Kaniko / Buildah (non privilegiati) | gvx (rungv + docker:dind) |
|---|---|---|---|---|
Richiede root o sudo sull'host | Sì | No | No | No |
Funziona con PR_SET_NO_NEW_PRIVS=1 | No | No (newuidmap fallisce) | Parziale | Sì |
Funziona quando unshare(CLONE_NEWUSER) è bloccato (EPERM) | N/A | No | Buildah: No / Kaniko: Sì | Sì |
Funziona senza /dev/fuse | Sì (usa overlay2 del kernel) | Solo tramite lenta copia vfs | Sì | Sì (overlayfs su ext4lite) |
Supporta docker build (BuildKit) | Sì | Sì (se userns è consentito) | Solo build di immagini (nessun runtime) | Sì |
Supporta docker run e docker compose up | Sì | Sì (se userns è consentito) | No | Sì |
| Funziona su Windows e macOS senza una VM Linux | No (richiede WSL2 / VM) | No (richiede una VM Linux) | No | Sì (whpx, hvf, systrap) |
Requisiti esatti del kernel host su Linux
gvx richiede zero capability elevate (CapEff: 0000000000000000) e zero user namespace. Su un host Linux, rungv si basa solo su tre primitive standard del kernel non privilegiate:
ptrace(PTRACE_ATTACH)sul proprio thread figlio, una sola volta durante l'inizializzazione:systrapavvia un thread helper stub locale all'avvio, vi si collega per inizializzare il contesto di memoria condivisa e si scollega. Se l'host impostakernel.yama.ptrace_scope = 3(che disabilitaptracea livello di sistema) oppure bloccaptracein un filtro seccomp esterno, l'inizializzazione disystrapnon può completarsi. (Conyama.ptrace_scope = 1, il valore predefinito su Ubuntu e Debian,gvxfunziona perché è consentito il tracciamento da genitore a figlio.)seccomp(SECCOMP_SET_MODE_FILTER): usato per intercettare le system call del guest dai thread stub del container. Come illustrato nella Parte 3 di questa serie,gvxfunziona sia quandoSECCOMP_FILTER_FLAG_NEW_LISTENERè disponibile, sia quando restituisceEBUSYall'interno di una sandbox annidata.mmap(..., PROT_EXEC, ...): usato per mappare i segmenti ELF del guest e il trampolino di memoria condivisa disystrap.
Esempio end-to-end: costruire e testare un'app multi-container senza root
Il seguente script esegue un docker build completo e un test di integrazione a due container (redis + container applicativo) all'interno di una sessione utente non privilegiata:
 1mkdir -p ~/.gvx
 2rungv run \
 3  -p unix:~/.gvx/docker.sock:2375 \
 4  -v gvx-docker:/var/lib/docker \
 5  -e DOCKER_TLS_CERTDIR= \
 6  docker:dind --tls=false &
 7DIND_PID=$!
 8
 9export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
10until docker info >/dev/null 2>&1; do sleep 0.5; done
11
12mkdir -p /tmp/demo-app && cd /tmp/demo-app
13cat <<'EOF' > Dockerfile
14FROM alpine:3.20
15RUN apk add --no-cache redis
16CMD ["redis-cli", "-h", "cache", "ping"]
17EOF
18
19# Costruisce l'immagine usando overlayfs su ext4lite
20docker build -t demo-ping:latest .
21
22# Crea una rete bridge, avvia Redis e verifica la connettività tra i container
23docker network create demo-net
24docker run -d --name cache --network demo-net redis:7-alpine
25docker run --rm --network demo-net demo-ping:latest
26# Output: PONG
27
28# Rimuove i container di workload e arresta la sandbox
29docker rm -f cache
30docker network rm demo-net
31kill -INT $DIND_PID
Ulteriori letture in questa serie
- gvx: Esecuzione di container Linux, Docker e Kubernetes in un unico processo non privilegiato: Panoramica architetturale di
gvx, dei suoi motori di esecuzione multipiattaforma (whpx,hvf,systrap), diVFS2(erofs,ext4lite,hostfsv2) e dinetstack. - Esecuzione di Docker, docker build e docker compose senza root né user namespace (questo articolo)
- Esecuzione di Docker-in-Docker all'interno di gVisor e di sandbox annidate con gvx: Come
gvxrisolvemodprobe,iptables-nft,overlay2sugofereSECCOMP_FILTER_FLAG_NEW_LISTENERannidato (EBUSY) all'interno digVisor(runsc). - Ambienti Docker isolati e veloci per i rollout RL di agenti IA con gvx: Scalare ambienti paralleli per i rollout
SWE-benche RL con reset di volumi.ext4Copy-on-Write in 100 millisecondi.