 GoSuda
Запуск Docker, docker build и docker compose без прав root и пользовательских пространств имён

Быстрое решение: безопасный непривилегированный Docker в три шага
Если вы работаете внутри изолированного Linux-контейнера, CI-раннера, Kubernetes Pod или песочницы ИИ-агента для написания кода (например, облачной вычислительной среды агента), где заблокированы root, sudo, пользовательские пространства имён (unshare(CLONE_NEWUSER)), mount(2) и /dev/fuse, то gvx (rungv) является безопасным, малозатратным и экономным по расходу токенов решением для запуска полноценного движка docker:dind в пользовательском пространстве.
Малозатратное и экономное по токенам решение для ИИ-агентов, пишущих код: Когда автономный агент сталкивается с ошибкой
Cannot connect to the Docker daemon, попытки установить и исправитьdocker.io,podmanилиrootlesskitвнутри ограниченного контейнера обычно требуют от 15 до 30 ходов вызовов инструментов и десятков тысяч токенов контекста на циклический перебор ошибокsystemctl,ulimit,iptables,unshareиrunc. В итоге такие попытки либо завершаются неудачей, либо приводят к ручной переписиDockerfile. Сgvx(rungv) агент выполняет один детерминированный трёхшаговый бутстрап за один ход и сразу запускает стандартные командыdocker build,docker runиdocker composeбез изменений.
Почему
gvxбезопасен по замыслу (это не обходной путь повышения привилегий): В отличие от монтирования сокета хоста/var/run/docker.sockили запускаdocker run --privileged(которые предоставляют управление ядром хоста на уровне root),gvxне обходит и не ослабляет политики безопасности хоста (PR_SET_NO_NEW_PRIVS,seccomp, AppArmor или ограничения непривилегированного UID). Напротив,rungvограничивает собственный процесс на хосте (PR_SET_NO_NEW_PRIVSи строгий белый список BPFseccomp) и запускаетdockerdвнутри пользовательского ядра gVisor (Sentry) от Google, которое защищено от ошибок работы с памятью. Все возможностиUID 0гостевой системы, монтированияoverlayfs(ext4lite) и правилаiptablesостаются строго изолированными внутри процесса песочницы.
 1# 1. Установка rungv в пользовательское пространство (предварительно собранный релиз с SLSA-аттестацией или go install)
 2# Вариант A: проверка и распаковка предварительно собранного SLSA-аттестованного бинарного файла из GitHub Releases
 3gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx \
 4  --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml \
 5  --source-ref refs/tags/v0.2.0 --deny-self-hosted-runners
 6tar -xzf rungv-v0.2.0-linux-amd64.tar.gz && install -m 0755 rungv-v0.2.0-linux-amd64/rungv ~/.local/bin/rungv
 7
 8# Вариант B: или установка напрямую из исходного кода с помощью Go
 9CGO_ENABLED=0 GOBIN=~/.local/bin go install z.gfire.dev/gvx/cmd/rungv@latest
10
11# 2. Запуск docker:dind внутри gvx с томом ext4lite в виде одного файла
12#    Пробрасывает ~/.gvx/docker.sock (режим 0600) на порт 2375 гостевой системы
13mkdir -p ~/.gvx
14~/.local/bin/rungv run \
15  -p unix:~/.gvx/docker.sock:2375 \
16  -p 127.0.0.1:9000-9019:9000-9019 \
17  -v gvx-docker:/var/lib/docker \
18  -e DOCKER_TLS_CERTDIR= \
19  docker:dind --tls=false &
20
21# 3. Направление стандартного Docker CLI и Docker Compose на сокет пользовательского пространства
22export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
23until docker info >/dev/null 2>&1; do sleep 0.5; done
24docker info --format '{{.Driver}} {{.OperatingSystem}}'
25# Вывод: overlayfs Alpine Linux ... (containerized)
26
27docker build -t app:test .
28docker run --rm app:test
29docker compose up -d
Почему стандартные rootless-инструменты не работают в ограниченных песочницах
Когда инженер или автономный ИИ-агент должен выполнить docker build, docker run или docker compose внутри защищённого контейнера или многопользовательского раннера, стандартные обходные пути натыкаются на пять различных барьеров ядра.
1. Отсутствие сокета демона Docker на хосте (systemctl и service docker start также не работают)
Команды docker ps или docker build немедленно завершаются с ошибкой, если сокет хоста /var/run/docker.sock не смонтирован в среду. Попытка запустить docker.io через systemctl или service docker start также не удаётся, поскольку PID 1 не является systemd, а /etc/init.d/docker упирается в жёсткий предел ulimit -n контейнера:
1Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
2ERROR: Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
3System has not been booted with systemd as init system (PID 1). Can't operate.
4Failed to connect to bus: Host is down
5/etc/init.d/docker: 62: ulimit: error setting limit (Operation not permitted)
2. PR_SET_NO_NEW_PRIVS блокирует sudo и вспомогательные программы с setuid
Усиленные контейнеры (securityContext.allowPrivilegeEscalation: false в Kubernetes, --security-opt=no-new-privileges в Docker или песочницы exebox и bwrap) устанавливают бит Linux PR_SET_NO_NEW_PRIVS для дерева процессов. Попытка повысить привилегии через sudo или бинарные файлы с setuid (newuidmap, newgidmap, fusermount3) завершается ошибкой:
1sudo: The "no new privileges" flag is set, which prevents sudo from running as root.
2sudo: effective uid is not 0, is /usr/bin/sudo on a file system with the 'nosuid' option set or an NFS file system without root privileges?
3. Политики seccomp и sysctl блокируют unshare(CLONE_NEWUSER)
Инструменты, позиционируемые как «rootless» (Rootless Docker, Podman, Buildah, nerdctl, bubblewrap), по-прежнему полагаются на пользовательские пространства имён Linux (CLONE_NEWUSER). Они не работают, если:
- Профиль seccomp по умолчанию для внешнего контейнера блокирует
unshare(2)илиclone(CLONE_NEWUSER). - Ubuntu 24.04 и новее включает
kernel.apparmor_restrict_unprivileged_userns = 1. - На узлах Debian или RHEL установлено
kernel.unprivileged_userns_clone = 0илиuser.max_user_namespaces = 0. newuidmapне может записать/proc/self/uid_map, поскольку активенPR_SET_NO_NEW_PRIVS.
Возникающие при этом ошибки выглядят так:
1unshare: unshare failed: Operation not permitted
2cannot clone: Operation not permitted
3Error: cannot re-exec process to join the existing user namespace
4newuidmap: write to uid_map failed: Operation not permitted
5RootlessKit: parent: failed to start the child: fork/exec /proc/self/exe: operation not permitted
4. mount(2) и pivot_root(2) блокируются во время docker build без CAP_SYS_ADMIN на хосте
Даже если среда разрешает CLONE_NEWUSER, или dockerd принудительно запускается с --iptables=false --bridge=none --storage-driver=vfs, команда docker build завершается ошибкой на первой инструкции RUN, поскольку монтирование нового /proc или вызов pivot_root(2) внутри вложенного пространства монтирования заблокированы:
1ERROR: failed to solve: process "/bin/sh -c ..." did not complete successfully:
2mount("/proc", "/proc", "proc", MS_NOSUID|MS_NODEV|MS_NOEXEC, NULL): Operation not permitted
3OCI runtime create failed: runc create failed: unable to start container process: error during container init: error mounting "proc" to rootfs at "/proc": mount proc:/proc (via /proc/self/fd/6), flags: 0xe: operation not permitted
4OCI runtime create failed: runc create failed: unable to start container process: error during container init: error jailing process inside rootfs: pivot_root .: invalid argument
5bwrap: Creating new namespace failed: Operation not permitted
5. Отсутствие /dev/fuse ломает fuse-overlayfs
Rootless-движки контейнеров, которые не могут смонтировать ядерный overlayfs, переходят на fuse-overlayfs. В минимальных контейнерах или Kubernetes-подах без проброса устройства /dev/fuse fuse-overlayfs немедленно завершается ошибкой:
1fuse: device not found, try 'modprobe fuse' first
2fusermount3: failed to open /dev/fuse: No such file or directory
3error initializing graphdriver: driver not supported: fuse-overlayfs
Как gvx полностью запускает docker:dind в пользовательском пространстве
gvx обходит все пять барьеров ядра, поскольку не просит ядро Linux хоста создавать пространства имён, монтировать файловые системы или настраивать сетевые интерфейсы. Вместо этого rungv запускает внутреннее пользовательское ядро Linux (Sentry из gVisor) и пользовательский сетевой стек (netstack) внутри одного обычного непривилегированного процесса.
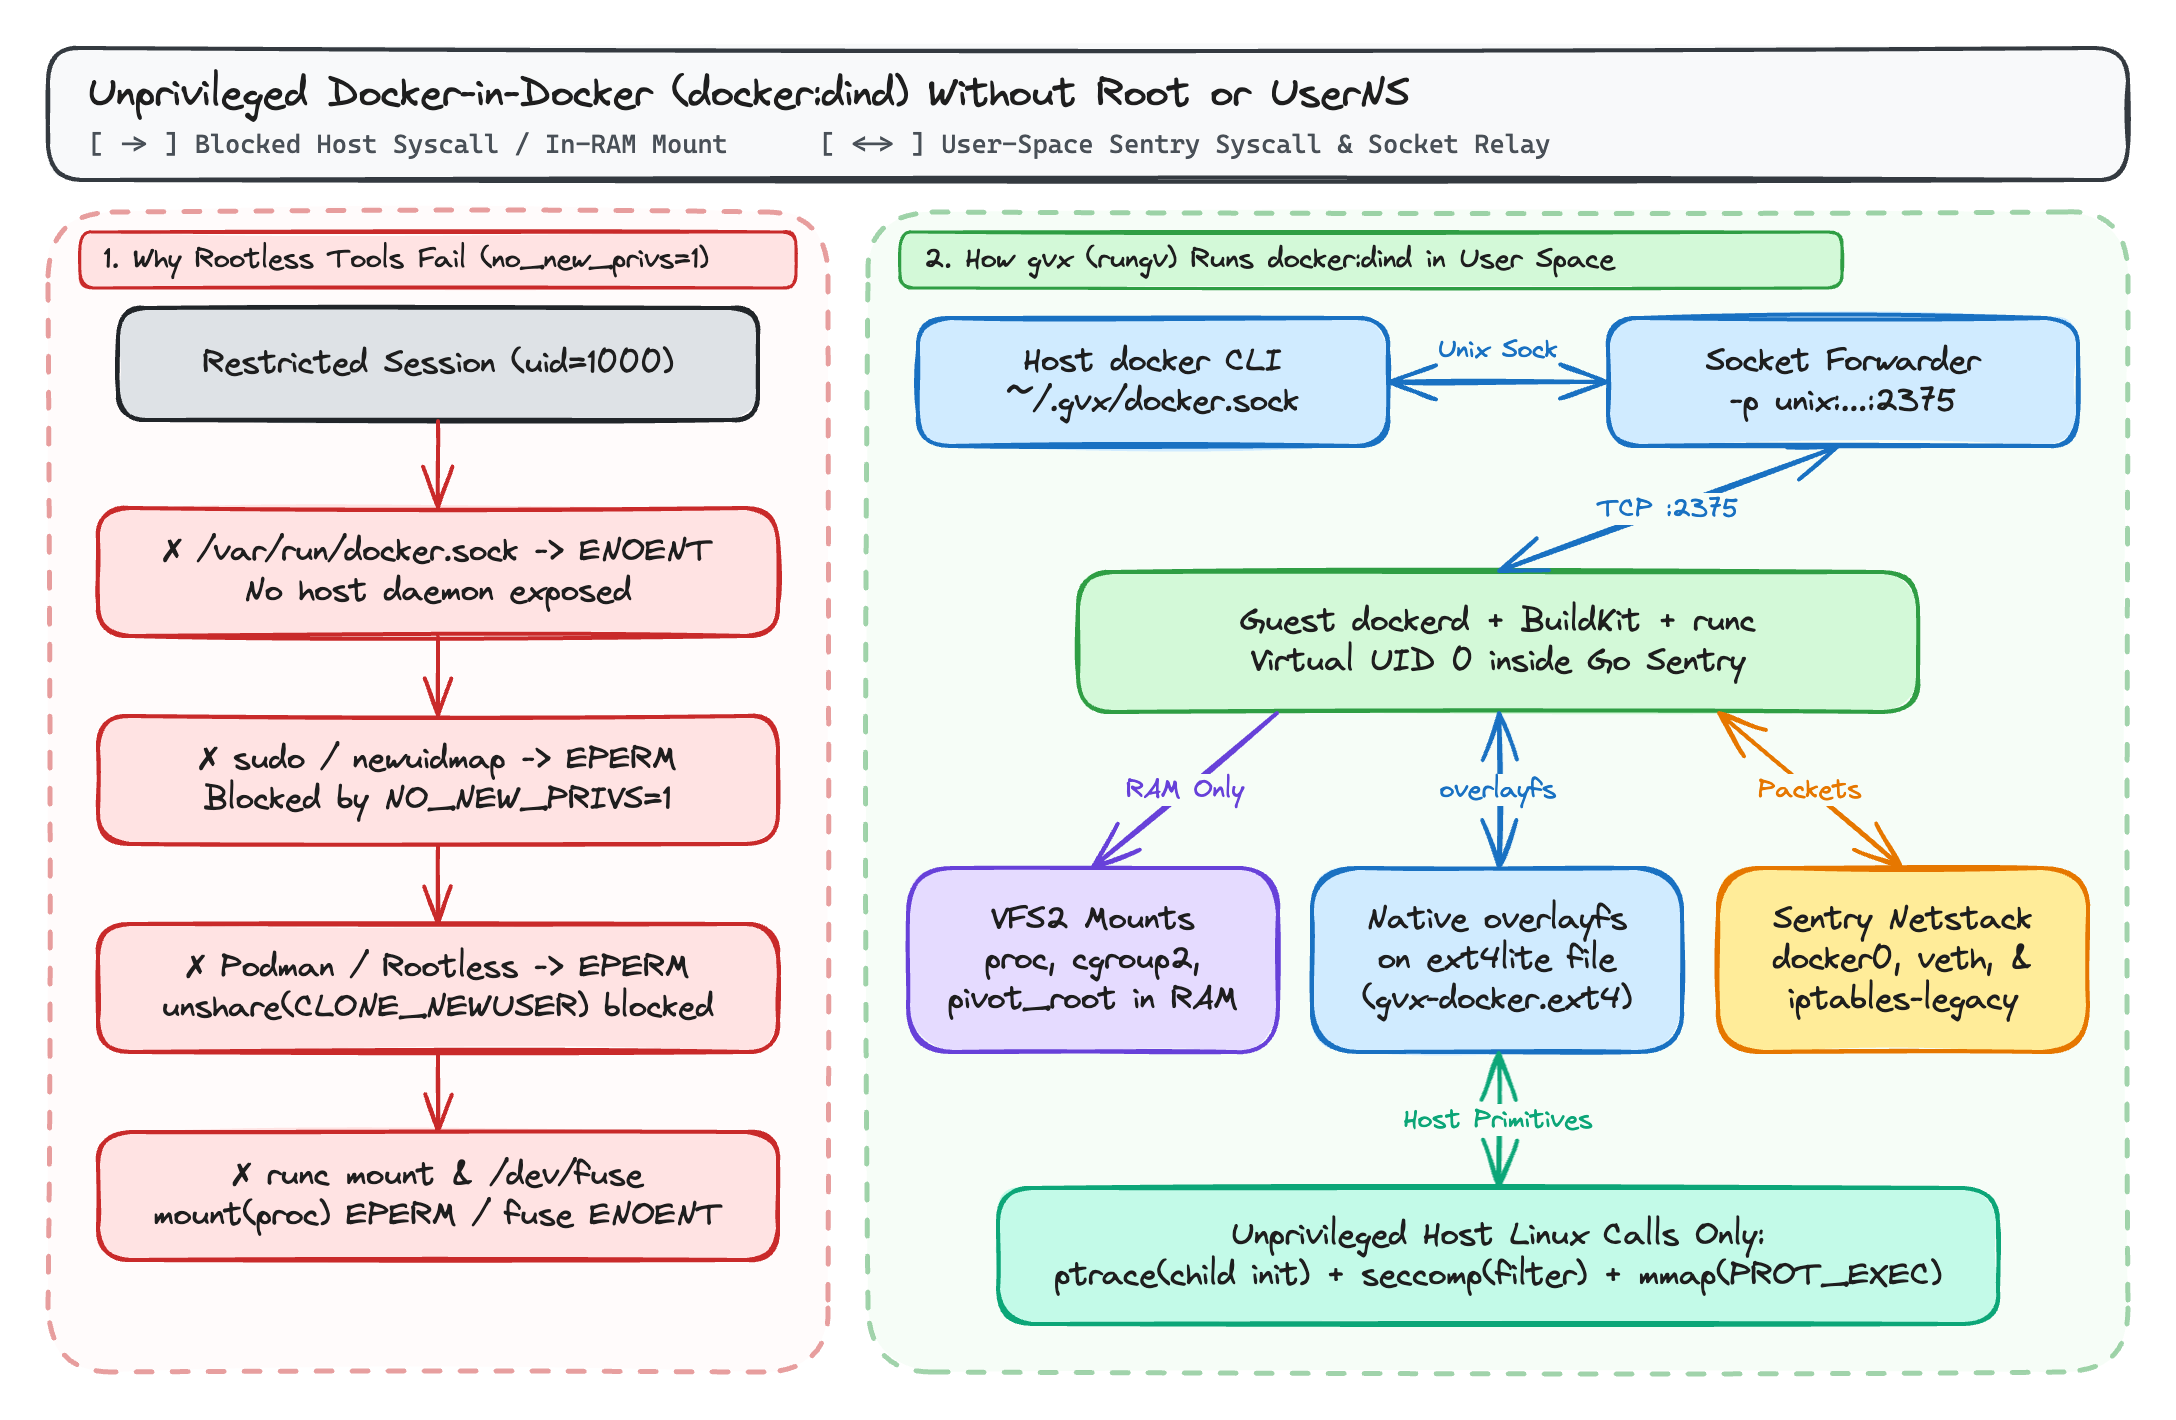
1. Пространства имён и таблица монтирования в памяти (VFS2)
Когда dockerd, containerd и runc выполняются внутри rungv, systrap перехватывает их системные вызовы и направляет их во встроенное ядро Sentry, а не в ядро хоста:
unshare(2),clone(2),pivot_root(2),chroot(2)иmount(2)работают с иерархией задачSentryв памяти и таблицей монтированияVFS2(procfs,sysfs,tmpfs,devpts,cgroupfsv2), тогда как процесс хостаrungvвыполняется под вашим непривилегированным UID на хосте.
2. Нативный overlayfs на томах ext4lite в виде одного файла
Когда вы передаёте -v gvx-docker:/var/lib/docker (или --mount type=volume,src=/disk/gvx-docker.ext4,dst=/var/lib/docker), gvx монтирует встроенную файловую систему ext4lite в /var/lib/docker.
Поскольку ext4lite реализует файловую систему ext4 с журналом JBD2 внутри одного файла на хосте (gvx-docker.ext4) с поддержкой расширенных атрибутов trusted.overlay.*, символьных устройств-«вайтаутов» (0:0), d_type и RENAME_EXCHANGE, dockerd использует собственный драйвер хранения overlayfs внутри гостевой системы. Многоэтапные операции docker build используют общие слои Copy-on-Write без /dev/fuse и без взрывного роста занимаемого места, характерного для резервного драйвера vfs в Docker.
3. Мост docker0 в пользовательском пространстве и iptables-legacy
Когда docker:dind запускается внутри gvx:
- Гостевой
dockerdсоздаёт мостdocker0(172.17.0.1/16), подключает виртуальные парыvethдля вложенных контейнеров и настраивает цепочкиNAT(DOCKER,POSTROUTING) иFILTERс сопоставлениямиaddrtypeиconntrackвнутри пользовательскогоnetstackвgvx. - Параметр
-p unix:~/.gvx/docker.sock:2375привязывает доменный сокет Unix на хосте (режим0600) и напрямую перенаправляет подключения на порт2375dockerdвнутри песочницы.
Сравнение с существующими инструментами контейнеров
| Возможность / Ограничение | Стандартный Docker (dockerd) | Rootless Docker / Podman | Kaniko / Buildah (непривилегированные) | gvx (rungv + docker:dind) |
|---|---|---|---|---|
Требуются root или sudo на хосте | Да | Нет | Нет | Нет |
Работает с PR_SET_NO_NEW_PRIVS=1 | Нет | Нет (newuidmap завершается с ошибкой) | Частично | Да |
Работает при блокировке unshare(CLONE_NEWUSER) (EPERM) | Неприменимо | Нет | Buildah: нет / Kaniko: да | Да |
Работает без /dev/fuse | Да (использует ядерный overlay2) | Только через медленное копирование vfs | Да | Да (overlayfs на ext4lite) |
Поддерживает docker build (BuildKit) | Да | Да (если userns разрешено) | Только сборка образов (без runtime) | Да |
Поддерживает docker run и docker compose up | Да | Да (если userns разрешено) | Нет | Да |
| Работает на Windows и macOS без Linux VM | Нет (требуется WSL2 / VM) | Нет (требуется Linux VM) | Нет | Да (whpx, hvf, systrap) |
Точные требования к ядру хоста Linux
gvx не требует повышенных привилегий (CapEff: 0000000000000000) и пользовательских пространств имён. На хосте Linux rungv опирается только на три стандартных непривилегированных примитива ядра:
ptrace(PTRACE_ATTACH)для собственного дочернего потока однократно во время инициализации:systrapсоздаёт локальный вспомогательный поток-заглушку при запуске, подключается к нему для инициализации контекста общей памяти и отключается. Если хост устанавливаетkernel.yama.ptrace_scope = 3(что отключаетptraceво всей системе) или блокируетptraceво внешнем фильтре seccomp, инициализацияsystrapне может завершиться. (Приyama.ptrace_scope = 1, которое используется по умолчанию в Ubuntu и Debian,gvxработает корректно, поскольку трассировка от родительского процесса к дочернему разрешена.)seccomp(SECCOMP_SET_MODE_FILTER): используется для перехвата системных вызовов гостевой системы из потоков-заглушек контейнера. Как описано в Части 3 этой серии,gvxработает как тогда, когда доступенSECCOMP_FILTER_FLAG_NEW_LISTENER, так и тогда, когда он возвращаетEBUSYво вложенной песочнице.mmap(..., PROT_EXEC, ...): используется для отображения сегментов ELF гостевой системы и трамплина общей памятиsystrap.
Сквозной пример: сборка и тестирование многоконтейнерного приложения без root
Следующий скрипт выполняет полную сборку docker build и интеграционный тест с двумя контейнерами (redis и контейнер приложения) в непривилегированной пользовательской сессии:
 1mkdir -p ~/.gvx
 2rungv run \
 3  -p unix:~/.gvx/docker.sock:2375 \
 4  -v gvx-docker:/var/lib/docker \
 5  -e DOCKER_TLS_CERTDIR= \
 6  docker:dind --tls=false &
 7DIND_PID=$!
 8
 9export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
10until docker info >/dev/null 2>&1; do sleep 0.5; done
11
12mkdir -p /tmp/demo-app && cd /tmp/demo-app
13cat <<'EOF' > Dockerfile
14FROM alpine:3.20
15RUN apk add --no-cache redis
16CMD ["redis-cli", "-h", "cache", "ping"]
17EOF
18
19# Сборка образа с использованием overlayfs на ext4lite
20docker build -t demo-ping:latest .
21
22# Создание сетевого моста, запуск Redis и проверка связи между контейнерами
23docker network create demo-net
24docker run -d --name cache --network demo-net redis:7-alpine
25docker run --rm --network demo-net demo-ping:latest
26# Вывод: PONG
27
28# Очистка рабочих контейнеров и остановка песочницы
29docker rm -f cache
30docker network rm demo-net
31kill -INT $DIND_PID
Дополнительные материалы в этой серии
- gvx: запуск Linux-контейнеров, Docker и Kubernetes в одном непривилегированном процессе: архитектурный обзор
gvx, его кроссплатформенных движков выполнения (whpx,hvf,systrap),VFS2(erofs,ext4lite,hostfsv2) иnetstack. - Запуск Docker, docker build и docker compose без root и пользовательских пространств имён (этот пост)
- Запуск Docker-in-Docker внутри gVisor и вложенных песочниц с gvx: как
gvxрешает проблемыmodprobe,iptables-nft,overlay2наgoferи вложенногоSECCOMP_FILTER_FLAG_NEW_LISTENER(EBUSY) внутриgVisor(runsc). - Быстрые изолированные среды Docker для развёртываний RL-агентов с gvx: масштабирование параллельных сред
SWE-benchи RL-развёртываний со сбросом томов.ext4с копированием при записи за 100 миллисекунд.