 GoSuda
Ausführen von Docker, docker build und docker compose ohne Root-Rechte oder User Namespaces

Schnelllösung: Unprivilegiertes Docker in drei Schritten
Wenn Sie innerhalb eines abgeschotteten Linux-Containers, eines CI-Runners, eines Kubernetes-Pods oder einer Sandbox für KI-Coding-Agenten arbeiten (etwa einer Cloud-Agent-Compute-Umgebung), in der root, sudo, User-Namespaces (unshare(CLONE_NEWUSER)), mount(2) und /dev/fuse blockiert sind, ist gvx (rungv) die sichere, aufwandsarme und token-effiziente Lösung, um eine vollständige docker:dind-Engine im User Space auszuführen.
Aufwandsarme, token-effiziente Lösung für KI-Coding-Agenten: Wenn ein autonomer Coding-Agent auf
Cannot connect to the Docker daemonstößt, verschwendet der Versuch,docker.io,podmanoderrootlesskitin einem eingeschränkten Container zu installieren und zu patchen, typischerweise 15 bis 30 Tool-Call-Runden und zehntausende Kontext-Token, indem er sich durch Fehler beisystemctl,ulimit,iptables,unshareundruncarbeitet, nur um anschließend zu scheitern oderDockerfiles von Hand umzuschreiben. Mitgvx(rungv) führt der Agent einen deterministischen dreistufigen Bootstrap in einem einzigen Schritt aus und kann danach sofort die standardmäßigen Befehledocker build,docker rununddocker composeunverändert ausführen.
Warum
gvxby Design sicher ist (keine Umgehung der Rechteausweitung): Anders als das Einbinden des Host-Sockets/var/run/docker.sockoder das Ausführen vondocker run --privileged(die eine root-äquivalente Kontrolle über den Host-Kernel gewähren), umgeht oder schwächtgvxkeine Host-Sicherheitsrichtlinie (PR_SET_NO_NEW_PRIVS,seccomp, AppArmor oder Beschränkungen für Nicht-root-UIDs). Stattdessen sperrtrungvseinen eigenen Host-Prozess ab (PR_SET_NO_NEW_PRIVS+ strenge BPF-seccomp-Allowlist) und führtdockerdim speichersicheren User-Space-Kernel gVisor (Sentry) von Google aus. Alle Capabilities von Gast-UID 0,overlayfs-Mounts (ext4lite) undiptables-Regeln bleiben strikt innerhalb des Sandbox-Prozesses isoliert.
 1# 1. rungv im User Space installieren (vorkompiliertes, SLSA-attestiertes Release oder go install)
 2# Option A: Das SLSA-attestierte vorkompilierte Binary aus den GitHub Releases verifizieren und extrahieren
 3gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx \
 4  --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml \
 5  --source-ref refs/tags/v0.2.0 --deny-self-hosted-runners
 6tar -xzf rungv-v0.2.0-linux-amd64.tar.gz && install -m 0755 rungv-v0.2.0-linux-amd64/rungv ~/.local/bin/rungv
 7
 8# Option B: Oder direkt aus dem Quellcode mit Go installieren
 9CGO_ENABLED=0 GOBIN=~/.local/bin go install z.gfire.dev/gvx/cmd/rungv@latest
10
11# 2. docker:dind innerhalb von gvx mit einem Einzeldatei-ext4lite-Volume starten
12#    Leitet ~/.gvx/docker.sock (Modus 0600) an Gast-Port 2375 weiter
13mkdir -p ~/.gvx
14~/.local/bin/rungv run \
15  -p unix:~/.gvx/docker.sock:2375 \
16  -p 127.0.0.1:9000-9019:9000-9019 \
17  -v gvx-docker:/var/lib/docker \
18  -e DOCKER_TLS_CERTDIR= \
19  docker:dind --tls=false &
20
21# 3. Die Standard-Docker-CLI und Docker Compose auf den User-Space-Socket ausrichten
22export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
23until docker info >/dev/null 2>&1; do sleep 0.5; done
24docker info --format '{{.Driver}} {{.OperatingSystem}}'
25# Ausgabe: overlayfs Alpine Linux ... (containerized)
26
27docker build -t app:test .
28docker run --rm app:test
29docker compose up -d
Warum Standard-Rootless-Werkzeuge in eingeschränkten Sandboxes scheitern
Wenn ein Ingenieur oder autonomer Coding-Agent docker build, docker run oder docker compose in einem gehärteten Container oder einem Mandanten-Runner ausführen muss, scheitern übliche Workarounds an fünf unterschiedlichen Kernel-Barrieren.
1. Kein Host-Docker-Daemon-Socket (auch systemctl und service docker start schlagen fehl)
Der Befehl docker ps oder docker build schlägt sofort fehl, wenn der Host-Socket /var/run/docker.sock nicht in die Umgebung eingebunden ist. Der Versuch, docker.io über systemctl oder service docker start zu starten, scheitert, weil PID 1 nicht systemd ist und /etc/init.d/docker an die harte ulimit -n-Grenze des Containers stößt:
1Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
2ERROR: Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
3System has not been booted with systemd as init system (PID 1). Can't operate.
4Failed to connect to bus: Host is down
5/etc/init.d/docker: 62: ulimit: error setting limit (Operation not permitted)
2. PR_SET_NO_NEW_PRIVS blockiert sudo und Setuid-Helfer
Gehärtete Container (securityContext.allowPrivilegeEscalation: false in Kubernetes, --security-opt=no-new-privileges in Docker oder exebox- bzw. bwrap-Sandboxes) setzen das Linux-Bit PR_SET_NO_NEW_PRIVS auf dem gesamten Prozessbaum. Der Versuch, über sudo oder Setuid-Binaries (newuidmap, newgidmap, fusermount3) Rechte zu erweitern, schlägt fehl:
1sudo: The "no new privileges" flag is set, which prevents sudo from running as root.
2sudo: effective uid is not 0, is /usr/bin/sudo on a file system with the 'nosuid' option set or an NFS file system without root privileges?
3. Seccomp- und Sysctl-Richtlinien blockieren unshare(CLONE_NEWUSER)
Werkzeuge, die als „rootless“ vermarktet werden (Rootless Docker, Podman, Buildah, nerdctl, bubblewrap), setzen weiterhin auf Linux-User-Namespaces (CLONE_NEWUSER). Sie schlagen immer dann fehl, wenn:
- das Standard-seccomp-Profil des äußeren Containers
unshare(2)oderclone(CLONE_NEWUSER)blockiert. - Ubuntu 24.04 und neuer
kernel.apparmor_restrict_unprivileged_userns = 1aktivieren. - Debian- oder RHEL-Knoten
kernel.unprivileged_userns_clone = 0oderuser.max_user_namespaces = 0setzen. newuidmapnicht in/proc/self/uid_mapschreiben kann, weilPR_SET_NO_NEW_PRIVSaktiv ist.
Die daraus resultierenden Fehler sehen so aus:
1unshare: unshare failed: Operation not permitted
2cannot clone: Operation not permitted
3Error: cannot re-exec process to join the existing user namespace
4newuidmap: write to uid_map failed: Operation not permitted
5RootlessKit: parent: failed to start the child: fork/exec /proc/self/exe: operation not permitted
4. mount(2) und pivot_root(2) sind während docker build ohne Host-CAP_SYS_ADMIN blockiert
Selbst wenn eine Umgebung CLONE_NEWUSER erlaubt oder dockerd mit --iptables=false --bridge=none --storage-driver=vfs gestartet wird, schlägt docker build bereits bei der ersten RUN-Anweisung fehl, weil das Mounten eines frischen /proc oder der Aufruf von pivot_root(2) innerhalb eines verschachtelten Mount-Namespaces blockiert ist:
1ERROR: failed to solve: process "/bin/sh -c ..." did not complete successfully:
2mount("/proc", "/proc", "proc", MS_NOSUID|MS_NODEV|MS_NOEXEC, NULL): Operation not permitted
3OCI runtime create failed: runc create failed: unable to start container process: error during container init: error mounting "proc" to rootfs at "/proc": mount proc:/proc (via /proc/self/fd/6), flags: 0xe: operation not permitted
4OCI runtime create failed: runc create failed: unable to start container process: error during container init: error jailing process inside rootfs: pivot_root .: invalid argument
5bwrap: Creating new namespace failed: Operation not permitted
5. Fehlendes /dev/fuse bricht fuse-overlayfs
Rootless-Container-Engines, die kein Kernel-overlayfs mounten können, weichen auf fuse-overlayfs aus. In minimalen Containern oder Kubernetes-Pods ohne Durchreichen des Geräts /dev/fuse schlägt fuse-overlayfs sofort fehl:
1fuse: device not found, try 'modprobe fuse' first
2fusermount3: failed to open /dev/fuse: No such file or directory
3error initializing graphdriver: driver not supported: fuse-overlayfs
Wie gvx docker:dind vollständig im User Space ausführt
gvx umgeht alle fünf Kernel-Barrieren, weil es den Host-Linux-Kernel nicht darum bittet, Namespaces zu erstellen, Dateisysteme zu mounten oder Netzwerkschnittstellen zu konfigurieren. Stattdessen führt rungv einen internen Linux-Kernel im User Space (den gVisor-Sentry) und einen Netzwerkstack im User Space (netstack) innerhalb eines gewöhnlichen, unprivilegierten Prozesses aus.
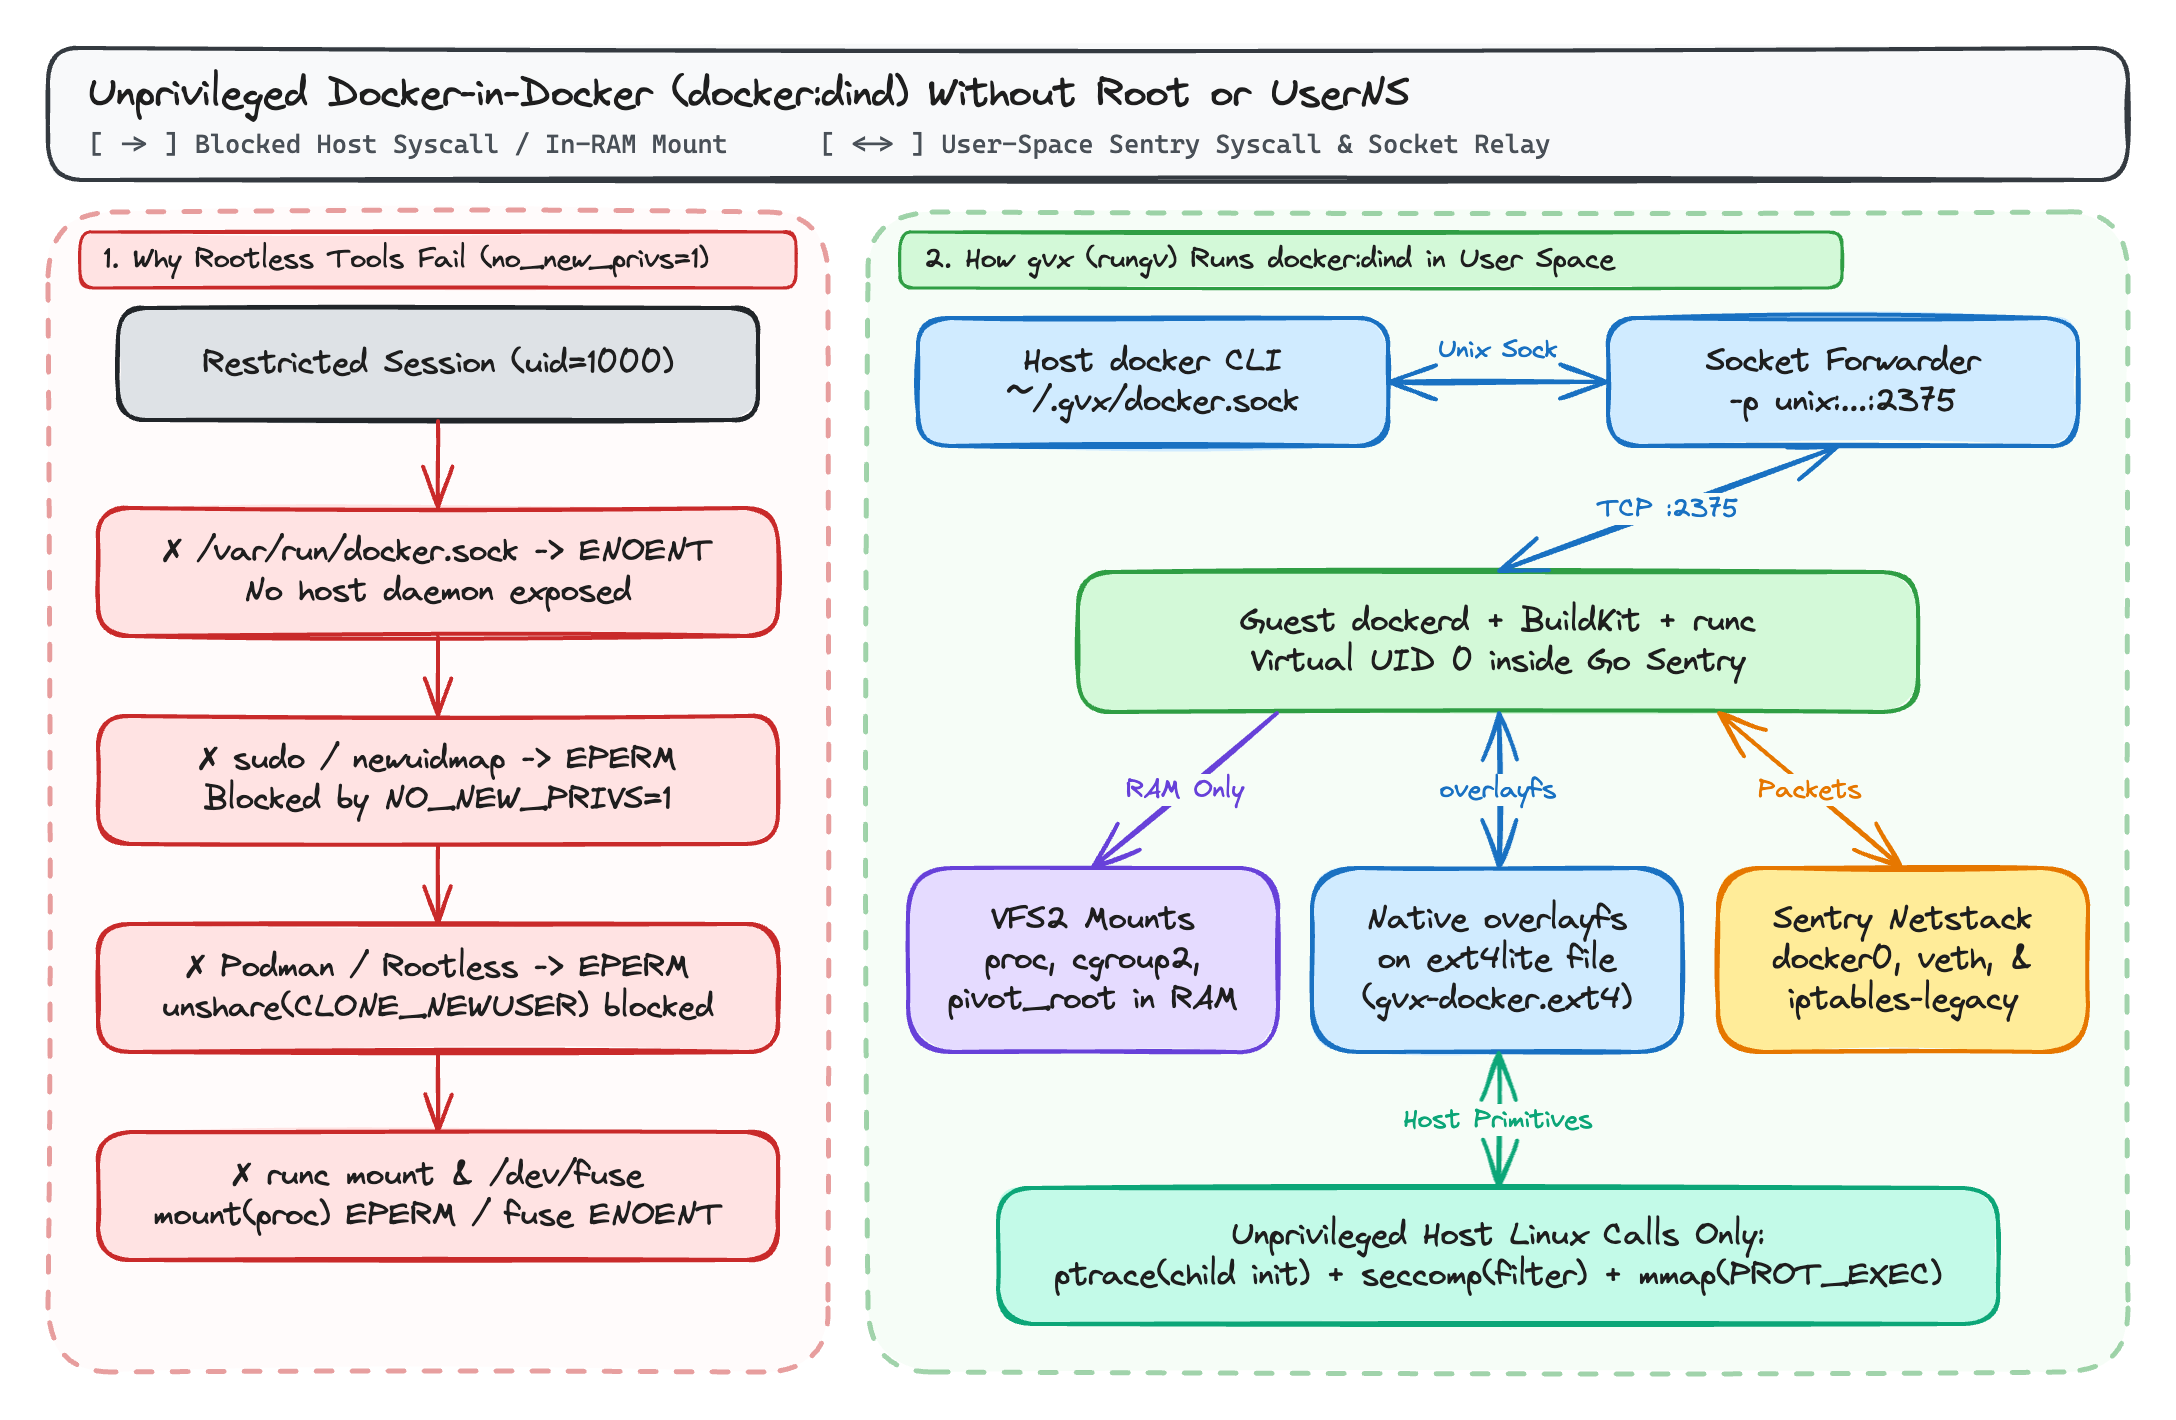
1. In-Memory-Namespaces und Mount-Tabelle (VFS2)
Wenn dockerd, containerd und runc innerhalb von rungv ausgeführt werden, fängt systrap deren Systemaufrufe ab und leitet sie an den prozessinternen Sentry-Kernel weiter, nicht an den Host-Kernel:
unshare(2),clone(2),pivot_root(2),chroot(2)undmount(2)arbeiten auf der In-Memory-Task-Hierarchie des Sentry und auf derVFS2-Mount-Tabelle (procfs,sysfs,tmpfs,devpts,cgroupfsv2), während der Host-Prozessrungvunter Ihrer unprivilegierten Host-UID läuft.
2. Natives overlayfs auf Einzeldatei-ext4lite-Volumes
Wenn Sie -v gvx-docker:/var/lib/docker (oder --mount type=volume,src=/disk/gvx-docker.ext4,dst=/var/lib/docker) übergeben, mountet gvx sein integriertes Dateisystem ext4lite unter /var/lib/docker.
Da ext4lite ein JBD2-journalisiertes ext4-Dateisystem innerhalb einer einzigen Host-Datei (gvx-docker.ext4) implementiert, mit Unterstützung für die erweiterten Attribute trusted.overlay.*, Whiteout-Zeichengeräte (0:0), d_type und RENAME_EXCHANGE, verwendet dockerd im Gast seinen nativen Storage-Treiber overlayfs. Mehrstufige docker build-Vorgänge teilen sich Copy-on-Write-Layer, ohne /dev/fuse und ohne die Speicherplatzexplosion des vfs-Fallback-Treibers von Docker.
3. User-Space-Bridge docker0 und iptables-legacy
Wenn docker:dind innerhalb von gvx startet:
- Erstellt der Gast-
dockerddie Bridgedocker0(172.17.0.1/16), hängt virtuelleveth-Paare für verschachtelte Container an und programmiert die KettenNAT(DOCKER,POSTROUTING) sowieFILTERmitaddrtype- undconntrack-Matches innerhalb des User-Space-netstackvongvx. - Bindet die Angabe
-p unix:~/.gvx/docker.sock:2375einen Unix-Domain-Socket des Hosts (Modus0600) und leitet Verbindungen direkt an Port2375vondockerdinnerhalb der Sandbox weiter.
Vergleich mit bestehenden Container-Werkzeugen
| Fähigkeit / Einschränkung | Standard-Docker (dockerd) | Rootless Docker / Podman | Kaniko / Buildah (unprivilegiert) | gvx (rungv + docker:dind) |
|---|---|---|---|---|
Host-root oder sudo erforderlich | Ja | Nein | Nein | Nein |
Funktioniert mit PR_SET_NO_NEW_PRIVS=1 | Nein | Nein (newuidmap schlägt fehl) | Teilweise | Ja |
Funktioniert, wenn unshare(CLONE_NEWUSER) blockiert ist (EPERM) | Nicht zutreffend | Nein | Buildah: Nein / Kaniko: Ja | Ja |
Funktioniert ohne /dev/fuse | Ja (nutzt Kernel-overlay2) | Nur über langsamen vfs-Kopiervorgang | Ja | Ja (overlayfs auf ext4lite) |
Unterstützt docker build (BuildKit) | Ja | Ja (falls userns erlaubt) | Nur Image-Build (ohne Laufzeit) | Ja |
Unterstützt docker run und docker compose up | Ja | Ja (falls userns erlaubt) | Nein | Ja |
| Läuft unter Windows und macOS ohne Linux-VM | Nein (benötigt WSL2 / VM) | Nein (benötigt Linux-VM) | Nein | Ja (whpx, hvf, systrap) |
Genaue Anforderungen an den Host-Kernel unter Linux
gvx benötigt keine erhöhten Capabilities (CapEff: 0000000000000000) und keine User-Namespaces. Unter Linux stützt sich rungv nur auf drei standardmäßige unprivilegierte Kernel-Primitive:
ptrace(PTRACE_ATTACH)auf den eigenen Kindthread, einmalig bei der Initialisierung:systrapstartet bei der Initialisierung einen lokalen Stub-Hilfsthread, hängt sich an diesen an, um den gemeinsam genutzten Speicherkontext zu initialisieren, und löst die Verbindung wieder. Wenn der Hostkernel.yama.ptrace_scope = 3setzt (wodurchptracesystemweit deaktiviert wird) oderptracein einem äußeren seccomp-Filter blockiert, kann die Initialisierung vonsystrapnicht abgeschlossen werden. (Unteryama.ptrace_scope = 1, dem Standard auf Ubuntu und Debian, funktioniertgvx, da das Tracing vom Eltern- zum Kindprozess erlaubt ist.)seccomp(SECCOMP_SET_MODE_FILTER): Wird verwendet, um Systemaufrufe des Gasts aus den Stub-Threads des Containers abzufangen. Wie in Teil 3 dieser Serie beschrieben, funktioniertgvxsowohl dann, wennSECCOMP_FILTER_FLAG_NEW_LISTENERverfügbar ist, als auch dann, wenn es in einer verschachtelten SandboxEBUSYzurückgibt.mmap(..., PROT_EXEC, ...): Wird verwendet, um ELF-Segmente des Gasts und das gemeinsam genutzte Speicher-Trampolin vonsystrapabzubilden.
End-to-End-Beispiel: Bauen und Testen einer Multi-Container-App ohne Root
Das folgende Skript führt einen vollständigen docker build und einen Integrationstest mit zwei Containern (redis + Anwendungscontainer) in einer unprivilegierten Benutzersitzung aus:
 1mkdir -p ~/.gvx
 2rungv run \
 3  -p unix:~/.gvx/docker.sock:2375 \
 4  -v gvx-docker:/var/lib/docker \
 5  -e DOCKER_TLS_CERTDIR= \
 6  docker:dind --tls=false &
 7DIND_PID=$!
 8
 9export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
10until docker info >/dev/null 2>&1; do sleep 0.5; done
11
12mkdir -p /tmp/demo-app && cd /tmp/demo-app
13cat <<'EOF' > Dockerfile
14FROM alpine:3.20
15RUN apk add --no-cache redis
16CMD ["redis-cli", "-h", "cache", "ping"]
17EOF
18
19# Das Image mit overlayfs auf ext4lite bauen
20docker build -t demo-ping:latest .
21
22# Ein Bridge-Netzwerk erstellen, Redis starten und die Konnektivität zwischen den Containern prüfen
23docker network create demo-net
24docker run -d --name cache --network demo-net redis:7-alpine
25docker run --rm --network demo-net demo-ping:latest
26# Ausgabe: PONG
27
28# Workload-Container aufräumen und die Sandbox beenden
29docker rm -f cache
30docker network rm demo-net
31kill -INT $DIND_PID
Weitere Lektüre in dieser Serie
- gvx: Linux-Container, Docker und Kubernetes in einem unprivilegierten Prozess ausführen: Architekturüberblick über
gvx, seine plattformübergreifenden Ausführungs-Engines (whpx,hvf,systrap),VFS2(erofs,ext4lite,hostfsv2) undnetstack. - Docker, docker build und docker compose ohne Root oder User-Namespaces ausführen (dieser Beitrag)
- Docker-in-Docker innerhalb von gVisor und verschachtelten Sandboxes mit gvx ausführen: Wie
gvxmodprobe,iptables-nft,overlay2aufgoferund das verschachtelteSECCOMP_FILTER_FLAG_NEW_LISTENER(EBUSY) innerhalb vongVisor(runsc) löst. - Schnelle isolierte Docker-Umgebungen für RL-Rollouts von KI-Agenten mit gvx: Skalierung paralleler
SWE-bench- und RL-Rollout-Umgebungen mit 100-Millisekunden-Copy-on-Write-Resets von.ext4-Volumes.