 GoSuda
Exécuter Docker, docker build et docker compose sans privilèges root ni espaces de noms utilisateur

Solution rapide : sécuriser Docker sans privilèges en trois étapes
Si vous travaillez dans un conteneur Linux verrouillé, un runner CI, un Pod Kubernetes ou un bac à sable d'agent de codage IA (tel qu'un environnement de calcul d'agent cloud) où root, sudo, les espaces de noms utilisateur (unshare(CLONE_NEWUSER)), mount(2) et /dev/fuse sont bloqués, gvx (rungv) constitue la solution sécurisée, peu coûteuse en effort et économe en jetons permettant d'exécuter un moteur docker:dind complet en espace utilisateur.
Solution peu coûteuse en effort et économe en jetons pour les agents de codage IA : lorsqu'un agent de codage autonome rencontre
Cannot connect to the Docker daemon, tenter d'installer et de corrigerdocker.io,podmanourootlesskitdans un conteneur restreint gaspille généralement 15 à 30 tours d'appels d'outils et plusieurs dizaines de milliers de jetons de contexte à enchaîner les erreurs desystemctl,ulimit,iptables,unshareetrunc, pour finalement échouer ou revenir à la réécriture manuelle desDockerfile. Avecgvx(rungv), l'agent exécute un amorçage déterministe en 3 étapes en un seul tour et lance immédiatement les commandes standarddocker build,docker runetdocker compose, sans modification.
Pourquoi
gvxest sûr par conception (et non un contournement d'élévation de privilèges) : contrairement au montage de la socket hôte/var/run/docker.sockou à l'exécution dedocker run --privileged(qui accordent un contrôle équivalent à root sur le noyau hôte),gvxne contourne ni n'affaiblit aucune politique de sécurité de l'hôte (PR_SET_NO_NEW_PRIVS,seccomp, AppArmor ou limites d'UID non root). À la place,rungvverrouille son propre processus hôte (PR_SET_NO_NEW_PRIVS+ liste blanche BPFseccompstricte) et exécutedockerddans le noyau en espace utilisateur gVisor (Sentry) de Google, conçu pour la sécurité mémoire. Toutes les capacitésUID 0invité, les montagesoverlayfs(ext4lite) et les règlesiptablesrestent strictement isolés à l'intérieur du processus de bac à sable.
 1# 1. Installer rungv en espace utilisateur (version précompilée attestée SLSA ou go install)
 2# Option A : vérifier et extraire le binaire précompilé attesté SLSA depuis les GitHub Releases
 3gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx \
 4  --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml \
 5  --source-ref refs/tags/v0.2.0 --deny-self-hosted-runners
 6tar -xzf rungv-v0.2.0-linux-amd64.tar.gz && install -m 0755 rungv-v0.2.0-linux-amd64/rungv ~/.local/bin/rungv
 7
 8# Option B : ou installer directement depuis les sources avec Go
 9CGO_ENABLED=0 GOBIN=~/.local/bin go install z.gfire.dev/gvx/cmd/rungv@latest
10
11# 2. Démarrer docker:dind dans gvx avec un volume ext4lite à fichier unique
12#    Redirige ~/.gvx/docker.sock (mode 0600) vers le port 2375 de l'invité
13mkdir -p ~/.gvx
14~/.local/bin/rungv run \
15  -p unix:~/.gvx/docker.sock:2375 \
16  -p 127.0.0.1:9000-9019:9000-9019 \
17  -v gvx-docker:/var/lib/docker \
18  -e DOCKER_TLS_CERTDIR= \
19  docker:dind --tls=false &
20
21# 3. Diriger le CLI Docker standard et Docker Compose vers la socket en espace utilisateur
22export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
23until docker info >/dev/null 2>&1; do sleep 0.5; done
24docker info --format '{{.Driver}} {{.OperatingSystem}}'
25# Sortie : overlayfs Alpine Linux ... (containerized)
26
27docker build -t app:test .
28docker run --rm app:test
29docker compose up -d
Pourquoi les outils rootless standard échouent dans les bacs à sable restreints
Lorsqu'un ingénieur ou un agent de codage autonome doit exécuter docker build, docker run ou docker compose dans un conteneur durci ou un runner multi-locataires, les contournements standard échouent sur cinq barrières noyau distinctes.
1. Absence de socket du démon Docker hôte (systemctl et service docker start échouent également)
L'exécution de docker ps ou docker build échoue immédiatement lorsque la socket hôte /var/run/docker.sock n'est pas montée dans l'environnement. Tenter de démarrer docker.io via systemctl ou service docker start échoue également, car le PID 1 n'est pas systemd et /etc/init.d/docker atteint le plafond strict ulimit -n du conteneur :
1Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
2ERROR: Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
3System has not been booted with systemd as init system (PID 1). Can't operate.
4Failed to connect to bus: Host is down
5/etc/init.d/docker: 62: ulimit: error setting limit (Operation not permitted)
2. PR_SET_NO_NEW_PRIVS bloque sudo et les assistants setuid
Les conteneurs durcis (securityContext.allowPrivilegeEscalation: false dans Kubernetes, --security-opt=no-new-privileges dans Docker, ou les bacs à sable exebox / bwrap) positionnent le bit Linux PR_SET_NO_NEW_PRIVS sur l'arborescence de processus. Toute tentative d'élévation via sudo ou des binaires setuid (newuidmap, newgidmap, fusermount3) échoue :
1sudo: The "no new privileges" flag is set, which prevents sudo from running as root.
2sudo: effective uid is not 0, is /usr/bin/sudo on a file system with the 'nosuid' option set or an NFS file system without root privileges?
3. Les politiques seccomp et sysctl bloquent unshare(CLONE_NEWUSER)
Les outils présentés comme « rootless » (Rootless Docker, Podman, Buildah, nerdctl, bubblewrap) reposent toujours sur les espaces de noms utilisateur Linux (CLONE_NEWUSER). Ils échouent dès que :
- Le profil seccomp par défaut du conteneur externe bloque
unshare(2)ouclone(CLONE_NEWUSER). - Ubuntu 24.04+ active
kernel.apparmor_restrict_unprivileged_userns = 1. - Les nœuds Debian ou RHEL définissent
kernel.unprivileged_userns_clone = 0ouuser.max_user_namespaces = 0. newuidmapne peut pas écrire dans/proc/self/uid_mapcarPR_SET_NO_NEW_PRIVSest actif.
Les erreurs obtenues ressemblent à ceci :
1unshare: unshare failed: Operation not permitted
2cannot clone: Operation not permitted
3Error: cannot re-exec process to join the existing user namespace
4newuidmap: write to uid_map failed: Operation not permitted
5RootlessKit: parent: failed to start the child: fork/exec /proc/self/exe: operation not permitted
4. mount(2) et pivot_root(2) sont bloqués pendant docker build sans CAP_SYS_ADMIN sur l'hôte
Même si un environnement autorise CLONE_NEWUSER, ou si dockerd est forcé de démarrer avec --iptables=false --bridge=none --storage-driver=vfs, l'exécution de docker build échoue dès la première instruction RUN, car le montage d'un nouveau /proc ou l'appel à pivot_root(2) dans un espace de noms de montage imbriqué est bloqué :
1ERROR: failed to solve: process "/bin/sh -c ..." did not complete successfully:
2mount("/proc", "/proc", "proc", MS_NOSUID|MS_NODEV|MS_NOEXEC, NULL): Operation not permitted
3OCI runtime create failed: runc create failed: unable to start container process: error during container init: error mounting "proc" to rootfs at "/proc": mount proc:/proc (via /proc/self/fd/6), flags: 0xe: operation not permitted
4OCI runtime create failed: runc create failed: unable to start container process: error during container init: error jailing process inside rootfs: pivot_root .: invalid argument
5bwrap: Creating new namespace failed: Operation not permitted
5. L'absence de /dev/fuse empêche fuse-overlayfs de fonctionner
Les moteurs de conteneurs rootless qui ne peuvent pas monter le overlayfs noyau se replient sur fuse-overlayfs. Dans les conteneurs minimalistes ou les pods Kubernetes sans transmission du périphérique /dev/fuse, fuse-overlayfs échoue immédiatement :
1fuse: device not found, try 'modprobe fuse' first
2fusermount3: failed to open /dev/fuse: No such file or directory
3error initializing graphdriver: driver not supported: fuse-overlayfs
Comment gvx exécute docker:dind entièrement en espace utilisateur
gvx contourne les cinq barrières noyau, car il ne demande pas au noyau Linux hôte de créer des espaces de noms, de monter des systèmes de fichiers ou de configurer des interfaces réseau. À la place, rungv exécute un noyau Linux interne en espace utilisateur (le Sentry de gVisor) ainsi qu'une pile réseau en espace utilisateur (netstack) à l'intérieur d'un unique processus ordinaire non privilégié.
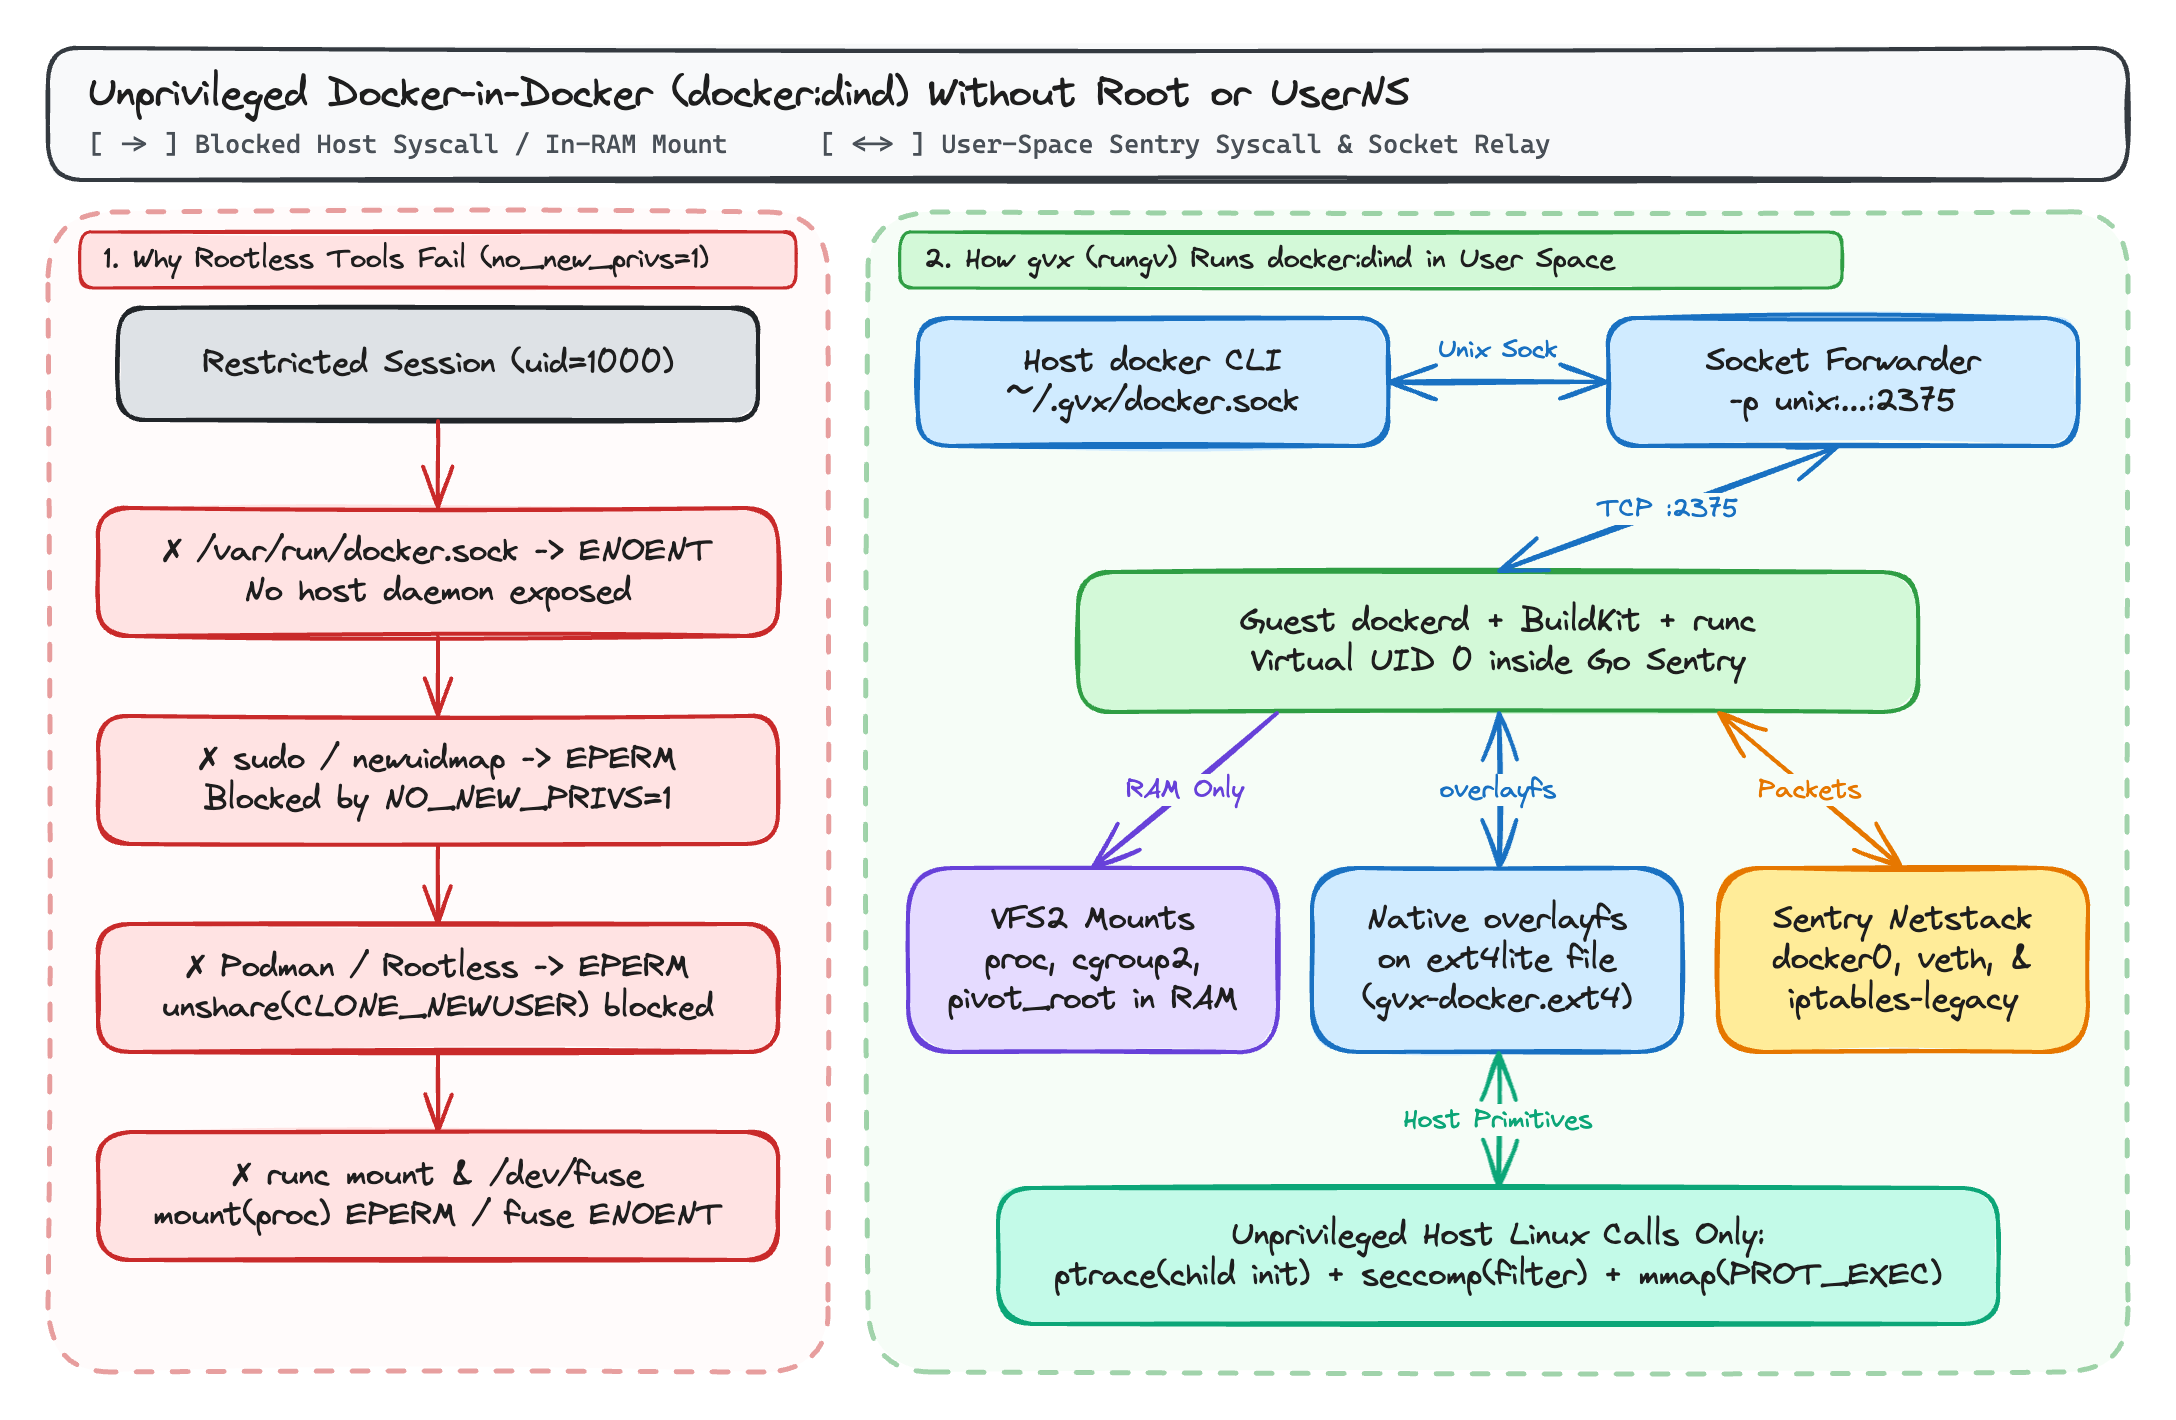
1. Espaces de noms et table de montage en mémoire (VFS2)
Lorsque dockerd, containerd et runc s'exécutent dans rungv, systrap intercepte leurs appels système et les achemine vers le noyau Sentry interne au processus, et non vers le noyau hôte :
unshare(2),clone(2),pivot_root(2),chroot(2)etmount(2)opèrent sur la hiérarchie de tâches en mémoire duSentryet sur la table de montageVFS2(procfs,sysfs,tmpfs,devpts,cgroupfsv2), tandis que le processus hôterungvs'exécute sous votre UID hôte non privilégié.
2. overlayfs natif sur des volumes ext4lite à fichier unique
Lorsque vous passez -v gvx-docker:/var/lib/docker (ou --mount type=volume,src=/disk/gvx-docker.ext4,dst=/var/lib/docker), gvx monte son système de fichiers intégré ext4lite sur /var/lib/docker.
Comme ext4lite implémente un système de fichiers ext4 journalisé en JBD2 au sein d'un unique fichier hôte (gvx-docker.ext4), avec la prise en charge des attributs étendus trusted.overlay.*, des périphériques whiteout de caractères (0:0), de d_type et de RENAME_EXCHANGE, dockerd utilise son pilote de stockage natif overlayfs à l'intérieur de l'invité. Les opérations docker build multi-étapes partagent des couches en copie sur écriture sans /dev/fuse et sans l'explosion d'espace disque du pilote de repli vfs de Docker.
3. Pont docker0 en espace utilisateur et iptables-legacy
Lorsque docker:dind démarre dans gvx :
- Le
dockerdinvité crée le pontdocker0(172.17.0.1/16), attache des pairesvethvirtuelles pour les conteneurs imbriqués, et programme les chaînesNAT(DOCKER,POSTROUTING) etFILTERavec les correspondancesaddrtypeetconntrackau sein de la pilenetstacken espace utilisateur degvx. - Le passage de
-p unix:~/.gvx/docker.sock:2375lie une socket Unix de domaine hôte (mode0600) et redirige directement les connexions vers le port2375dedockerdà l'intérieur du bac à sable.
Comparaison avec les outils de conteneurs existants
| Capacité / Contrainte | Docker standard (dockerd) | Docker rootless / Podman | Kaniko / Buildah (sans privilèges) | gvx (rungv + docker:dind) |
|---|---|---|---|---|
root ou sudo requis sur l'hôte | Oui | Non | Non | Non |
Fonctionne avec PR_SET_NO_NEW_PRIVS=1 | Non | Non (newuidmap échoue) | Partiellement | Oui |
Fonctionne quand unshare(CLONE_NEWUSER) est bloqué (EPERM) | N/A | Non | Buildah : Non / Kaniko : Oui | Oui |
Fonctionne sans /dev/fuse | Oui (utilise overlay2 noyau) | Uniquement via vfs lent | Oui | Oui (overlayfs sur ext4lite) |
Prend en charge docker build (BuildKit) | Oui | Oui (si userns autorisé) | Construction d'images uniquement (sans runtime) | Oui |
Prend en charge docker run et docker compose up | Oui | Oui (si userns autorisé) | Non | Oui |
| Fonctionne sous Windows et macOS sans VM Linux | Non (nécessite WSL2 / VM) | Non (nécessite une VM Linux) | Non | Oui (whpx, hvf, systrap) |
Exigences exactes du noyau hôte sous Linux
gvx ne requiert aucune capacité élevée (CapEff: 0000000000000000) ni aucun espace de noms utilisateur. Sur un hôte Linux, rungv repose uniquement sur trois primitives noyau standard non privilégiées :
ptrace(PTRACE_ATTACH)sur son propre thread enfant, une seule fois pendant l'initialisation :systrapcrée un thread auxiliaire de type stub local au démarrage, s'y attache pour initialiser le contexte de mémoire partagée, puis s'en détache. Si l'hôte définitkernel.yama.ptrace_scope = 3(ce qui désactiveptraceà l'échelle du système) ou bloqueptracedans un filtre seccomp externe, l'initialisation desystrapne peut pas aboutir. (Avecyama.ptrace_scope = 1, valeur par défaut sous Ubuntu et Debian,gvxfonctionne car le traçage parent vers enfant est autorisé.)seccomp(SECCOMP_SET_MODE_FILTER): utilisé pour intercepter les appels système invités émis par les threads stub du conteneur. Comme détaillé dans la troisième partie de cette série,gvxfonctionne aussi bien lorsqueSECCOMP_FILTER_FLAG_NEW_LISTENERest disponible que lorsqu'il renvoieEBUSYau sein d'un bac à sable imbriqué.mmap(..., PROT_EXEC, ...): utilisé pour mapper les segments ELF invités et le trampoline de mémoire partagée desystrap.
Exemple de bout en bout : construire et tester une application multi-conteneurs sans root
Le script suivant exécute un docker build complet ainsi qu'un test d'intégration à deux conteneurs (redis + conteneur applicatif) au sein d'une session utilisateur non privilégiée :
 1mkdir -p ~/.gvx
 2rungv run \
 3  -p unix:~/.gvx/docker.sock:2375 \
 4  -v gvx-docker:/var/lib/docker \
 5  -e DOCKER_TLS_CERTDIR= \
 6  docker:dind --tls=false &
 7DIND_PID=$!
 8
 9export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
10until docker info >/dev/null 2>&1; do sleep 0.5; done
11
12mkdir -p /tmp/demo-app && cd /tmp/demo-app
13cat <<'EOF' > Dockerfile
14FROM alpine:3.20
15RUN apk add --no-cache redis
16CMD ["redis-cli", "-h", "cache", "ping"]
17EOF
18
19# Construire l'image en utilisant overlayfs sur ext4lite
20docker build -t demo-ping:latest .
21
22# Créer un réseau de pont, démarrer Redis et vérifier la connectivité entre les conteneurs
23docker network create demo-net
24docker run -d --name cache --network demo-net redis:7-alpine
25docker run --rm --network demo-net demo-ping:latest
26# Sortie : PONG
27
28# Nettoyer les conteneurs de charge de travail et arrêter le bac à sable
29docker rm -f cache
30docker network rm demo-net
31kill -INT $DIND_PID
Pour aller plus loin dans cette série
- gvx : exécuter des conteneurs Linux, Docker et Kubernetes dans un seul processus non privilégié : présentation architecturale de
gvx, de ses moteurs d'exécution multiplateformes (whpx,hvf,systrap), deVFS2(erofs,ext4lite,hostfsv2) et denetstack. - Exécuter Docker, docker build et docker compose sans root ni espaces de noms utilisateur (cet article)
- Exécuter Docker-in-Docker au sein de gVisor et de bacs à sable imbriqués avec gvx : comment
gvxrésoutmodprobe,iptables-nft,overlay2surgofer, etSECCOMP_FILTER_FLAG_NEW_LISTENERimbriqué (EBUSY) au sein degVisor(runsc). - Environnements Docker isolés et rapides pour les déploiements RL d'agents IA avec gvx : mise à l'échelle d'environnements parallèles
SWE-benchet de déploiements RL, avec des réinitialisations de volumes.ext4en copie sur écriture en 100 millisecondes.