 GoSuda
Uruchamianie Dockera, docker build i docker compose bez uprawnień roota i bez przestrzeni nazw użytkowników

Szybkie rozwiązanie: bezpieczny Docker bez uprawnień administratora w trzech krokach
Jeśli pracujesz w zablokowanym kontenerze Linux, runnerze CI, podzie Kubernetes lub piaskownicy agenta kodującego AI (na przykład obliczeniowym środowisku agenta w chmurze), w którym zablokowano root, sudo, przestrzenie nazw użytkowników (unshare(CLONE_NEWUSER)), mount(2) oraz /dev/fuse, gvx (rungv) jest bezpiecznym, niskonakładowym i oszczędnym pod względem tokenów rozwiązaniem umożliwiającym uruchomienie pełnego silnika docker:dind w przestrzeni użytkownika.
Niskonakładowe, oszczędne pod względem tokenów rozwiązanie dla agentów kodujących AI: Gdy autonomiczny agent kodujący napotka błąd
Cannot connect to the Docker daemon, próba zainstalowania i poprawieniadocker.io,podmanlubrootlesskitw ograniczonym kontenerze zazwyczaj marnuje 15 do 30 wywołań narzędzi i dziesiątki tysięcy tokenów kontekstu, krążąc między błędamisystemctl,ulimit,iptables,unshareirunc, by ostatecznie się nie powieść lub wrócić do ręcznego przepisywaniaDockerfile. Dziękigvx(rungv) agent wykonuje jeden deterministyczny, trzyetapowy bootstrap w jednym kroku i od razu uruchamia standardowe poleceniadocker build,docker runorazdocker composebez zmian.
Dlaczego
gvxjest bezpieczny z założenia (nie jest obejściem eskalacji uprawnień): W przeciwieństwie do montowania hostowego/var/run/docker.socklub uruchamianiadocker run --privileged(które dają kontrolę na poziomie roota nad jądrem hosta),gvxnie omija ani nie osłabia żadnej polityki bezpieczeństwa hosta (PR_SET_NO_NEW_PRIVS,seccomp, AppArmor ani ograniczeń UID innych niż root). Zamiast tegorungvblokuje własny proces hosta (PR_SET_NO_NEW_PRIVS+ ścisła lista dozwolonych BPFseccomp) i uruchamiadockerdwewnątrz bezpiecznego pod względem pamięci jądra przestrzeni użytkownika gVisor (Sentry) firmy Google. Wszystkie możliwościUID 0gościa, montowaniaoverlayfs(ext4lite) oraz regułyiptablespozostają ściśle izolowane wewnątrz procesu piaskownicy.
 1# 1. Zainstaluj rungv w przestrzeni użytkownika (gotowe wydanie z atestacją SLSA lub go install)
 2# Opcja A: Zweryfikuj i wypakuj gotowy plik binarny z atestacją SLSA z GitHub Releases
 3gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx \
 4  --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml \
 5  --source-ref refs/tags/v0.2.0 --deny-self-hosted-runners
 6tar -xzf rungv-v0.2.0-linux-amd64.tar.gz && install -m 0755 rungv-v0.2.0-linux-amd64/rungv ~/.local/bin/rungv
 7
 8# Opcja B: Lub zainstaluj bezpośrednio ze źródeł za pomocą Go
 9CGO_ENABLED=0 GOBIN=~/.local/bin go install z.gfire.dev/gvx/cmd/rungv@latest
10
11# 2. Uruchom docker:dind wewnątrz gvx z woluminem ext4lite w postaci jednego pliku
12#    Przekierowuje ~/.gvx/docker.sock (tryb 0600) na port 2375 gościa
13mkdir -p ~/.gvx
14~/.local/bin/rungv run \
15  -p unix:~/.gvx/docker.sock:2375 \
16  -p 127.0.0.1:9000-9019:9000-9019 \
17  -v gvx-docker:/var/lib/docker \
18  -e DOCKER_TLS_CERTDIR= \
19  docker:dind --tls=false &
20
21# 3. Skieruj standardowy Docker CLI i Docker Compose na gniazdo w przestrzeni użytkownika
22export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
23until docker info >/dev/null 2>&1; do sleep 0.5; done
24docker info --format '{{.Driver}} {{.OperatingSystem}}'
25# Wynik: overlayfs Alpine Linux ... (containerized)
26
27docker build -t app:test .
28docker run --rm app:test
29docker compose up -d
Dlaczego standardowe narzędzia bez uprawnień root zawodzą w ograniczonych piaskownicach
Gdy inżynier lub autonomiczny agent kodujący potrzebuje uruchomić docker build, docker run lub docker compose wewnątrz utwardzonego kontenera lub wieloprzestrzennego runnera, standardowe obejścia zawodzą na pięciu odrębnych barierach jądra.
1. Brak gniazda demona Docker na hoście (także systemctl i service docker start zawodzą)
Uruchomienie docker ps lub docker build kończy się natychmiast niepowodzeniem, gdy host /var/run/docker.sock nie jest zamontowany w środowisku, a próba uruchomienia docker.io przez systemctl lub service docker start zawodzi, ponieważ PID 1 nie jest systemd, a /etc/init.d/docker napotyka twardy limit ulimit -n kontenera:
1Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
2ERROR: Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
3System has not been booted with systemd as init system (PID 1). Can't operate.
4Failed to connect to bus: Host is down
5/etc/init.d/docker: 62: ulimit: error setting limit (Operation not permitted)
2. PR_SET_NO_NEW_PRIVS blokuje sudo i pomocnicze programy setuid
Wzmocnione kontenery (securityContext.allowPrivilegeEscalation: false w Kubernetes, --security-opt=no-new-privileges w Dockerze lub piaskownice exebox / bwrap) ustawiają bit Linux PR_SET_NO_NEW_PRIVS w drzewie procesów. Próba eskalacji przez sudo lub binaria setuid (newuidmap, newgidmap, fusermount3) kończy się niepowodzeniem:
1sudo: The "no new privileges" flag is set, which prevents sudo from running as root.
2sudo: effective uid is not 0, is /usr/bin/sudo on a file system with the 'nosuid' option set or an NFS file system without root privileges?
3. Polityki seccomp i sysctl blokują unshare(CLONE_NEWUSER)
Narzędzia reklamowane jako „rootless” (Rootless Docker, Podman, Buildah, nerdctl, bubblewrap) nadal opierają się na przestrzeniach nazw użytkowników Linux (user namespaces, CLONE_NEWUSER). Zawodzą zawsze, gdy:
- Domyślny profil seccomp zewnętrznego kontenera blokuje
unshare(2)lubclone(CLONE_NEWUSER). - Ubuntu 24.04+ włącza
kernel.apparmor_restrict_unprivileged_userns = 1. - Węzły Debian lub RHEL ustawiają
kernel.unprivileged_userns_clone = 0lubuser.max_user_namespaces = 0. newuidmapnie może zapisać/proc/self/uid_map, ponieważ aktywne jestPR_SET_NO_NEW_PRIVS.
Powstające błędy wyglądają następująco:
1unshare: unshare failed: Operation not permitted
2cannot clone: Operation not permitted
3Error: cannot re-exec process to join the existing user namespace
4newuidmap: write to uid_map failed: Operation not permitted
5RootlessKit: parent: failed to start the child: fork/exec /proc/self/exe: operation not permitted
4. mount(2) i pivot_root(2) są blokowane podczas docker build bez CAP_SYS_ADMIN na hoście
Nawet jeśli środowisko zezwala na CLONE_NEWUSER lub dockerd zostanie wymuszony do uruchomienia z --iptables=false --bridge=none --storage-driver=vfs, docker build kończy się niepowodzeniem na pierwszej instrukcji RUN, ponieważ montowanie świeżego /proc lub wywołanie pivot_root(2) wewnątrz zagnieżdżonej przestrzeni nazw montowań jest zablokowane:
1ERROR: failed to solve: process "/bin/sh -c ..." did not complete successfully:
2mount("/proc", "/proc", "proc", MS_NOSUID|MS_NODEV|MS_NOEXEC, NULL): Operation not permitted
3OCI runtime create failed: runc create failed: unable to start container process: error during container init: error mounting "proc" to rootfs at "/proc": mount proc:/proc (via /proc/self/fd/6), flags: 0xe: operation not permitted
4OCI runtime create failed: runc create failed: unable to start container process: error during container init: error jailing process inside rootfs: pivot_root .: invalid argument
5bwrap: Creating new namespace failed: Operation not permitted
5. Brak /dev/fuse uniemożliwia działanie fuse-overlayfs
Silniki kontenerów bez uprawnień, które nie mogą zamontować jądrowego overlayfs, przechodzą na fuse-overlayfs. W minimalnych kontenerach lub podach Kubernetes bez przekazania urządzenia /dev/fuse fuse-overlayfs natychmiast zawodzi:
1fuse: device not found, try 'modprobe fuse' first
2fusermount3: failed to open /dev/fuse: No such file or directory
3error initializing graphdriver: driver not supported: fuse-overlayfs
Jak gvx uruchamia docker:dind w całości w przestrzeni użytkownika
gvx omija wszystkie pięć barier jądra, ponieważ nie prosi jądra Linux hosta o tworzenie przestrzeni nazw, montowanie systemów plików ani konfigurowanie interfejsów sieciowych. Zamiast tego rungv uruchamia wewnętrzne jądro Linux działające w przestrzeni użytkownika (gVisor Sentry) oraz stos sieciowy w przestrzeni użytkownika (netstack) wewnątrz jednego zwykłego procesu bez uprawnień.
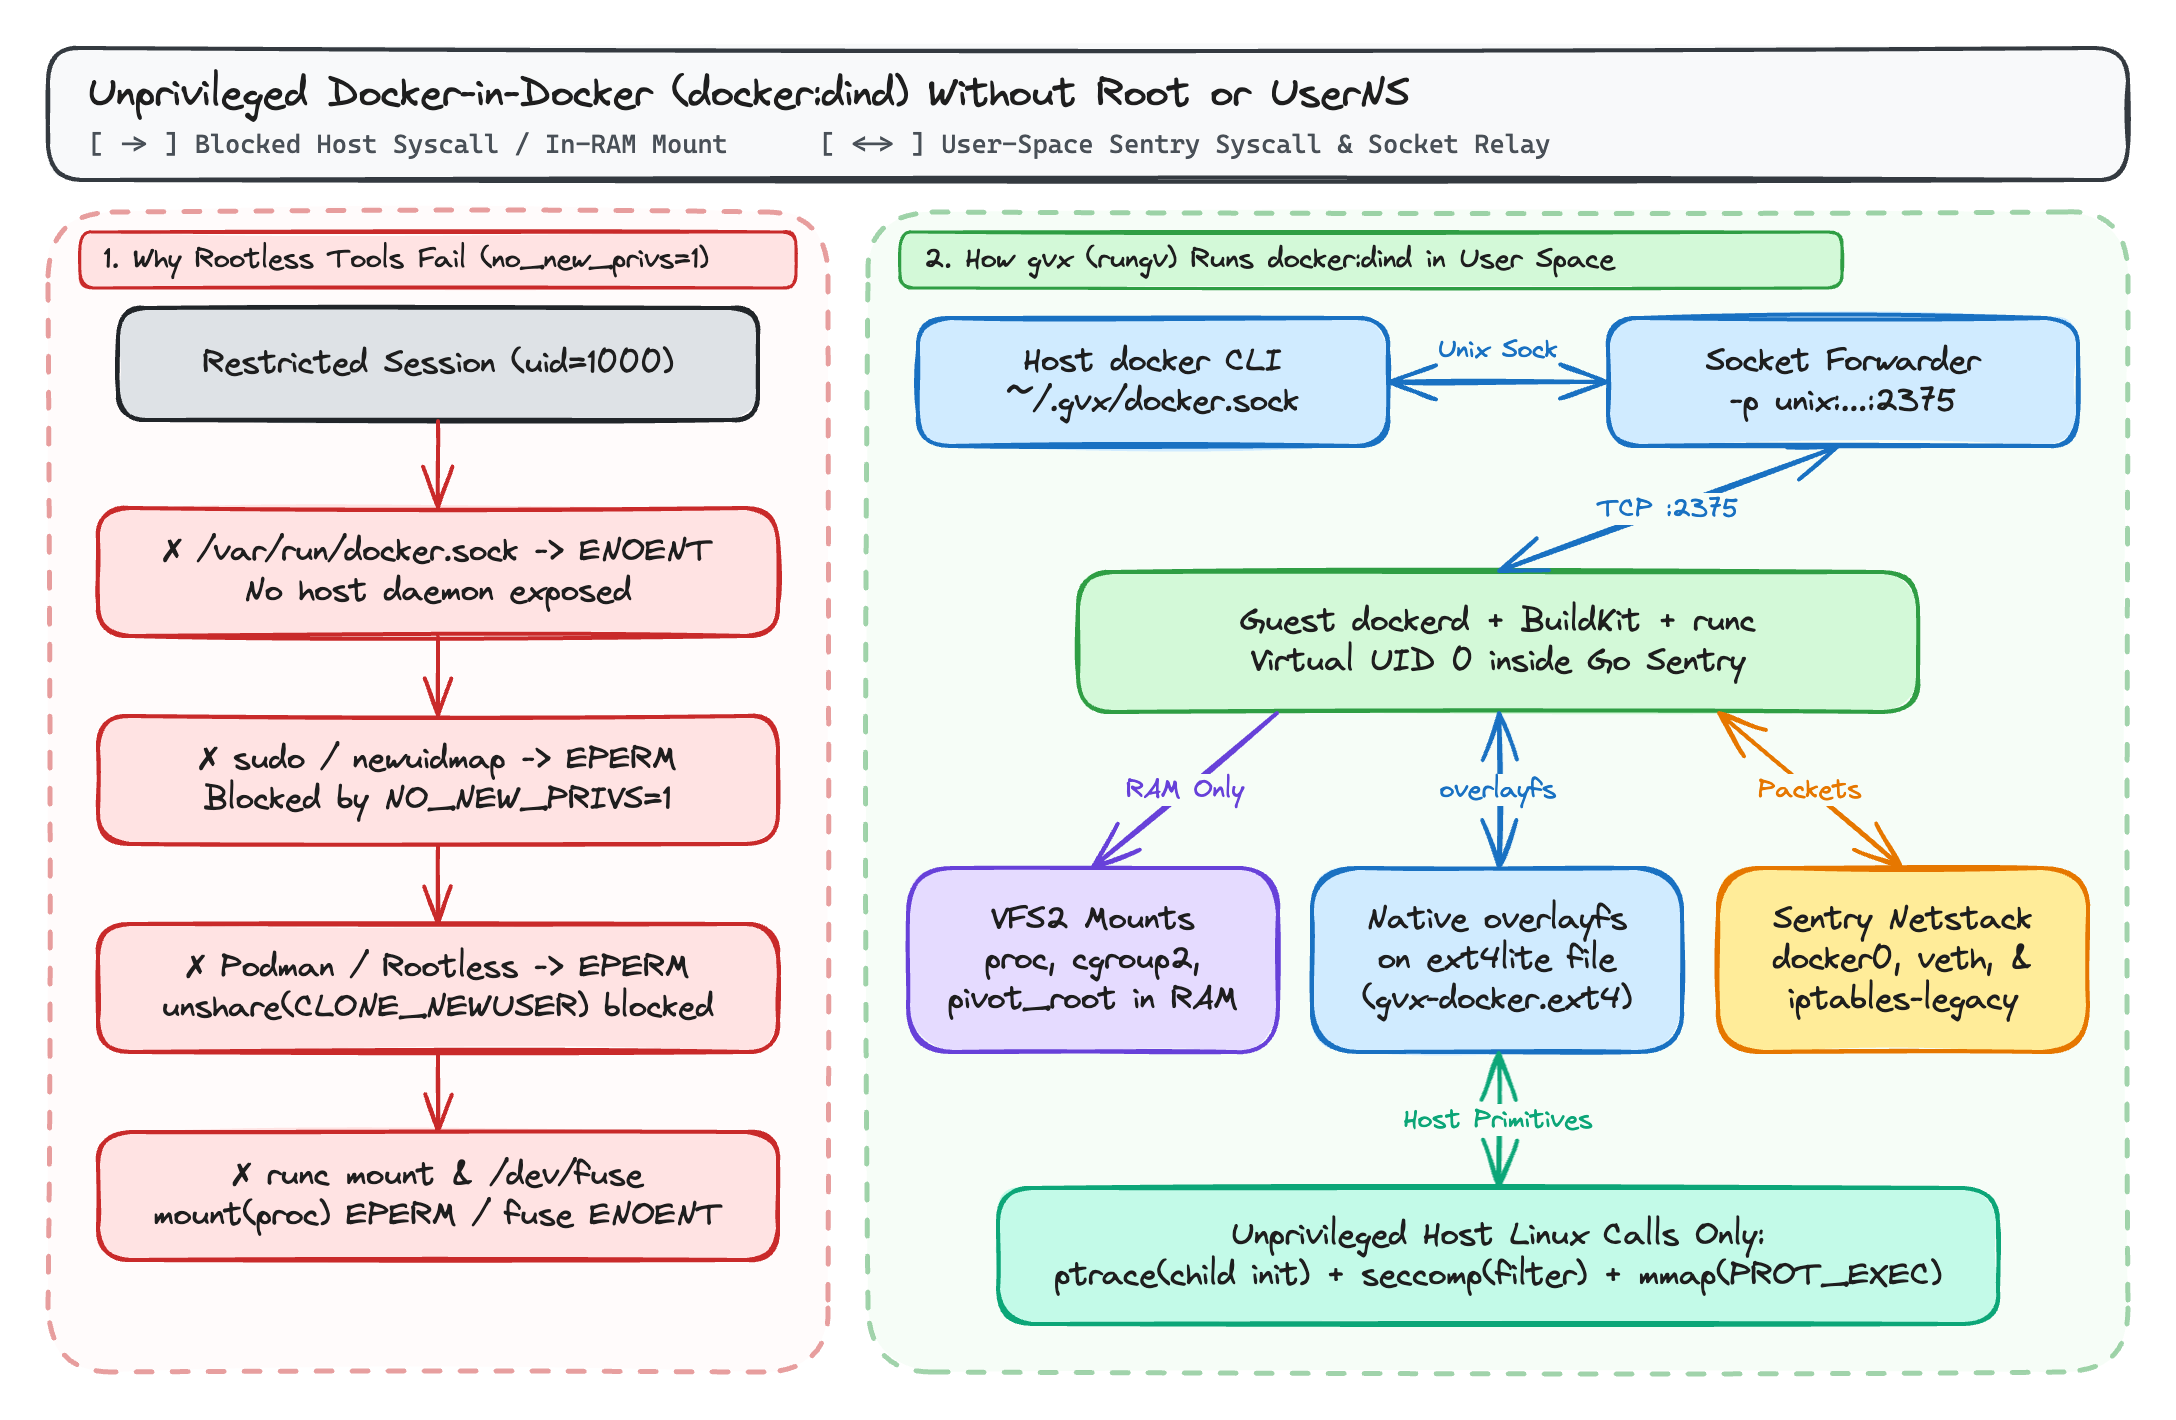
1. Przestrzenie nazw i tabela montowań w pamięci (VFS2)
Gdy dockerd, containerd i runc są wykonywane wewnątrz rungv, systrap przechwytuje ich wywołania systemowe i kieruje je do wewnątrzprocesowego jądra Sentry, a nie do jądra hosta:
unshare(2),clone(2),pivot_root(2),chroot(2)imount(2)działają na strukturze zadań Sentry w pamięci oraz tabeli montowańVFS2(procfs,sysfs,tmpfs,devpts,cgroupfsv2), podczas gdy proces hostarungvdziała pod Twoim nieuprzywilejowanym UID hosta.
2. Natywny overlayfs na woluminach ext4lite w postaci pojedynczego pliku
Gdy przekażesz -v gvx-docker:/var/lib/docker (lub --mount type=volume,src=/disk/gvx-docker.ext4,dst=/var/lib/docker), gvx montuje wbudowany system plików ext4lite w /var/lib/docker.
Ponieważ ext4lite implementuje system plików ext4 z dziennikiem JBD2 wewnątrz pojedynczego pliku hosta (gvx-docker.ext4), z obsługą rozszerzonych atrybutów trusted.overlay.*, znakowych urządzeń whiteout (0:0), d_type oraz RENAME_EXCHANGE, dockerd używa natywnego sterownika pamięci masowej overlayfs wewnątrz gościa. Wieloetapowe operacje docker build współdzielą warstwy Copy-on-Write bez /dev/fuse i bez eksplozji zajętości dysku, jaka występuje w zapasowym sterowniku vfs Dockera.
3. Mostek docker0 w przestrzeni użytkownika i iptables-legacy
Gdy docker:dind uruchamia się wewnątrz gvx:
dockerdgościa tworzy mostekdocker0(172.17.0.1/16), podłącza wirtualne paryvethdla zagnieżdżonych kontenerów i programuje łańcuchyNAT(DOCKER,POSTROUTING) orazFILTERz dopasowaniamiaddrtypeiconntrackwewnątrz stosunetstackgvxdziałającego w przestrzeni użytkownika.- Przekazanie
-p unix:~/.gvx/docker.sock:2375wiąże gniazdo domeny Unix hosta (tryb0600) i przekazuje połączenia bezpośrednio na port2375dockerdwewnątrz piaskownicy.
Porównanie z istniejącymi narzędziami kontenerowymi
| Możliwość / ograniczenie | Standardowy Docker (dockerd) | Rootless Docker / Podman | Kaniko / Buildah (bez uprawnień) | gvx (rungv + docker:dind) |
|---|---|---|---|---|
Wymagany host root lub sudo | Tak | Nie | Nie | Nie |
Działa z PR_SET_NO_NEW_PRIVS=1 | Nie | Nie (newuidmap nie działa) | Częściowo | Tak |
Działa, gdy unshare(CLONE_NEWUSER) jest zablokowane (EPERM) | Nie dotyczy | Nie | Buildah: Nie / Kaniko: Tak | Tak |
Działa bez /dev/fuse | Tak (używa jądrowego overlay2) | Tylko przez wolne kopiowanie vfs | Tak | Tak (overlayfs na ext4lite) |
Obsługuje docker build (BuildKit) | Tak | Tak (jeśli userns jest dozwolone) | Tylko budowanie obrazów (bez środowiska uruchomieniowego) | Tak |
Obsługuje docker run i docker compose up | Tak | Tak (jeśli userns jest dozwolone) | Nie | Tak |
| Działa na Windows i macOS bez maszyny wirtualnej Linux | Nie (wymaga WSL2 / VM) | Nie (wymaga maszyny wirtualnej Linux) | Nie | Tak (whpx, hvf, systrap) |
Dokładne wymagania jądra hosta w Linuksie
gvx nie wymaga żadnych podwyższonych uprawnień (CapEff: 0000000000000000) ani przestrzeni nazw użytkowników. Na hoście Linux rungv opiera się wyłącznie na trzech standardowych, nieuprzywilejowanych prymitywach jądra:
ptrace(PTRACE_ATTACH)na własnym wątku potomnym, jednorazowo podczas inicjalizacji:systrapuruchamia lokalny wątek pomocniczy (stub) przy starcie, dołącza się do niego, aby zainicjować kontekst pamięci współdzielonej, a następnie się odłącza. Jeśli host ustawikernel.yama.ptrace_scope = 3(co wyłącza wszystkieptracew całym systemie) lub zablokujeptracew zewnętrznym filtrze seccomp, inicjalizacjasystrapnie może się zakończyć. (Przyyama.ptrace_scope = 1, domyślnym ustawieniu w Ubuntu i Debianie,gvxdziała poprawnie, ponieważ śledzenie od procesu nadrzędnego do potomnego jest dozwolone.)seccomp(SECCOMP_SET_MODE_FILTER): Służy do przechwytywania wywołań systemowych gościa z wątków pomocniczych kontenera. Jak opisano w części 3 tej serii,gvxdziała zarówno wtedy, gdySECCOMP_FILTER_FLAG_NEW_LISTENERjest dostępne, jak i gdy zwracaEBUSYw zagnieżdżonej piaskownicy.mmap(..., PROT_EXEC, ...): Służy do mapowania segmentów ELF gościa oraz trampoliny pamięci współdzielonejsystrap.
Przykład end-to-end: budowanie i testowanie aplikacji wielokontenerowej bez roota
Poniższy skrypt uruchamia kompletne docker build oraz dwukontenerowy test integracyjny (redis + kontener aplikacji) w sesji użytkownika bez uprawnień:
 1mkdir -p ~/.gvx
 2rungv run \
 3  -p unix:~/.gvx/docker.sock:2375 \
 4  -v gvx-docker:/var/lib/docker \
 5  -e DOCKER_TLS_CERTDIR= \
 6  docker:dind --tls=false &
 7DIND_PID=$!
 8
 9export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
10until docker info >/dev/null 2>&1; do sleep 0.5; done
11
12mkdir -p /tmp/demo-app && cd /tmp/demo-app
13cat <<'EOF' > Dockerfile
14FROM alpine:3.20
15RUN apk add --no-cache redis
16CMD ["redis-cli", "-h", "cache", "ping"]
17EOF
18
19# Zbuduj obraz, używając overlayfs na ext4lite
20docker build -t demo-ping:latest .
21
22# Utwórz sieć mostkową, uruchom Redis i sprawdź łączność między kontenerami
23docker network create demo-net
24docker run -d --name cache --network demo-net redis:7-alpine
25docker run --rm --network demo-net demo-ping:latest
26# Wynik: PONG
27
28# Usuń kontenery robocze i zatrzymaj piaskownicę
29docker rm -f cache
30docker network rm demo-net
31kill -INT $DIND_PID
Dalsza lektura w tej serii
- gvx: Uruchamianie kontenerów Linux, Docker i Kubernetes w jednym nieuprzywilejowanym procesie: Przegląd architektury
gvx, jego wieloplatformowych silników wykonawczych (whpx,hvf,systrap),VFS2(erofs,ext4lite,hostfsv2) oraznetstack. - Uruchamianie Docker, docker build i docker compose bez roota i przestrzeni nazw użytkowników (ten wpis)
- Uruchamianie Docker-in-Docker wewnątrz gVisor i zagnieżdżonych piaskownic z gvx: Jak
gvxrozwiązuje problemymodprobe,iptables-nft,overlay2nagoferoraz zagnieżdżoneSECCOMP_FILTER_FLAG_NEW_LISTENER(EBUSY) wewnątrzgVisor(runsc). - Szybkie izolowane środowiska Docker dla rolloutów RL agentów AI z gvx: Skalowanie równoległych środowisk
SWE-benchi rolloutów RL dzięki resetom woluminów.ext4typu copy-on-write w 100 milisekund.