 GoSuda
Ejecución de Docker, docker build y docker compose sin privilegios de root ni espacios de nombres de usuario

Solución rápida: ejecutar Docker sin privilegios en tres pasos
Si trabaja dentro de un contenedor Linux bloqueado, un runner de CI, un Kubernetes Pod o el entorno sandbox de un agente de codificación con IA (como un entorno de cómputo en la nube para agentes) donde root, sudo, los user namespaces (unshare(CLONE_NEWUSER)), mount(2) y /dev/fuse están bloqueados, gvx (rungv) es la solución segura, de bajo esfuerzo y eficiente en tokens para ejecutar un motor docker:dind completo en espacio de usuario.
Solución de bajo esfuerzo y eficiente en tokens para agentes de codificación con IA: Cuando un agente de codificación autónomo encuentra
Cannot connect to the Docker daemon, intentar instalar y parcheardocker.io,podmanorootlesskitdentro de un contenedor restringido suele desperdiciar entre 15 y 30 turnos de llamadas a herramientas y decenas de miles de tokens de contexto alternando entre errores desystemctl,ulimit,iptables,unshareyrunc, para terminar fracasando o recurriendo a reescribir losDockerfilea mano. Congvx(rungv), el agente ejecuta un arranque determinista de 3 pasos en un solo turno y de inmediato ejecuta los comandos estándardocker build,docker runydocker composesin modificaciones.
Por qué
gvxes seguro por diseño (no es un workaround de escalada de privilegios): A diferencia de montar el/var/run/docker.sockdel host o de ejecutardocker run --privileged(que otorgan un control equivalente a root sobre el kernel del host),gvxno evita ni debilita ninguna política de seguridad del host (PR_SET_NO_NEW_PRIVS,seccomp, AppArmor o los límites de UID no root). En cambio,rungvbloquea su propio proceso del host (PR_SET_NO_NEW_PRIVS+ una allowlist BPFseccompestricta) y ejecutadockerddentro del kernel de espacio de usuario gVisor (Sentry) de Google, que tiene seguridad de memoria. Todas las capabilities deUID 0del invitado, los montajesoverlayfs(ext4lite) y las reglas deiptablespermanecen estrictamente aisladas dentro del proceso del sandbox.
 1# 1. Instalar rungv en el espacio de usuario (binario precompilado con atestación SLSA o go install)
 2# Opción A: Verificar y extraer el binario precompilado con atestación SLSA desde GitHub Releases
 3gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx \
 4  --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml \
 5  --source-ref refs/tags/v0.2.0 --deny-self-hosted-runners
 6tar -xzf rungv-v0.2.0-linux-amd64.tar.gz && install -m 0755 rungv-v0.2.0-linux-amd64/rungv ~/.local/bin/rungv
 7
 8# Opción B: o instalar directamente desde el código fuente con Go
 9CGO_ENABLED=0 GOBIN=~/.local/bin go install z.gfire.dev/gvx/cmd/rungv@latest
10
11# 2. Iniciar docker:dind dentro de gvx con un volumen ext4lite de un solo archivo
12#    Reenvía ~/.gvx/docker.sock (modo 0600) al puerto 2375 del invitado
13mkdir -p ~/.gvx
14~/.local/bin/rungv run \
15  -p unix:~/.gvx/docker.sock:2375 \
16  -p 127.0.0.1:9000-9019:9000-9019 \
17  -v gvx-docker:/var/lib/docker \
18  -e DOCKER_TLS_CERTDIR= \
19  docker:dind --tls=false &
20
21# 3. Apuntar la CLI estándar de Docker y Docker Compose al socket del espacio de usuario
22export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
23until docker info >/dev/null 2>&1; do sleep 0.5; done
24docker info --format '{{.Driver}} {{.OperatingSystem}}'
25# Salida: overlayfs Alpine Linux ... (containerized)
26
27docker build -t app:test .
28docker run --rm app:test
29docker compose up -d
Por qué las herramientas estándar sin root fallan en sandboxes restringidos
Cuando un ingeniero o un agente de codificación autónomo necesita ejecutar docker build, docker run o docker compose dentro de un contenedor endurecido o de un runner multiinquilino, los workarounds habituales fallan en cinco barreras distintas del kernel.
1. No hay socket del daemon de Docker en el host (systemctl y service docker start también fallan)
Ejecutar docker ps o docker build falla de inmediato cuando el /var/run/docker.sock del host no está montado en el entorno, e intentar iniciar docker.io mediante systemctl o service docker start también falla, porque PID 1 no es systemd y /etc/init.d/docker choca con el límite duro ulimit -n del contenedor:
1Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
2ERROR: Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
3System has not been booted with systemd as init system (PID 1). Can't operate.
4Failed to connect to bus: Host is down
5/etc/init.d/docker: 62: ulimit: error setting limit (Operation not permitted)
2. PR_SET_NO_NEW_PRIVS bloquea sudo y los helpers setuid
Los contenedores endurecidos (securityContext.allowPrivilegeEscalation: false en Kubernetes, --security-opt=no-new-privileges en Docker, o sandboxes exebox / bwrap) activan el bit PR_SET_NO_NEW_PRIVS de Linux en el árbol de procesos. Intentar escalar privilegios mediante sudo o binarios setuid (newuidmap, newgidmap, fusermount3) falla:
1sudo: The "no new privileges" flag is set, which prevents sudo from running as root.
2sudo: effective uid is not 0, is /usr/bin/sudo on a file system with the 'nosuid' option set or an NFS file system without root privileges?
3. Las políticas de seccomp y sysctl bloquean unshare(CLONE_NEWUSER)
Las herramientas promocionadas como "sin root" (Rootless Docker, Podman, Buildah, nerdctl, bubblewrap) siguen dependiendo de los user namespaces de Linux (CLONE_NEWUSER). Fallan siempre que:
- El perfil seccomp predeterminado del contenedor externo bloquea
unshare(2)oclone(CLONE_NEWUSER). - Ubuntu 24.04+ habilita
kernel.apparmor_restrict_unprivileged_userns = 1. - Los nodos Debian o RHEL establecen
kernel.unprivileged_userns_clone = 0ouser.max_user_namespaces = 0. newuidmapno puede escribir en/proc/self/uid_mapporquePR_SET_NO_NEW_PRIVSestá activo.
Los errores resultantes tienen este aspecto:
1unshare: unshare failed: Operation not permitted
2cannot clone: Operation not permitted
3Error: cannot re-exec process to join the existing user namespace
4newuidmap: write to uid_map failed: Operation not permitted
5RootlessKit: parent: failed to start the child: fork/exec /proc/self/exe: operation not permitted
4. mount(2) y pivot_root(2) están bloqueados durante docker build sin CAP_SYS_ADMIN en el host
Incluso si un entorno permite CLONE_NEWUSER o si dockerd se fuerza a iniciar con --iptables=false --bridge=none --storage-driver=vfs, ejecutar docker build falla en la primera instrucción RUN, porque montar un /proc nuevo o llamar a pivot_root(2) dentro de un mount namespace anidado está bloqueado:
1ERROR: failed to solve: process "/bin/sh -c ..." did not complete successfully:
2mount("/proc", "/proc", "proc", MS_NOSUID|MS_NODEV|MS_NOEXEC, NULL): Operation not permitted
3OCI runtime create failed: runc create failed: unable to start container process: error during container init: error mounting "proc" to rootfs at "/proc": mount proc:/proc (via /proc/self/fd/6), flags: 0xe: operation not permitted
4OCI runtime create failed: runc create failed: unable to start container process: error during container init: error jailing process inside rootfs: pivot_root .: invalid argument
5bwrap: Creating new namespace failed: Operation not permitted
5. La falta de /dev/fuse rompe fuse-overlayfs
Los motores de contenedores sin root que no pueden montar el overlayfs del kernel recurren a fuse-overlayfs. En contenedores mínimos o pods de Kubernetes sin passthrough del dispositivo /dev/fuse, fuse-overlayfs falla de inmediato:
1fuse: device not found, try 'modprobe fuse' first
2fusermount3: failed to open /dev/fuse: No such file or directory
3error initializing graphdriver: driver not supported: fuse-overlayfs
Cómo gvx ejecuta docker:dind completamente en espacio de usuario
gvx evita las cinco barreras del kernel porque no pide al kernel Linux del host que cree namespaces, monte sistemas de archivos ni configure interfaces de red. En cambio, rungv ejecuta un kernel Linux interno de espacio de usuario (el Sentry de gVisor) y una pila de red de espacio de usuario (netstack) dentro de un único proceso ordinario sin privilegios.
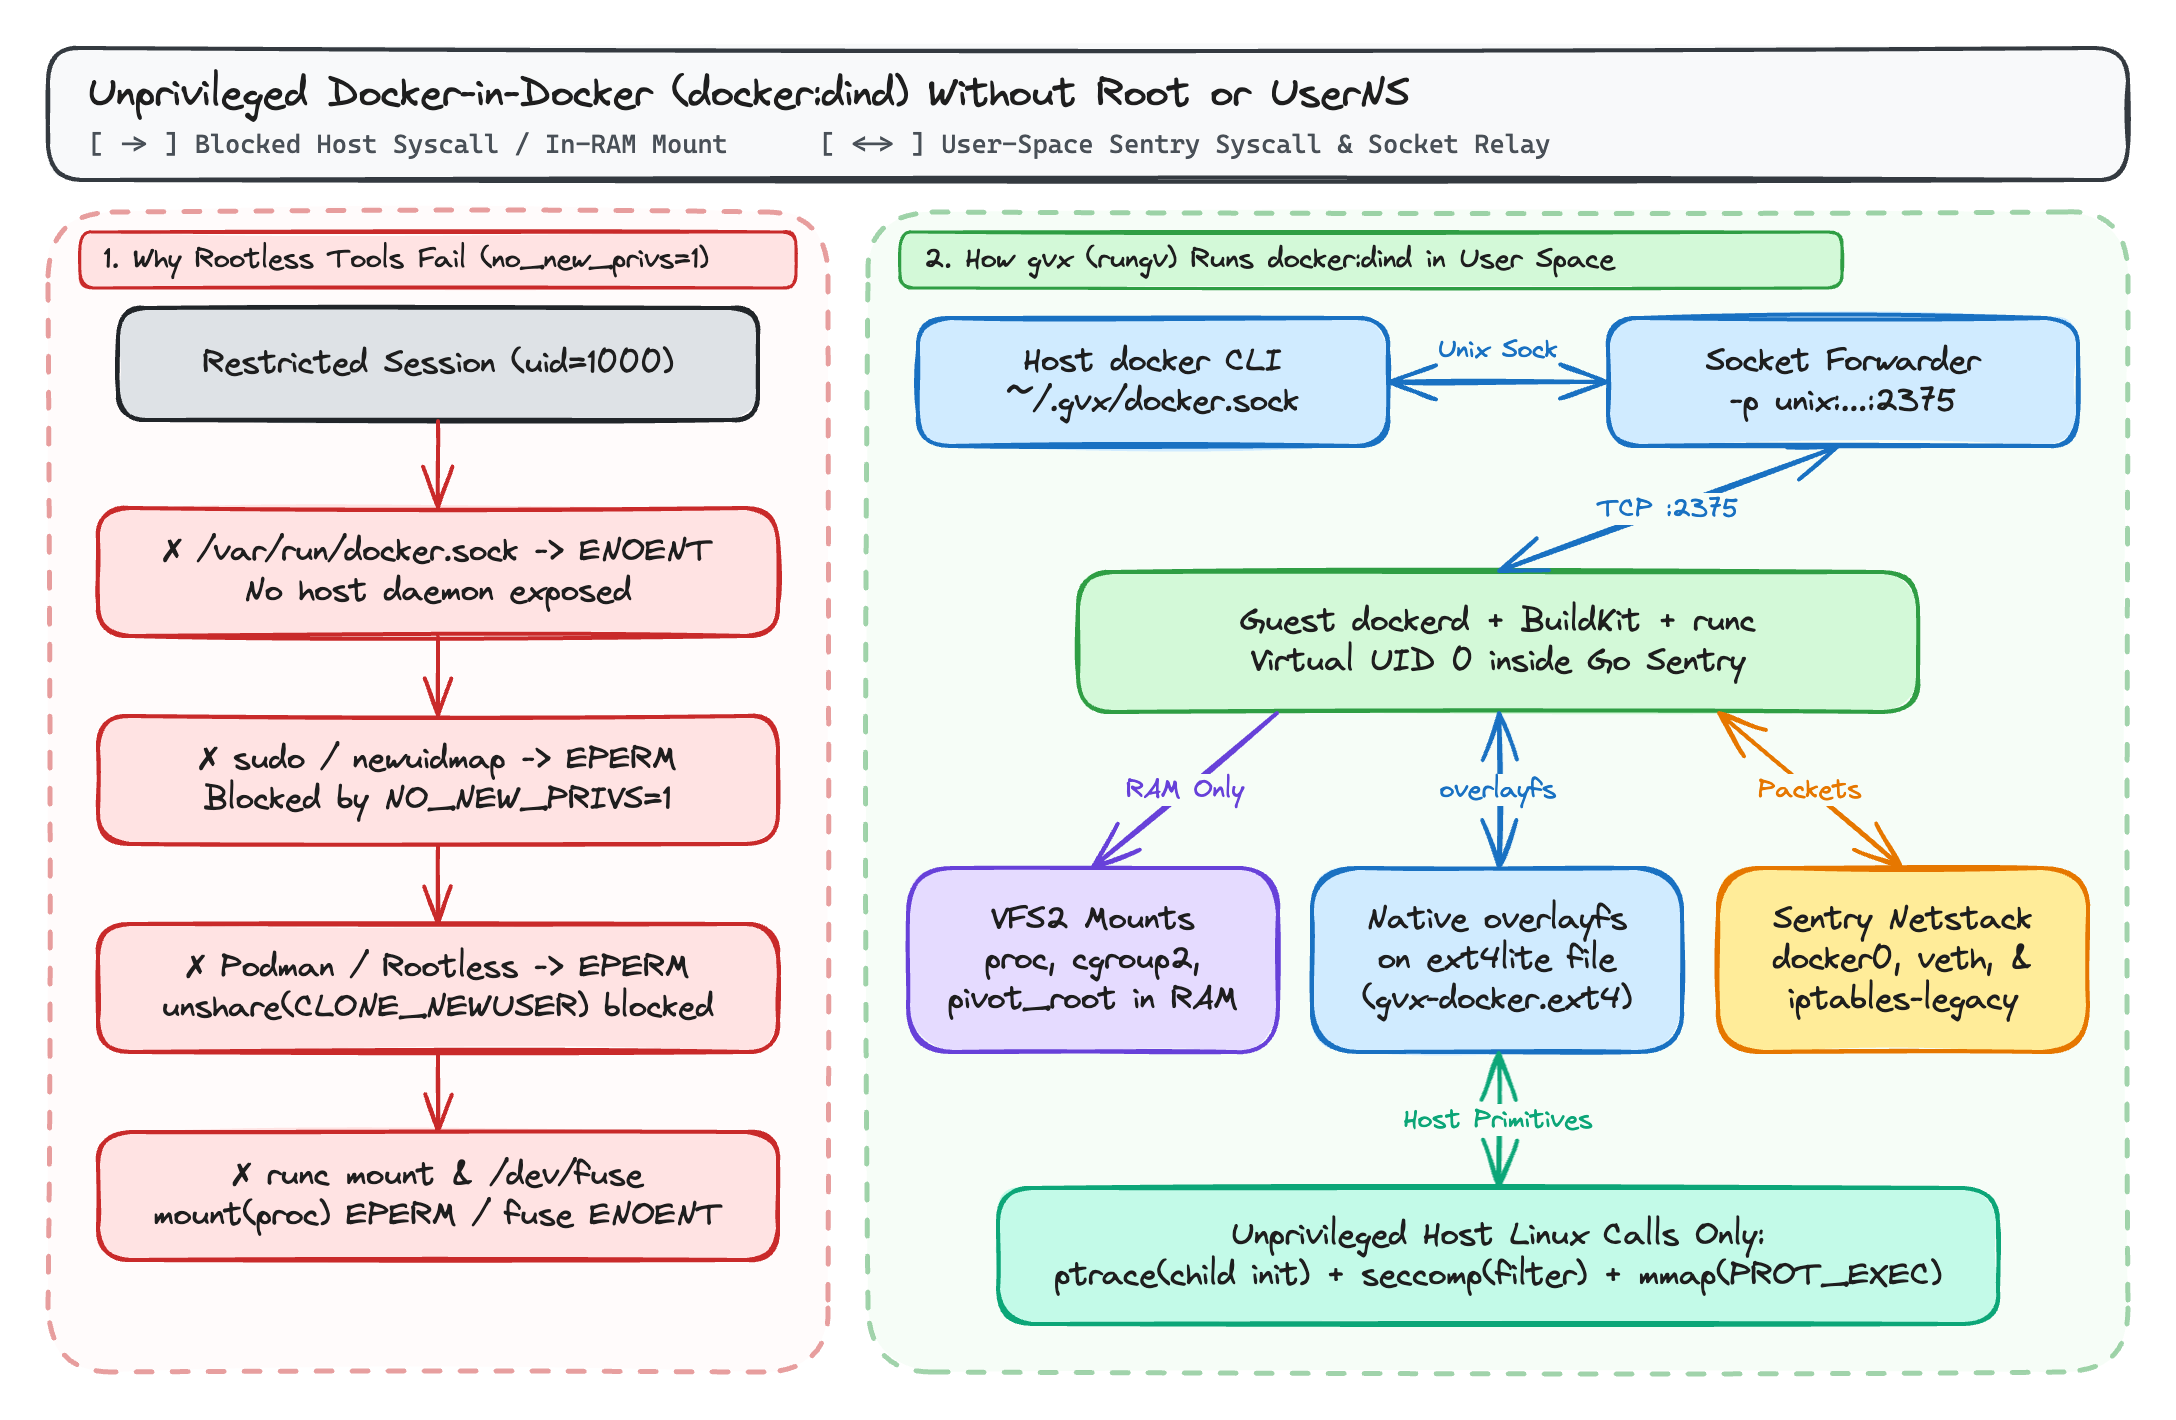
1. Namespaces en memoria y tabla de montajes (VFS2)
Cuando dockerd, containerd y runc se ejecutan dentro de rungv, systrap intercepta sus llamadas al sistema y las envía al kernel Sentry en proceso, en lugar de al kernel del host:
unshare(2),clone(2),pivot_root(2),chroot(2)ymount(2)operan sobre la jerarquía de tareas en memoria del Sentry y sobre la tabla de montajesVFS2(procfs,sysfs,tmpfs,devpts,cgroupfsv2), mientras el proceso del hostrungvse ejecuta bajo su UID de host sin privilegios.
2. overlayfs nativo sobre volúmenes ext4lite de un solo archivo
Cuando pasa -v gvx-docker:/var/lib/docker (o --mount type=volume,src=/disk/gvx-docker.ext4,dst=/var/lib/docker), gvx monta su sistema de archivos integrado ext4lite en /var/lib/docker.
Dado que ext4lite implementa un sistema de archivos ext4 con journaling JBD2 dentro de un único archivo del host (gvx-docker.ext4), con soporte para los atributos extendidos trusted.overlay.*, los dispositivos whiteout de caracteres (0:0), d_type y RENAME_EXCHANGE, dockerd utiliza su controlador de almacenamiento nativo overlayfs dentro del invitado. Las operaciones docker build de varias etapas comparten capas Copy-on-Write sin necesidad de /dev/fuse y sin la explosión de espacio en disco del controlador de respaldo vfs de Docker.
3. Puente docker0 en espacio de usuario e iptables-legacy
Cuando docker:dind se inicia dentro de gvx:
- El
dockerddel invitado crea el puentedocker0(172.17.0.1/16), conecta paresvethvirtuales para los contenedores anidados y programa las cadenasNAT(DOCKER,POSTROUTING) yFILTERcon coincidenciasaddrtypeyconntrackdentro delnetstackde espacio de usuario degvx. - Pasar
-p unix:~/.gvx/docker.sock:2375enlaza un socket de dominio Unix del host (modo0600) y reenvía las conexiones directamente al puerto2375dedockerddentro del sandbox.
Comparación con las herramientas de contenedores existentes
| Capacidad / Restricción | Docker estándar (dockerd) | Docker sin root / Podman | Kaniko / Buildah (sin privilegios) | gvx (rungv + docker:dind) |
|---|---|---|---|---|
Requiere root o sudo en el host | Sí | No | No | No |
Funciona con PR_SET_NO_NEW_PRIVS=1 | No | No (newuidmap falla) | Parcial | Sí |
Funciona cuando unshare(CLONE_NEWUSER) está bloqueado (EPERM) | N/A | No | Buildah: No / Kaniko: Sí | Sí |
Funciona sin /dev/fuse | Sí (usa overlay2 del kernel) | Solo mediante vfs lento con copia | Sí | Sí (overlayfs sobre ext4lite) |
Admite docker build (BuildKit) | Sí | Sí (si userns está permitido) | Solo construcción de imágenes (sin runtime) | Sí |
Admite docker run y docker compose up | Sí | Sí (si userns está permitido) | No | Sí |
| Se ejecuta en Windows y macOS sin una VM Linux | No (requiere WSL2 / VM) | No (requiere VM Linux) | No | Sí (whpx, hvf, systrap) |
Requisitos exactos del kernel del host en Linux
gvx requiere cero capabilities elevadas (CapEff: 0000000000000000) y cero user namespaces. En un host Linux, rungv depende solo de tres primitivas estándar del kernel sin privilegios:
ptrace(PTRACE_ATTACH)sobre su propio hilo hijo una vez durante la inicialización:systrapcrea un hilo auxiliar stub local al iniciarse, se adjunta a él para inicializar el contexto de memoria compartida y luego se desadjunta. Si el host establecekernel.yama.ptrace_scope = 3(lo que deshabilitaptraceen todo el sistema) o bloqueaptraceen un filtro seccomp externo, la inicialización desystrapno puede completarse. (Conyama.ptrace_scope = 1, el valor predeterminado en Ubuntu y Debian,gvxfunciona porque se permite el trazado de padre a hijo.)seccomp(SECCOMP_SET_MODE_FILTER): se usa para interceptar las llamadas al sistema del invitado desde los hilos stub del contenedor. Como se explica en la Parte 3 de esta serie,gvxfunciona tanto cuandoSECCOMP_FILTER_FLAG_NEW_LISTENERestá disponible como cuando devuelveEBUSYdentro de un sandbox anidado.mmap(..., PROT_EXEC, ...): se usa para mapear los segmentos ELF del invitado y el trampolín de memoria compartida desystrap.
Ejemplo completo: construir y probar una aplicación multicontenedor sin root
El siguiente script ejecuta un docker build completo y una prueba de integración con dos contenedores (redis + contenedor de la aplicación) dentro de una sesión de usuario sin privilegios:
 1mkdir -p ~/.gvx
 2rungv run \
 3  -p unix:~/.gvx/docker.sock:2375 \
 4  -v gvx-docker:/var/lib/docker \
 5  -e DOCKER_TLS_CERTDIR= \
 6  docker:dind --tls=false &
 7DIND_PID=$!
 8
 9export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
10until docker info >/dev/null 2>&1; do sleep 0.5; done
11
12mkdir -p /tmp/demo-app && cd /tmp/demo-app
13cat <<'EOF' > Dockerfile
14FROM alpine:3.20
15RUN apk add --no-cache redis
16CMD ["redis-cli", "-h", "cache", "ping"]
17EOF
18
19# Construir la imagen usando overlayfs sobre ext4lite
20docker build -t demo-ping:latest .
21
22# Crear una red bridge, iniciar Redis y verificar la conectividad entre contenedores
23docker network create demo-net
24docker run -d --name cache --network demo-net redis:7-alpine
25docker run --rm --network demo-net demo-ping:latest
26# Salida: PONG
27
28# Limpiar los contenedores de carga de trabajo y detener el sandbox
29docker rm -f cache
30docker network rm demo-net
31kill -INT $DIND_PID
Lecturas adicionales en esta serie
- gvx: Ejecutar contenedores Linux, Docker y Kubernetes en un solo proceso sin privilegios: visión general de la arquitectura de
gvx, sus motores de ejecución multiplataforma (whpx,hvf,systrap),VFS2(erofs,ext4lite,hostfsv2) ynetstack. - Ejecutar Docker, docker build y docker compose sin root ni user namespaces (esta entrada)
- Ejecutar Docker-in-Docker dentro de gVisor y sandboxes anidados con gvx: cómo
gvxresuelvemodprobe,iptables-nft,overlay2sobregoferySECCOMP_FILTER_FLAG_NEW_LISTENERanidado (EBUSY) dentro degVisor(runsc). - Entornos Docker aislados y rápidos para rollouts de RL de agentes de IA con gvx: escalado de entornos paralelos de
SWE-benchy rollouts de RL con reinicios de volúmenes.ext4Copy-on-Write de 100 milisegundos.