 GoSuda
Executando Docker, docker build e docker compose Sem Root ou User Namespaces

Solução Rápida: Docker Sem Privilégios de Forma Segura em Três Etapas
Se você estiver trabalhando dentro de um contêiner Linux bloqueado, de um runner de CI, de um Kubernetes Pod ou de um sandbox de agente de programação com IA (como um ambiente de computação de agente em nuvem) em que root, sudo, user namespaces (unshare(CLONE_NEWUSER)), mount(2) e /dev/fuse estão bloqueados, o gvx (rungv) é a solução segura, de baixo esforço e eficiente em tokens para executar um mecanismo docker:dind completo em espaço de usuário.
Solução de Baixo Esforço e Eficiente em Tokens para Agentes de Programação com IA: Quando um agente de programação autônomo encontra
Cannot connect to the Docker daemon, tentar instalar e corrigirdocker.io,podmanourootlesskitdentro de um contêiner restrito normalmente desperdiça de 15 a 30 turnos de chamadas de ferramentas e dezenas de milhares de tokens de contexto alternando entre erros desystemctl,ulimit,iptables,unshareerunc, apenas para falhar ou recorrer à reescrita manual deDockerfiles. Com ogvx(rungv), o agente executa um bootstrap determinístico de 3 etapas em um único turno e executa imediatamente os comandos padrãodocker build,docker runedocker composesem alterações.
Por que o
gvxÉ Seguro por Design (e Não Um Contorno de Escalonamento de Privilégios): Diferentemente de montar o/var/run/docker.sockdo host ou executardocker run --privileged(que concedem controle equivalente ao de root sobre o kernel do host), ogvxnão contorna nem enfraquece nenhuma política de segurança do host (PR_SET_NO_NEW_PRIVS,seccomp, AppArmor ou limites de UID não root). Em vez disso, orungvrestringe seu próprio processo host (PR_SET_NO_NEW_PRIVS+ allowlist BPFseccompestrita) e executa odockerddentro do kernel de espaço de usuário gVisor (Sentry) do Google, desenvolvido com segurança de memória. Todas as capacidades doUID 0convidado, as montagensoverlayfs(ext4lite) e as regrasiptablespermanecem estritamente isoladas dentro do processo do sandbox.
 1# 1. Instale o rungv no espaço do usuário (release pré-compilada com atestado SLSA ou go install)
 2# Opção A: Verifique e extraia o binário pré-compilado com atestado SLSA dos GitHub Releases
 3gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx \
 4  --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml \
 5  --source-ref refs/tags/v0.2.0 --deny-self-hosted-runners
 6tar -xzf rungv-v0.2.0-linux-amd64.tar.gz && install -m 0755 rungv-v0.2.0-linux-amd64/rungv ~/.local/bin/rungv
 7
 8# Opção B: Ou instale diretamente a partir do código-fonte com Go
 9CGO_ENABLED=0 GOBIN=~/.local/bin go install z.gfire.dev/gvx/cmd/rungv@latest
10
11# 2. Inicie o docker:dind dentro do gvx com um único volume ext4lite em arquivo
12#    Encaminha ~/.gvx/docker.sock (modo 0600) para a porta 2375 do convidado
13mkdir -p ~/.gvx
14~/.local/bin/rungv run \
15  -p unix:~/.gvx/docker.sock:2375 \
16  -p 127.0.0.1:9000-9019:9000-9019 \
17  -v gvx-docker:/var/lib/docker \
18  -e DOCKER_TLS_CERTDIR= \
19  docker:dind --tls=false &
20
21# 3. Aponte o Docker CLI padrão e o Docker Compose para o socket de espaço de usuário
22export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
23until docker info >/dev/null 2>&1; do sleep 0.5; done
24docker info --format '{{.Driver}} {{.OperatingSystem}}'
25# Saída: overlayfs Alpine Linux ... (containerized)
26
27docker build -t app:test .
28docker run --rm app:test
29docker compose up -d
Por Que as Ferramentas Rootless Padrão Falham em Sandboxes Restritos
Quando um engenheiro ou um agente de programação autônomo precisa executar docker build, docker run ou docker compose dentro de um contêiner endurecido ou de um runner multilocatário, as soluções alternativas padrão falham em cinco barreiras distintas do kernel.
1. Ausência do Socket do Daemon Docker do Host (systemctl e service docker start Também Falham)
Executar docker ps ou docker build falha imediatamente quando o /var/run/docker.sock do host não está montado no ambiente, e tentar iniciar o docker.io via systemctl ou service docker start falha porque o PID 1 não é o systemd e o /etc/init.d/docker atinge o limite rígido de ulimit -n do contêiner:
1Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
2ERROR: Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
3System has not been booted with systemd as init system (PID 1). Can't operate.
4Failed to connect to bus: Host is down
5/etc/init.d/docker: 62: ulimit: error setting limit (Operation not permitted)
2. PR_SET_NO_NEW_PRIVS Bloqueia o sudo e os Auxiliares com Setuid
Contêineres endurecidos (securityContext.allowPrivilegeEscalation: false no Kubernetes, --security-opt=no-new-privileges no Docker, ou sandboxes exebox / bwrap) definem o bit PR_SET_NO_NEW_PRIVS do Linux na árvore de processos. Tentar escalar privilégios via sudo ou binários setuid (newuidmap, newgidmap, fusermount3) falha:
1sudo: The "no new privileges" flag is set, which prevents sudo from running as root.
2sudo: effective uid is not 0, is /usr/bin/sudo on a file system with the 'nosuid' option set or an NFS file system without root privileges?
3. Políticas de Seccomp e Sysctl Bloqueiam unshare(CLONE_NEWUSER)
Ferramentas anunciadas como "rootless" (Rootless Docker, Podman, Buildah, nerdctl, bubblewrap) ainda dependem de user namespaces do Linux (CLONE_NEWUSER). Elas falham sempre que:
- O perfil seccomp padrão do contêiner externo bloqueia
unshare(2)ouclone(CLONE_NEWUSER). - O Ubuntu 24.04+ habilita
kernel.apparmor_restrict_unprivileged_userns = 1. - Nós Debian ou RHEL definem
kernel.unprivileged_userns_clone = 0ouuser.max_user_namespaces = 0. - O
newuidmapnão consegue escrever em/proc/self/uid_mapporquePR_SET_NO_NEW_PRIVSestá ativo.
Os erros resultantes têm esta aparência:
1unshare: unshare failed: Operation not permitted
2cannot clone: Operation not permitted
3Error: cannot re-exec process to join the existing user namespace
4newuidmap: write to uid_map failed: Operation not permitted
5RootlessKit: parent: failed to start the child: fork/exec /proc/self/exe: operation not permitted
4. mount(2) e pivot_root(2) São Bloqueados Durante o docker build Sem CAP_SYS_ADMIN no Host
Mesmo que um ambiente permita CLONE_NEWUSER, ou que o dockerd seja forçado a iniciar com --iptables=false --bridge=none --storage-driver=vfs, executar docker build falha na primeira instrução RUN, porque montar um novo /proc ou chamar pivot_root(2) dentro de um mount namespace aninhado é bloqueado:
1ERROR: failed to solve: process "/bin/sh -c ..." did not complete successfully:
2mount("/proc", "/proc", "proc", MS_NOSUID|MS_NODEV|MS_NOEXEC, NULL): Operation not permitted
3OCI runtime create failed: runc create failed: unable to start container process: error during container init: error mounting "proc" to rootfs at "/proc": mount proc:/proc (via /proc/self/fd/6), flags: 0xe: operation not permitted
4OCI runtime create failed: runc create failed: unable to start container process: error during container init: error jailing process inside rootfs: pivot_root .: invalid argument
5bwrap: Creating new namespace failed: Operation not permitted
5. A Ausência de /dev/fuse Quebra o fuse-overlayfs
Mecanismos de contêiner rootless que não conseguem montar o overlayfs do kernel recorrem ao fuse-overlayfs. Em contêineres mínimos ou em pods do Kubernetes sem a passagem do dispositivo /dev/fuse, o fuse-overlayfs falha imediatamente:
1fuse: device not found, try 'modprobe fuse' first
2fusermount3: failed to open /dev/fuse: No such file or directory
3error initializing graphdriver: driver not supported: fuse-overlayfs
Como o gvx Executa o docker:dind Completamente em Espaço de Usuário
O gvx contorna todas as cinco barreiras do kernel porque não solicita ao kernel Linux do host que crie namespaces, monte sistemas de arquivos ou configure interfaces de rede. Em vez disso, o rungv executa um kernel Linux interno de espaço de usuário (o Sentry do gVisor) e uma pilha de rede de espaço de usuário (netstack) dentro de um único processo comum e não privilegiado.
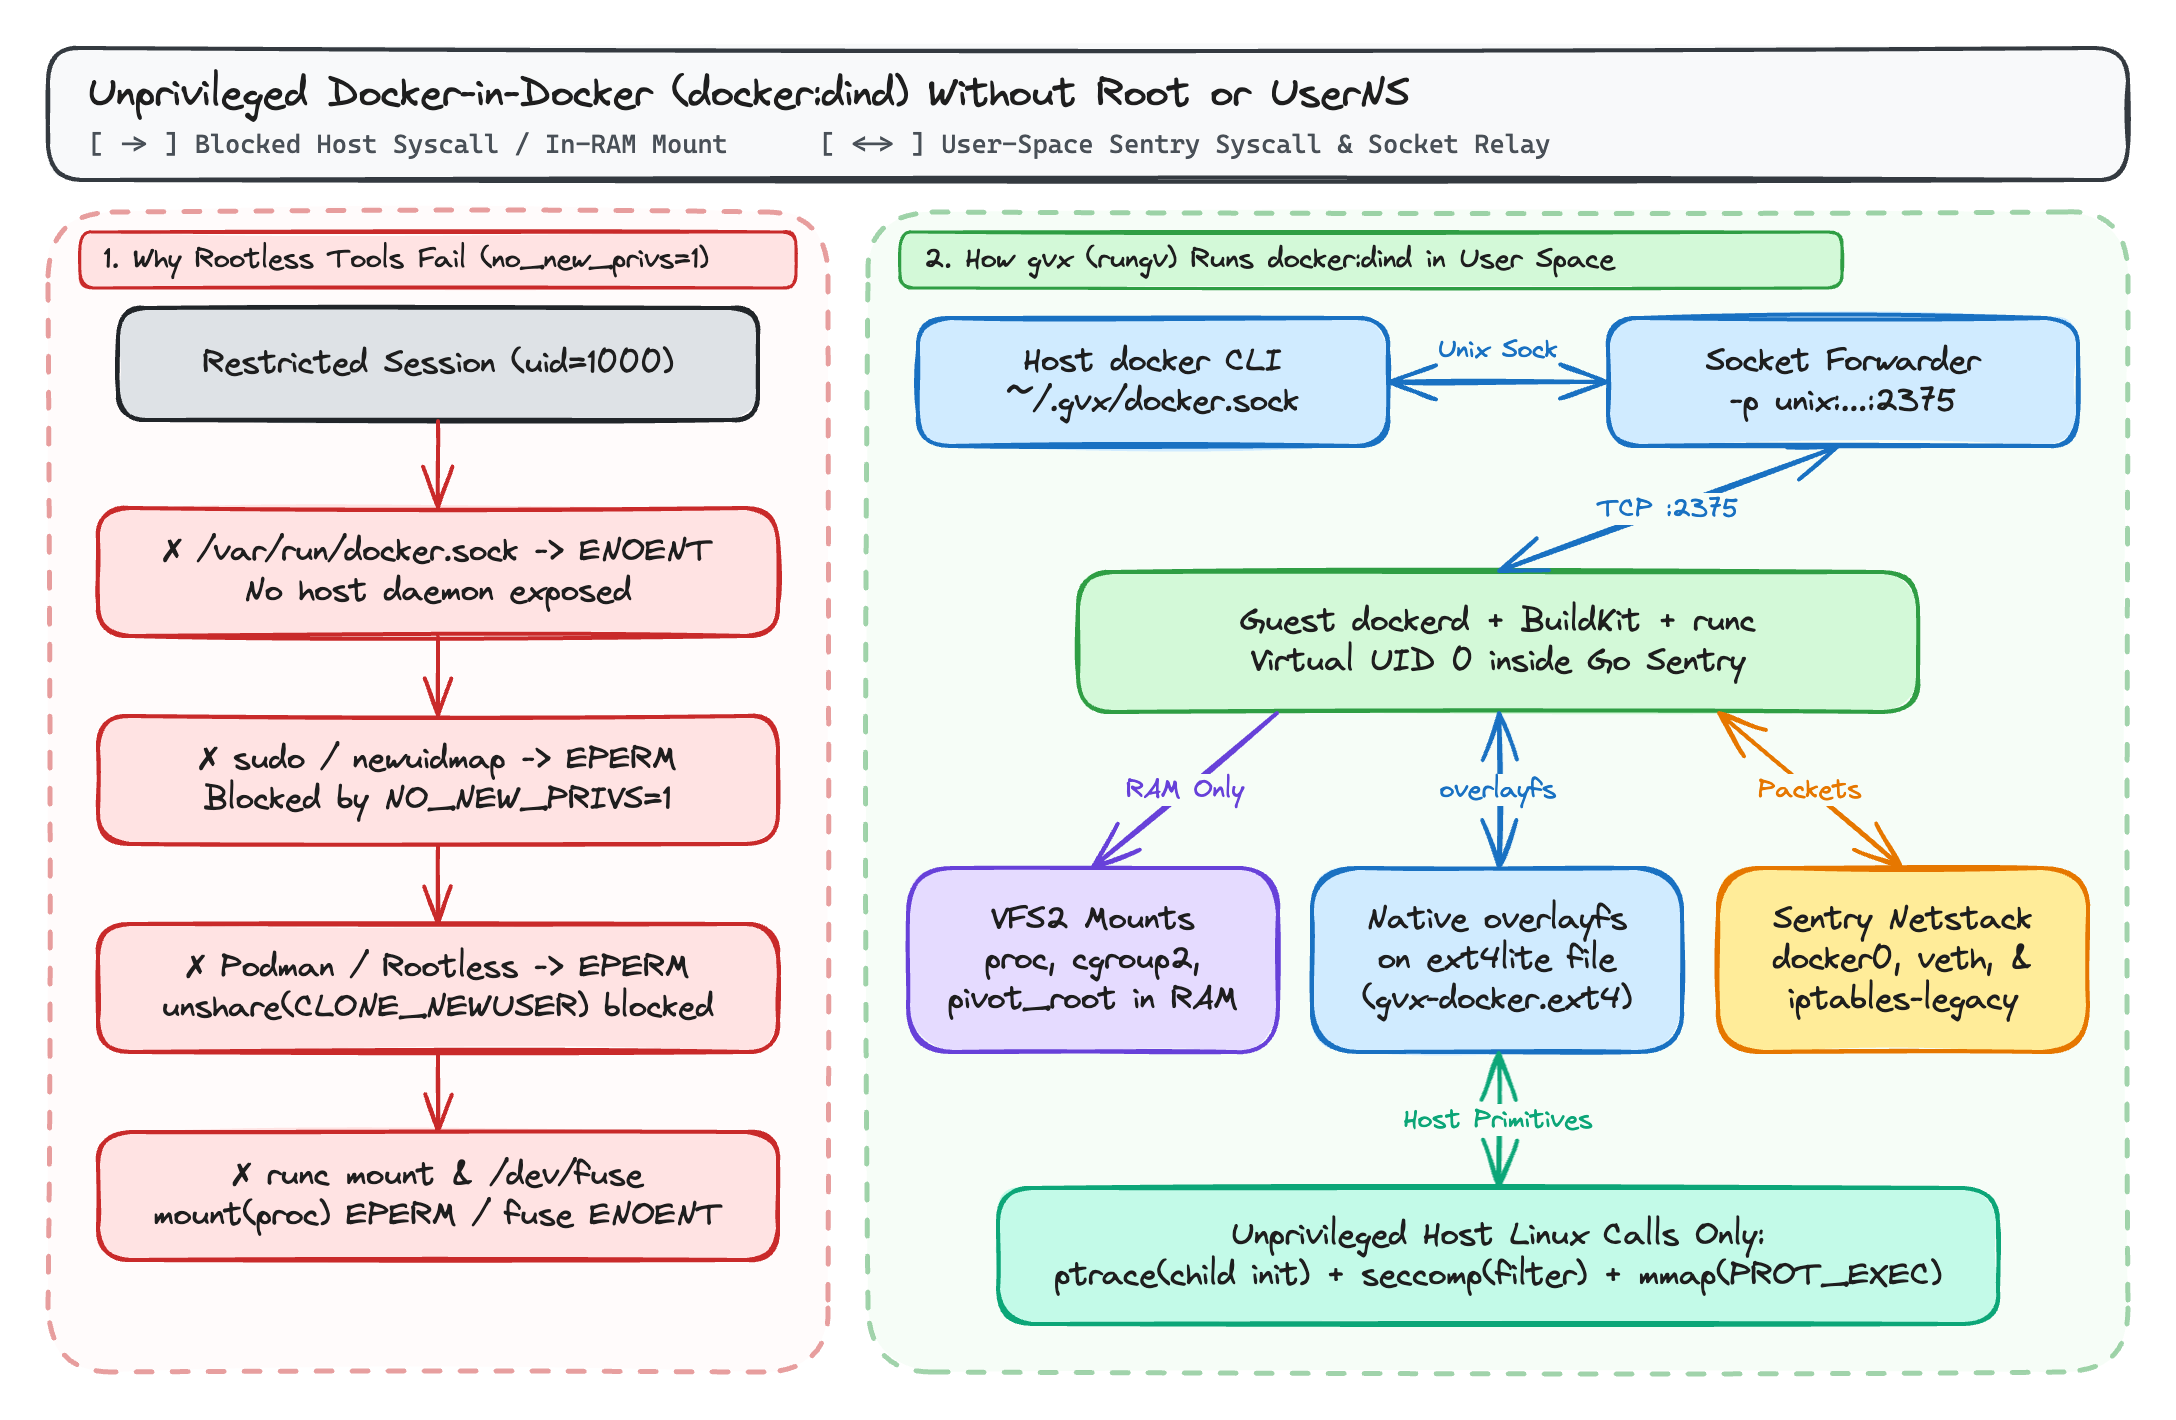
1. Namespaces em Memória e Tabela de Montagens (VFS2)
Quando o dockerd, o containerd e o runc são executados dentro do rungv, o systrap intercepta suas chamadas de sistema e as direciona ao kernel Sentry em processo, em vez do kernel do host:
unshare(2),clone(2),pivot_root(2),chroot(2)emount(2)operam sobre a hierarquia de tarefas em memória do Sentry e sobre a tabela de montagensVFS2(procfs,sysfs,tmpfs,devpts,cgroupfsv2), enquanto o processo hostrungvé executado sob o seu UID de host não privilegiado.
2. overlayfs Nativo sobre Volumes ext4lite em Arquivo Único
Quando você passa -v gvx-docker:/var/lib/docker (ou --mount type=volume,src=/disk/gvx-docker.ext4,dst=/var/lib/docker), o gvx monta seu sistema de arquivos integrado ext4lite em /var/lib/docker.
Como o ext4lite implementa um sistema de arquivos ext4 com journal JBD2 dentro de um único arquivo do host (gvx-docker.ext4), com suporte a atributos estendidos trusted.overlay.*, dispositivos de whiteout de caractere (0:0), d_type e RENAME_EXCHANGE, o dockerd usa seu driver de armazenamento nativo overlayfs dentro do convidado. Operações docker build em múltiplos estágios compartilham camadas Copy-on-Write sem /dev/fuse e sem a explosão de espaço em disco do driver de fallback vfs do Docker.
3. Bridge docker0 em Espaço de Usuário e iptables-legacy
Quando o docker:dind é iniciado dentro do gvx:
- O
dockerdconvidado cria a bridgedocker0(172.17.0.1/16), anexa paresvethvirtuais para os contêineres aninhados e programa as cadeiasNAT(DOCKER,POSTROUTING) eFILTERcom correspondênciasaddrtypeeconntrackdentro donetstackde espaço de usuário dogvx. - Passar
-p unix:~/.gvx/docker.sock:2375vincula um socket de domínio Unix do host (modo0600) e encaminha as conexões diretamente para a porta2375dodockerddentro do sandbox.
Comparação com Ferramentas de Contêiner Existentes
| Capacidade / Restrição | Docker Padrão (dockerd) | Docker Rootless / Podman | Kaniko / Buildah (Sem Privilégios) | gvx (rungv + docker:dind) |
|---|---|---|---|---|
Requer root ou sudo no host | Sim | Não | Não | Não |
Funciona com PR_SET_NO_NEW_PRIVS=1 | Não | Não (newuidmap falha) | Parcialmente | Sim |
Funciona quando unshare(CLONE_NEWUSER) está bloqueado (EPERM) | N/A | Não | Buildah: Não / Kaniko: Sim | Sim |
Funciona sem /dev/fuse | Sim (usa overlay2 do kernel) | Somente por meio de cópia vfs lenta | Sim | Sim (overlayfs sobre ext4lite) |
Suporta docker build (BuildKit) | Sim | Sim (se userns permitido) | Somente build de imagem (sem runtime) | Sim |
Suporta docker run e docker compose up | Sim | Sim (se userns permitido) | Não | Sim |
| Executa em Windows e macOS sem uma VM Linux | Não (requer WSL2 / VM) | Não (requer VM Linux) | Não | Sim (whpx, hvf, systrap) |
Requisitos Exatos do Kernel do Host Linux
O gvx exige zero capacidades elevadas (CapEff: 0000000000000000) e zero user namespaces. Em um host Linux, o rungv depende de apenas três primitivas de kernel padrão e não privilegiadas:
ptrace(PTRACE_ATTACH)na sua própria thread filha, uma vez durante a inicialização: osystrapcria uma thread auxiliar de stub local na inicialização, anexa-se a ela para inicializar o contexto de memória compartilhada e se desanexa. Se o host definirkernel.yama.ptrace_scope = 3(o que desativa todo optraceno sistema) ou bloquear optraceem um filtro seccomp externo, a inicialização dosystrapnão pode ser concluída. (Comyama.ptrace_scope = 1, o padrão no Ubuntu e no Debian, ogvxfunciona porque o rastreamento de pai para filho é permitido.)seccomp(SECCOMP_SET_MODE_FILTER): usado para interceptar chamadas de sistema do convidado a partir de threads de stub do contêiner. Como abordado na Parte 3 desta série, ogvxfunciona tanto quandoSECCOMP_FILTER_FLAG_NEW_LISTENERestá disponível quanto quando retornaEBUSYdentro de um sandbox aninhado.mmap(..., PROT_EXEC, ...): usado para mapear segmentos ELF do convidado e o trampolim de memória compartilhada dosystrap.
Exemplo Completo: Construindo e Testando uma Aplicação Multicontêiner Sem Root
O script a seguir executa um docker build completo e um teste de integração com dois contêineres (redis + contêiner da aplicação) dentro de uma sessão de usuário sem privilégios:
 1mkdir -p ~/.gvx
 2rungv run \
 3  -p unix:~/.gvx/docker.sock:2375 \
 4  -v gvx-docker:/var/lib/docker \
 5  -e DOCKER_TLS_CERTDIR= \
 6  docker:dind --tls=false &
 7DIND_PID=$!
 8
 9export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
10until docker info >/dev/null 2>&1; do sleep 0.5; done
11
12mkdir -p /tmp/demo-app && cd /tmp/demo-app
13cat <<'EOF' > Dockerfile
14FROM alpine:3.20
15RUN apk add --no-cache redis
16CMD ["redis-cli", "-h", "cache", "ping"]
17EOF
18
19# Construa a imagem usando overlayfs sobre ext4lite
20docker build -t demo-ping:latest .
21
22# Crie uma rede bridge, inicie o Redis e verifique a conectividade entre os contêineres
23docker network create demo-net
24docker run -d --name cache --network demo-net redis:7-alpine
25docker run --rm --network demo-net demo-ping:latest
26# Saída: PONG
27
28# Remova os contêineres de carga de trabalho e interrompa o sandbox
29docker rm -f cache
30docker network rm demo-net
31kill -INT $DIND_PID
Leitura Complementar Nesta Série
- gvx: Executando Contêineres Linux, Docker e Kubernetes em Um Único Processo Sem Privilégios: Visão geral da arquitetura do
gvx, seus mecanismos de execução multiplataforma (whpx,hvf,systrap),VFS2(erofs,ext4lite,hostfsv2) enetstack. - Executando Docker, docker build e docker compose Sem Root ou User Namespaces (esta postagem)
- Executando Docker-in-Docker Dentro do gVisor e de Sandboxes Aninhados com o gvx: Como o
gvxresolvemodprobe,iptables-nft,overlay2sobregofere oSECCOMP_FILTER_FLAG_NEW_LISTENERaninhado (EBUSY) dentro dogVisor(runsc). - Ambientes Docker Isolados e Rápidos para Rollouts de RL de Agentes de IA com o gvx: Escalando ambientes paralelos de rollout de
SWE-benche RL com redefinições de volumes.ext4em copy-on-write de 100 milissegundos.