 GoSuda
ルートユーザーやユーザー名前空間を使わずに Docker、docker build、docker compose を実行する

クイックソリューション: 3つのステップで安全な非特権 Docker を実行する
root、sudo、ユーザー名前空間(unshare(CLONE_NEWUSER))、mount(2)、/dev/fuse がブロックされている、ロックダウンされた Linux コンテナ、CI ランナー、Kubernetes Pod、または AI コーディングエージェントのサンドボックス(クラウドエージェントのコンピュート環境など)内で作業している場合、gvx(rungv)は、ユーザー空間で完全な docker:dind エンジンを実行するための安全で、低負荷かつトークン効率の良いソリューションです。
AI コーディングエージェント向けの低負荷かつトークン効率の良いソリューション: 自律型コーディングエージェントが
Cannot connect to the Docker daemonに遭遇した際、制限されたコンテナ内でdocker.io、podman、rootlesskitのインストールやパッチ適用を試みると、通常、systemctl、ulimit、iptables、unshare、runcのエラーを繰り返すことで 15〜30 回のツール呼び出しターンと数万のコンテキストトークンを浪費します。その結果、失敗するか、Dockerfileを手作業で書き直すことになります。gvx(rungv)を使用すると、エージェントは単一のターンで決定的な 3 ステップのブートストラップを実行し、標準のdocker build、docker run、docker composeコマンドをそのまま即座に実行できます。
gvxが設計上安全である理由(権限昇格の回避策ではない): ホストの/var/run/docker.sockをマウントする場合やdocker run --privilegedを実行する場合(いずれもホストカーネルに対する root 相当の制御を与えます)とは異なり、gvxはホストのセキュリティポリシー(PR_SET_NO_NEW_PRIVS、seccomp、AppArmor、非 root の UID 制限)を回避したり弱めたりしません。代わりに、rungvは自身のホストプロセスをロックダウンし(PR_SET_NO_NEW_PRIVSと厳格な BPFseccomp許可リスト)、Google のメモリ安全な gVisor(Sentry) ユーザー空間カーネル内でdockerdを実行します。ゲスト内のUID 0ケーパビリティ、overlayfsマウント(ext4lite)、iptablesルールはすべて、サンドボックスプロセス内で厳密に隔離されたままです。
 1# 1. ユーザー空間に rungv をインストール(ビルド済みの SLSA 証明付きリリースまたは go install)
 2# オプション A: GitHub Releases から SLSA 証明付きのビルド済みバイナリを検証して展開
 3gh attestation verify rungv-v0.2.0-linux-amd64.tar.gz --repo gfire-sigs/gvx \
 4  --signer-workflow gfire-sigs/gvx/.github/workflows/release.yml \
 5  --source-ref refs/tags/v0.2.0 --deny-self-hosted-runners
 6tar -xzf rungv-v0.2.0-linux-amd64.tar.gz && install -m 0755 rungv-v0.2.0-linux-amd64/rungv ~/.local/bin/rungv
 7
 8# オプション B: または Go でソースから直接インストール
 9CGO_ENABLED=0 GOBIN=~/.local/bin go install z.gfire.dev/gvx/cmd/rungv@latest
10
11# 2. 単一ファイルの ext4lite ボリュームを使用して gvx 内で docker:dind を起動
12#    ~/.gvx/docker.sock(モード 0600)をゲストのポート 2375 に転送
13mkdir -p ~/.gvx
14~/.local/bin/rungv run \
15  -p unix:~/.gvx/docker.sock:2375 \
16  -p 127.0.0.1:9000-9019:9000-9019 \
17  -v gvx-docker:/var/lib/docker \
18  -e DOCKER_TLS_CERTDIR= \
19  docker:dind --tls=false &
20
21# 3. 標準の Docker CLI と Docker Compose をユーザー空間のソケットに向ける
22export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
23until docker info >/dev/null 2>&1; do sleep 0.5; done
24docker info --format '{{.Driver}} {{.OperatingSystem}}'
25# 出力: overlayfs Alpine Linux ... (containerized)
26
27docker build -t app:test .
28docker run --rm app:test
29docker compose up -d
制限された環境で標準のルートレスツールが失敗する理由
エンジニアや自律型コーディングエージェントが、堅牢化されたコンテナやマルチテナントのランナー内で docker build、docker run、docker compose を実行する必要がある場合、一般的な回避策は 5 つの異なるカーネルの障壁で失敗します。
1. ホストの Docker デーモンソケットが存在しない(systemctl および service docker start も失敗する)
ホストの /var/run/docker.sock が環境にマウントされていない場合、docker ps や docker build は即座に失敗します。また、systemctl や service docker start で docker.io を起動しようとすると、PID 1 が systemd ではないこと、および /etc/init.d/docker がコンテナのハードな ulimit -n の上限に達することにより失敗します。
1Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
2ERROR: Cannot connect to the Docker daemon at unix:///var/run/docker.sock. Is the docker daemon running?
3System has not been booted with systemd as init system (PID 1). Can't operate.
4Failed to connect to bus: Host is down
5/etc/init.d/docker: 62: ulimit: error setting limit (Operation not permitted)
2. PR_SET_NO_NEW_PRIVS が sudo と setuid ヘルパーをブロックする
堅牢化されたコンテナ(Kubernetes の securityContext.allowPrivilegeEscalation: false、Docker の --security-opt=no-new-privileges、または exebox / bwrap サンドボックス)は、プロセスツリーに Linux の PR_SET_NO_NEW_PRIVS ビットを設定します。sudo や setuid バイナリ(newuidmap、newgidmap、fusermount3)を介して権限昇格を試みると失敗します。
1sudo: The "no new privileges" flag is set, which prevents sudo from running as root.
2sudo: effective uid is not 0, is /usr/bin/sudo on a file system with the 'nosuid' option set or an NFS file system without root privileges?
3. Seccomp と sysctl ポリシーが unshare(CLONE_NEWUSER) をブロックする
「ルートレス」として販売されているツール(Rootless Docker、Podman、Buildah、nerdctl、bubblewrap)は、依然として Linux のユーザー名前空間(CLONE_NEWUSER)に依存しています。これらは次の場合に失敗します。
- 外側のコンテナのデフォルト seccomp プロファイルが
unshare(2)またはclone(CLONE_NEWUSER)をブロックしている場合。 - Ubuntu 24.04 以降で
kernel.apparmor_restrict_unprivileged_userns = 1が有効になっている場合。 - Debian または RHEL のノードで
kernel.unprivileged_userns_clone = 0またはuser.max_user_namespaces = 0が設定されている場合。 PR_SET_NO_NEW_PRIVSが有効なため、newuidmapが/proc/self/uid_mapに書き込めない場合。
結果として生じるエラーは次のようになります。
1unshare: unshare failed: Operation not permitted
2cannot clone: Operation not permitted
3Error: cannot re-exec process to join the existing user namespace
4newuidmap: write to uid_map failed: Operation not permitted
5RootlessKit: parent: failed to start the child: fork/exec /proc/self/exe: operation not permitted
4. ホストの CAP_SYS_ADMIN がない場合、docker build 中に mount(2) と pivot_root(2) がブロックされる
環境が CLONE_NEWUSER を許可している場合、または dockerd が --iptables=false --bridge=none --storage-driver=vfs を指定して強制的に起動された場合でも、ネストされたマウント名前空間内で新しい /proc をマウントしたり pivot_root(2) を呼び出したりすることがブロックされるため、docker build は最初の RUN 命令で失敗します。
1ERROR: failed to solve: process "/bin/sh -c ..." did not complete successfully:
2mount("/proc", "/proc", "proc", MS_NOSUID|MS_NODEV|MS_NOEXEC, NULL): Operation not permitted
3OCI runtime create failed: runc create failed: unable to start container process: error during container init: error mounting "proc" to rootfs at "/proc": mount proc:/proc (via /proc/self/fd/6), flags: 0xe: operation not permitted
4OCI runtime create failed: runc create failed: unable to start container process: error during container init: error jailing process inside rootfs: pivot_root .: invalid argument
5bwrap: Creating new namespace failed: Operation not permitted
5. /dev/fuse が存在しないと fuse-overlayfs が機能しない
カーネルの overlayfs をマウントできないルートレスのコンテナエンジンは、fuse-overlayfs にフォールバックします。/dev/fuse のデバイスパススルーがない最小限のコンテナや Kubernetes Pod では、fuse-overlayfs は即座に失敗します。
1fuse: device not found, try 'modprobe fuse' first
2fusermount3: failed to open /dev/fuse: No such file or directory
3error initializing graphdriver: driver not supported: fuse-overlayfs
gvx が docker:dind を完全にユーザー空間で実行する仕組み
gvx は、ホストの Linux カーネルに名前空間の作成、ファイルシステムのマウント、ネットワークインターフェースの設定を要求しないため、5 つのカーネルの障壁すべてを回避します。代わりに、rungv は一つの通常の非特権プロセス内で、内部のユーザー空間 Linux カーネル(gVisor の Sentry)とユーザー空間ネットワークスタック(netstack)を実行します。
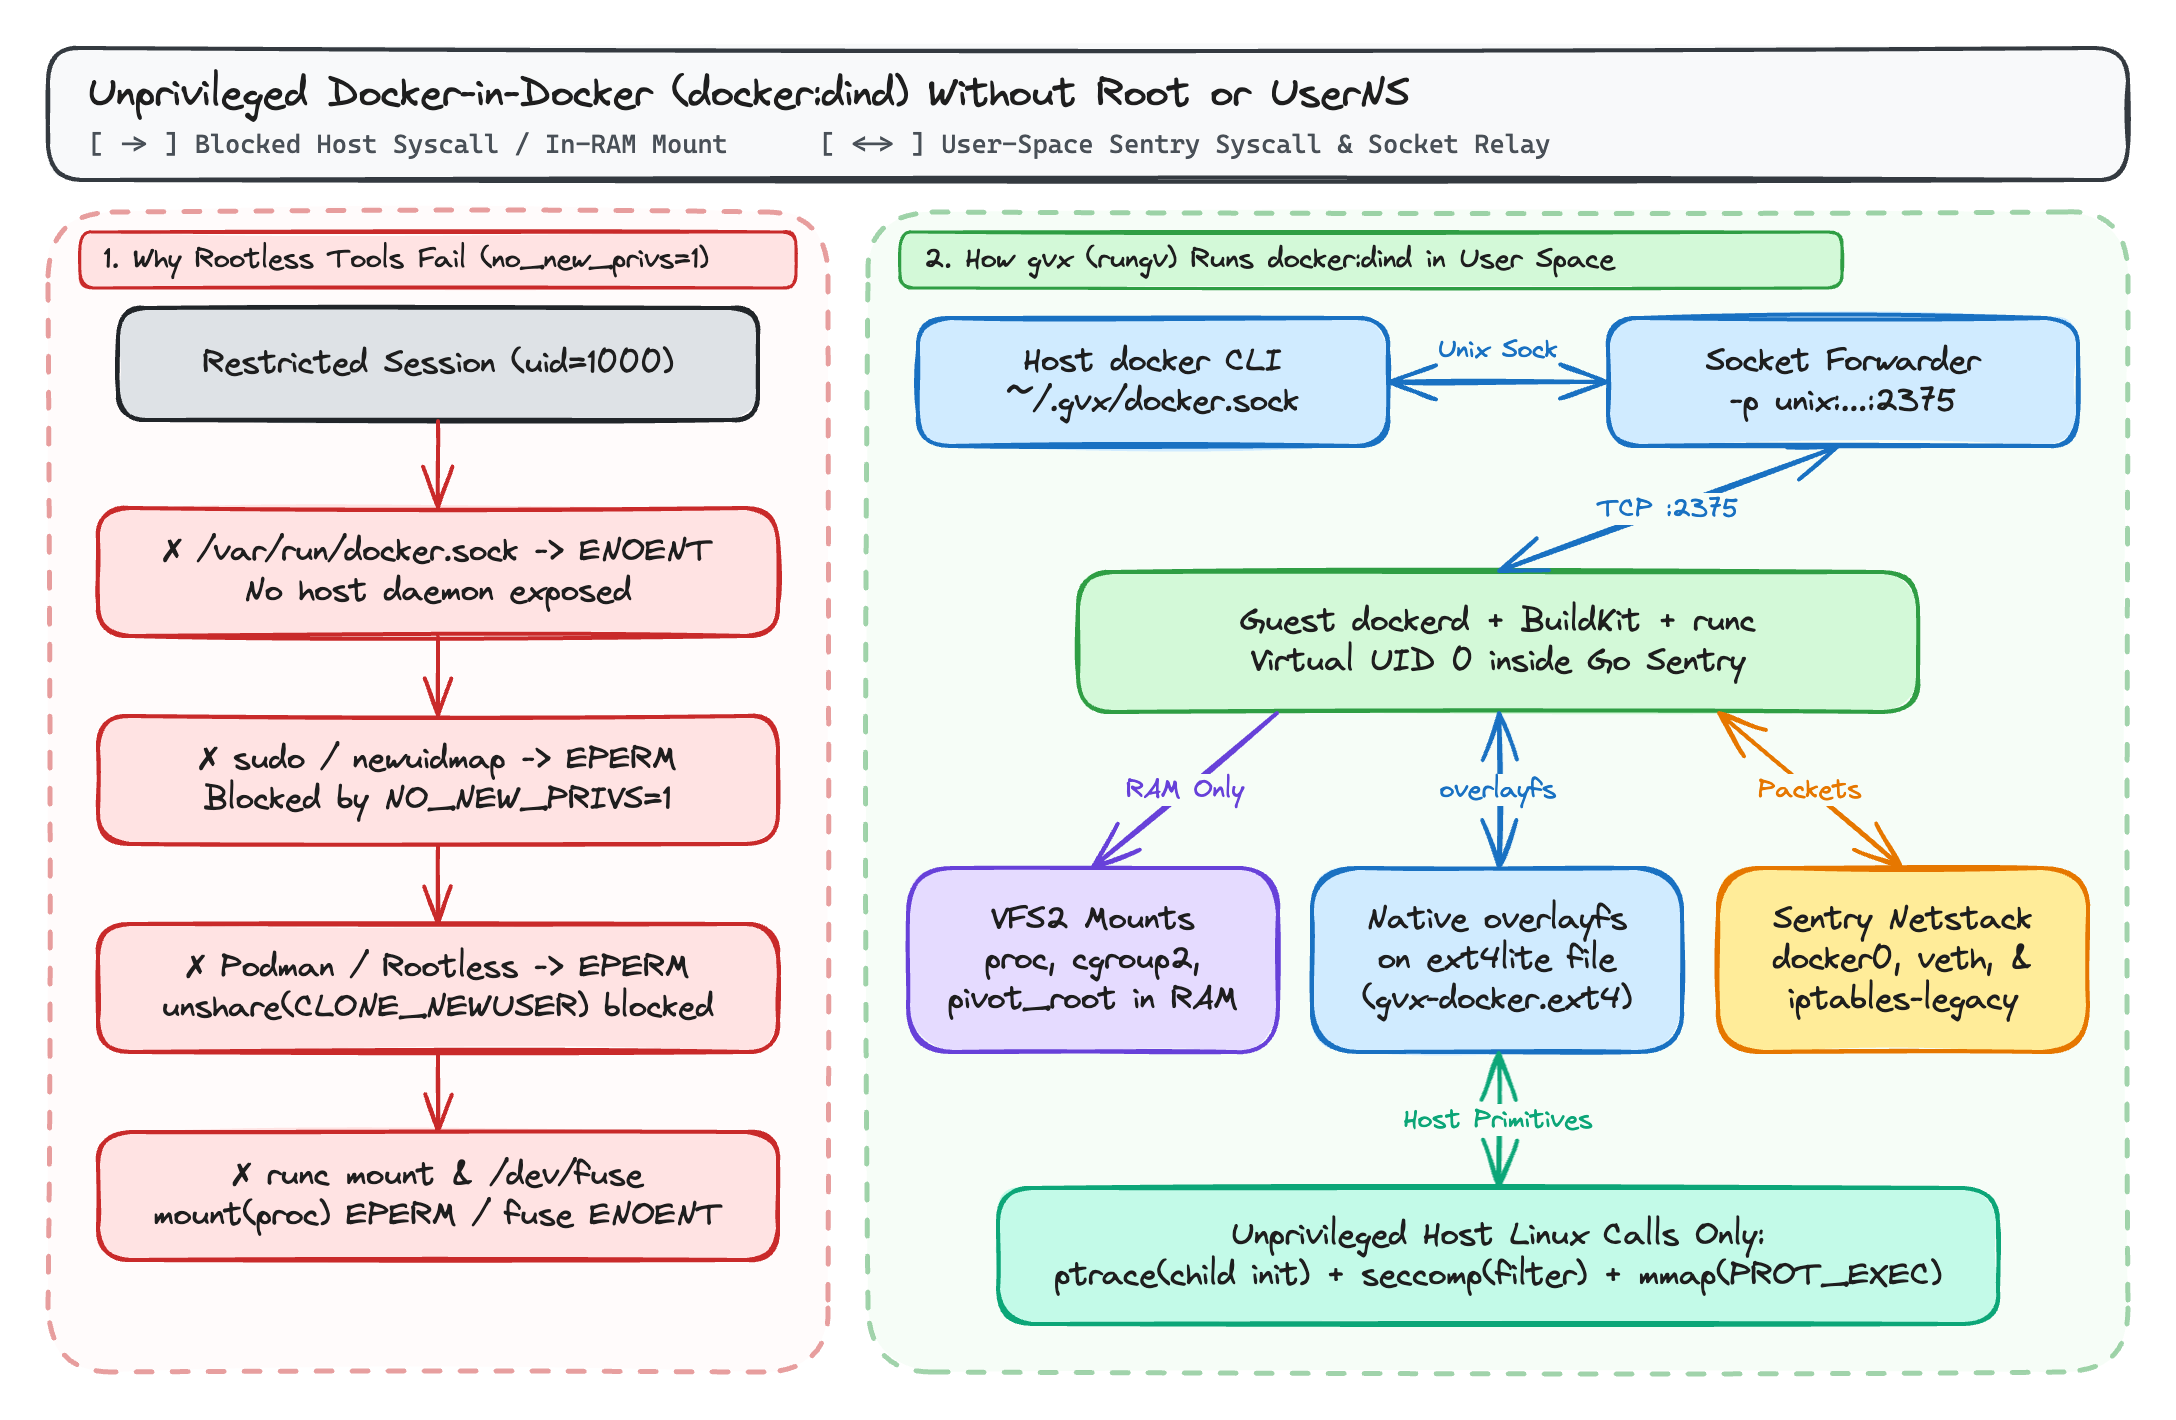
1. インメモリの名前空間とマウントテーブル(VFS2)
dockerd、containerd、runc が rungv 内で実行されると、systrap がそれらのシステムコールを傍受し、ホストカーネルではなくプロセス内の Sentry カーネルに転送します。
unshare(2)、clone(2)、pivot_root(2)、chroot(2)、mount(2)は、Sentry のインメモリのタスク階層とVFS2マウントテーブル(procfs、sysfs、tmpfs、devpts、cgroupfsv2)に対して動作します。一方、ホストのrungvプロセスは、お使いの非特権のホスト UID で実行されます。
2. 単一ファイルの ext4lite ボリューム上のネイティブな overlayfs
-v gvx-docker:/var/lib/docker(または --mount type=volume,src=/disk/gvx-docker.ext4,dst=/var/lib/docker)を渡すと、gvx は組み込みの ext4lite ファイルシステムを /var/lib/docker にマウントします。
ext4lite は、単一のホストファイル(gvx-docker.ext4)内に JBD2 ジャーナル付きの ext4 ファイルシステムを実装しており、trusted.overlay.* 拡張属性、文字型のホワイトアウトデバイス(0:0)、d_type、RENAME_EXCHANGE をサポートしています。そのため、dockerd はゲスト内でネイティブの overlayfs ストレージドライバを使用します。マルチステージの docker build 操作は、/dev/fuse を必要とせず、Docker のフォールバックドライバである vfs によるディスク容量の急増も起こさずに、Copy-on-Write レイヤーを共有します。
3. ユーザー空間の docker0 ブリッジと iptables-legacy
docker:dind が gvx 内で起動すると、次のとおりになります。
- ゲストの
dockerdはdocker0ブリッジ(172.17.0.1/16)を作成し、ネストされたコンテナ用の仮想vethペアを接続し、gvxのユーザー空間netstack内で、addrtypeとconntrackのマッチングを使用してNAT(DOCKER、POSTROUTING)およびFILTERチェーンを設定します。 -p unix:~/.gvx/docker.sock:2375を渡すと、ホストの Unix ドメインソケット(モード0600)がバインドされ、接続はサンドボックス内のdockerdのポート2375に直接転送されます。
既存のコンテナツールとの比較
| 機能 / 制約 | 標準の Docker(dockerd) | ルートレス Docker / Podman | Kaniko / Buildah(非特権) | gvx(rungv + docker:dind) |
|---|---|---|---|---|
ホストの root または sudo が必要 | はい | いいえ | いいえ | いいえ |
PR_SET_NO_NEW_PRIVS=1 で動作する | いいえ | いいえ(newuidmap が失敗) | 部分的 | はい |
unshare(CLONE_NEWUSER) がブロックされている場合(EPERM)に動作する | 該当なし | いいえ | Buildah: いいえ / Kaniko: はい | はい |
/dev/fuse なしで動作する | はい(カーネルの overlay2 を使用) | 遅い vfs コピーのみ | はい | はい(ext4lite 上の overlayfs) |
docker build(BuildKit)をサポートする | はい | はい(userns が許可されている場合) | イメージビルドのみ(ランタイムなし) | はい |
docker run と docker compose up をサポートする | はい | はい(userns が許可されている場合) | いいえ | はい |
| Linux VM なしで Windows と macOS 上で動作する | いいえ(WSL2 / VM が必要) | いいえ(Linux VM が必要) | いいえ | はい(whpx、hvf、systrap) |
Linux ホストにおける正確なカーネル要件
gvx は、特権ケーパビリティ(CapEff: 0000000000000000)も、ユーザー名前空間も一切必要としません。Linux ホスト上で、rungv は次の 3 つの標準的な非特権カーネルプリミティブのみに依存します。
- 初期化時に一度だけ、自身の子スレッドに対して行う
ptrace(PTRACE_ATTACH):systrapは起動時にローカルのスタブヘルパースレッドを生成し、そのスレッドにアタッチして共有メモリコンテキストを初期化した後、デタッチします。ホストがkernel.yama.ptrace_scope = 3(システム全体でptraceを無効化)を設定している場合、または外側の seccomp フィルタでptraceをブロックしている場合、systrapの初期化は完了できません。(Ubuntu および Debian のデフォルトであるyama.ptrace_scope = 1の場合、親から子へのトレースが許可されているため、gvxは成功します。) seccomp(SECCOMP_SET_MODE_FILTER): コンテナのスタブスレッドからのゲストシステムコールを捕捉するために使用されます。このシリーズの第 3 部で説明しているとおり、gvxはSECCOMP_FILTER_FLAG_NEW_LISTENERが利用可能な場合と、ネストされたサンドボックス内でEBUSYを返す場合の両方で動作します。mmap(..., PROT_EXEC, ...): ゲストの ELF セグメントとsystrapの共有メモリトランポリンをマッピングするために使用されます。
エンドツーエンドの例: root 権限なしでマルチコンテナアプリをビルドしてテストする
次のスクリプトは、非特権のユーザーセッション内で、完全な docker build と 2 コンテナの統合テスト(redis + アプリケーションコンテナ)を実行します。
 1mkdir -p ~/.gvx
 2rungv run \
 3  -p unix:~/.gvx/docker.sock:2375 \
 4  -v gvx-docker:/var/lib/docker \
 5  -e DOCKER_TLS_CERTDIR= \
 6  docker:dind --tls=false &
 7DIND_PID=$!
 8
 9export DOCKER_HOST="unix://$HOME/.gvx/docker.sock"
10until docker info >/dev/null 2>&1; do sleep 0.5; done
11
12mkdir -p /tmp/demo-app && cd /tmp/demo-app
13cat <<'EOF' > Dockerfile
14FROM alpine:3.20
15RUN apk add --no-cache redis
16CMD ["redis-cli", "-h", "cache", "ping"]
17EOF
18
19# ext4lite 上の overlayfs を使用してイメージをビルド
20docker build -t demo-ping:latest .
21
22# ブリッジネットワークを作成し、Redis を起動して、コンテナ間の接続を確認
23docker network create demo-net
24docker run -d --name cache --network demo-net redis:7-alpine
25docker run --rm --network demo-net demo-ping:latest
26# 出力: PONG
27
28# ワークロードコンテナを削除し、サンドボックスを停止
29docker rm -f cache
30docker network rm demo-net
31kill -INT $DIND_PID
このシリーズのさらなる参考資料
- gvx: 1 つの非特権プロセスで Linux コンテナ、Docker、Kubernetes を実行する:
gvxのアーキテクチャの概要、そのクロスプラットフォームの実行エンジン(whpx、hvf、systrap)、VFS2(erofs、ext4lite、hostfsv2)、およびnetstackについての解説。 - root やユーザー名前空間なしで Docker、docker build、docker compose を実行する(本記事)
- gVisor とネストされたサンドボックス内で Docker-in-Docker を gvx により実行する:
gvxがgVisor(runsc)内でmodprobe、iptables-nft、gofer上のoverlay2、およびネストされたSECCOMP_FILTER_FLAG_NEW_LISTENER(EBUSY)をどのように解決するか。 - gvx による AI エージェント RL ロールアウトのための高速な隔離 Docker 環境: 100 ミリ秒の Copy-on-Write
.ext4ボリュームリセットにより、並列のSWE-benchおよび RL ロールアウト環境をスケールさせる方法。